Wissenssuche mit Retrieval und überprüfbaren Fundstellen
Passende Absätze finden und ihren Zugriff, Stand und wörtlichen Inhalt überprüfbar erhalten.
Eine Wissensantwort beginnt mit einer überprüfbaren Fundstelle
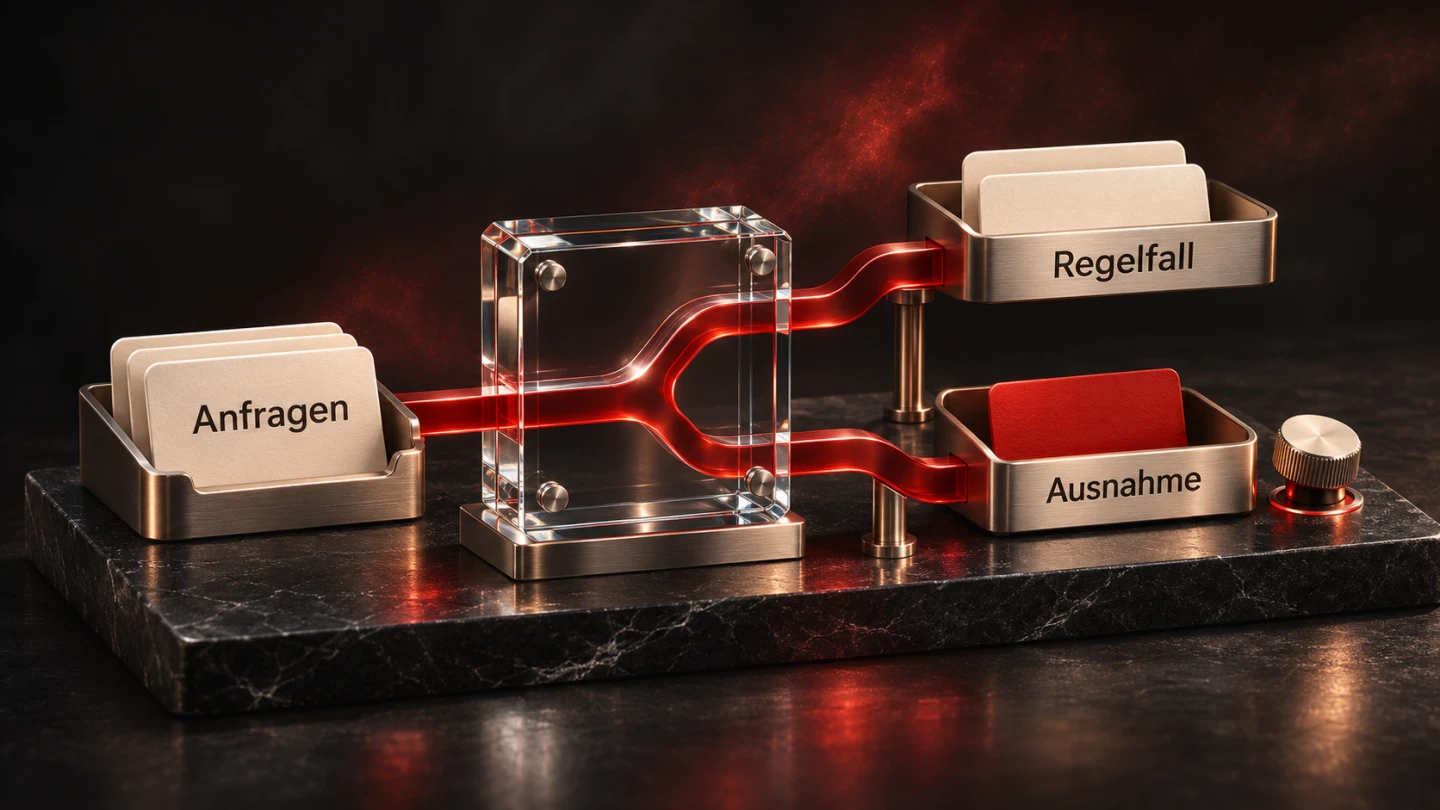
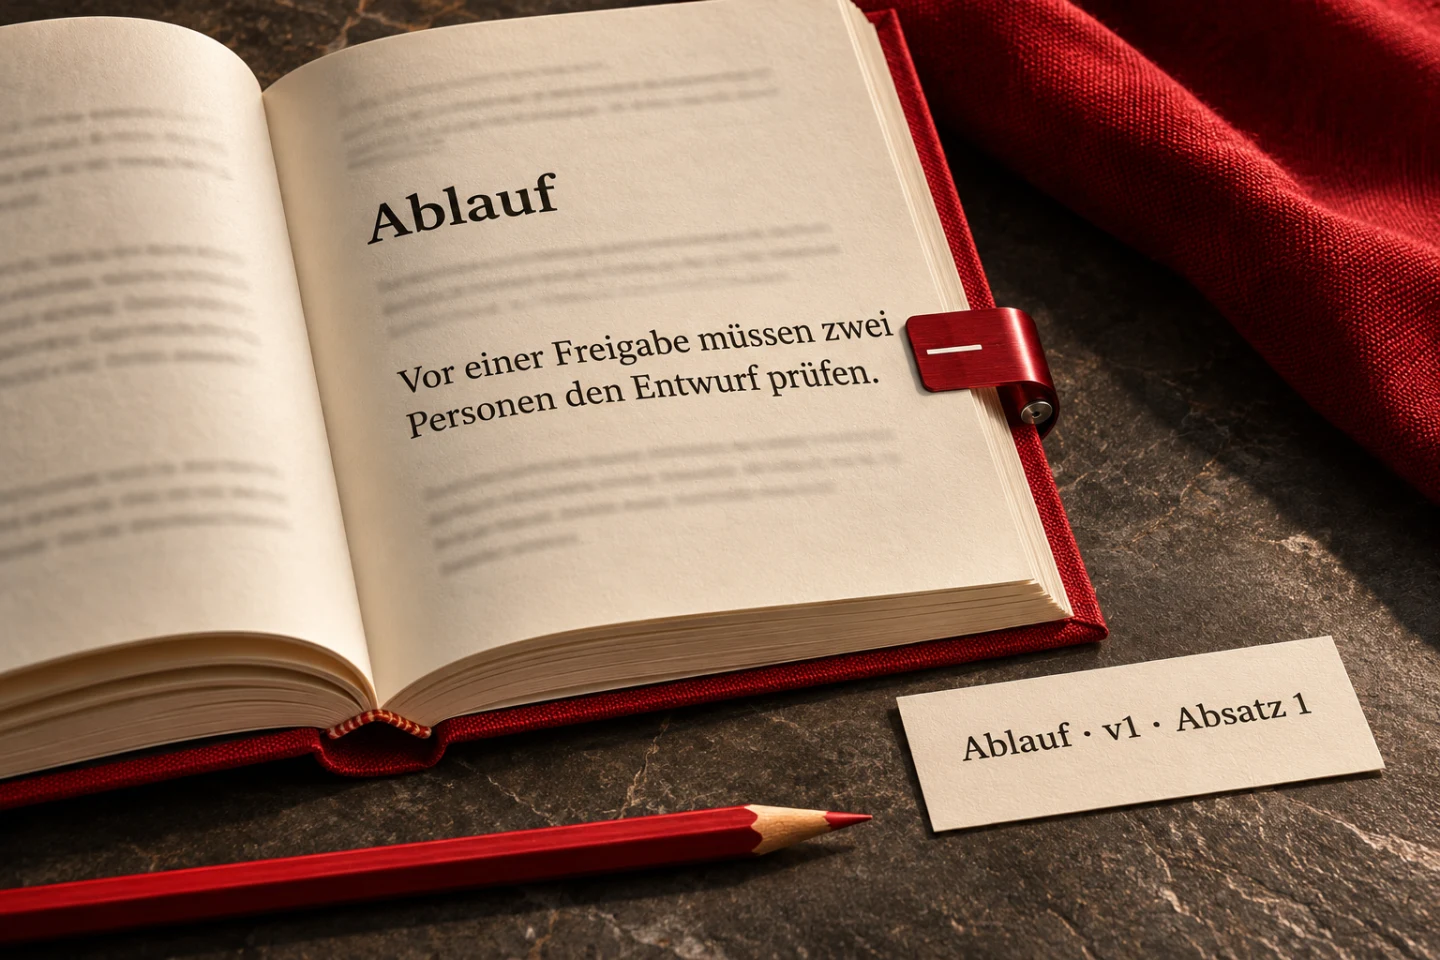
Retrieval bedeutet, passende Inhalte aus einem vorhandenen Bestand zu suchen und für eine weitere Aufgabe bereitzustellen. Für eine verlässliche Wissenssuche reicht eine überzeugend formulierte Antwort nicht aus. Die zugrunde liegende Stelle muss auffindbar sein. Wer eine Aussage prüfen möchte, braucht das konkrete Dokument, seinen Stand und den betreffenden Absatz statt einer bloßen Liste ungefähr passender Dateinamen.
Unser eigenes Beispiel verwendet fünf ausdrücklich fiktive Dokumente und einen tatsächlich ausgeführten Python-Baustein mit SQLite FTS5. Er sucht nach Wörtern, liefert wörtliche Absätze und kann die zurückgegebenen Fundstellen erneut prüfen. Es gibt keinen Modellaufruf und keine automatisch verfasste Antwort. Untersucht wird die vorgelagerte Wissenssuche, auf der eine spätere Antwort überhaupt erst nachvollziehbar aufbauen könnte.
Dabei gelten zwei wichtige Grenzen. Erstens dürfen nur Inhalte in die Suche gelangen, auf die der aktuelle Kontext zugreifen darf. Zweitens macht eine gefundene Textstelle ihren Inhalt nicht automatisch wahr oder verbindlich. Eine Notiz kann veraltet sein oder fremde Anweisungen enthalten. Der Suchbaustein behandelt Fundstellen als Daten und verleiht ihnen weder zusätzliche Berechtigungen noch die Befugnis, andere Regeln zu ersetzen.
Retrieval und Antworterzeugung getrennt betrachten
Bei einer Kombination mit einem Sprachmodell können gefundene Inhalte als zusätzlicher Kontext für eine Antwort dienen. Das bekannte RAG-Papier von Lewis und weiteren Autoren beschreibt eine solche Verbindung von Abruf und Generierung. Unser Beispiel bildet diesen Forschungsaufbau nicht nach. Es zeigt eine bewusst kleine lexikalische Suchstufe, deren Quellenbezug unabhängig von der späteren sprachlichen Formulierung geprüft werden kann.
Diese Trennung erleichtert die Fehleranalyse. Wenn die passende Stelle gar nicht gefunden wurde, hilft die Überarbeitung eines Antwortprompts nur begrenzt. Wenn die richtige Stelle vorliegt, aber falsch interpretiert wird, liegt ein anderes Problem vor. Und wenn ein Zitat auf einen inzwischen geänderten Text verweist, muss zunächst der Quellenstand geklärt werden. Eine allgemeine Bewertung wie KI falsch verdeckt diese unterschiedlichen Ursachen.
Ein vollständig entwickeltes Produkt sollte die Stufen deshalb beobachtbar halten. Welche Anfrage wurde gesucht, welche berechtigten Quellen waren verfügbar und welche Stellen gingen in die weitere Verarbeitung? Diese Zuordnung muss mit passender Datenminimierung geschehen. Sie bedeutet nicht, dass sämtliche vertraulichen Suchanfragen und Dokumente ungefragt in ein allgemeines Protokoll kopiert werden sollten. Die konkrete Betriebsaufzeichnung ist eine eigene Aufgabe.
Lewis et al.: Retrieval-Augmented Generation
Den Bestand und seine Zuständigkeit zuerst ordnen
Jedes fiktive Dokument besitzt eine eindeutige Kennung, eine Bereichszuordnung, erlaubte Gruppen, eine Version und seinen Text. Die Version beschreibt den redaktionellen Stand. Ein zusätzlicher Fingerabdruck wird aus dem vollständigen Text erzeugt. Die Kombination ermöglicht es, einen Absatz später einem bestimmten Inhalt zuzuordnen. Ein bloßer Titel wäre dafür zu schwach, weil verschiedene Stände denselben Titel tragen können.
Der betrachtete Benutzerkontext enthält ebenfalls Bereich und Gruppen. Er wird als vertrauenswürdiger Serverkontext übergeben. Die gezeigte Funktion implementiert keine Anmeldung und nimmt diesen Kontext nicht aus ungeprüftem Anfrage-JSON entgegen. Eine reale Anwendung muss die Zuordnung aus ihrer maßgeblichen Identitätsverwaltung beziehen. Das Auswählen einer Gruppe in einem beliebigen Eingabefeld wäre keine belastbare Berechtigungsprüfung.
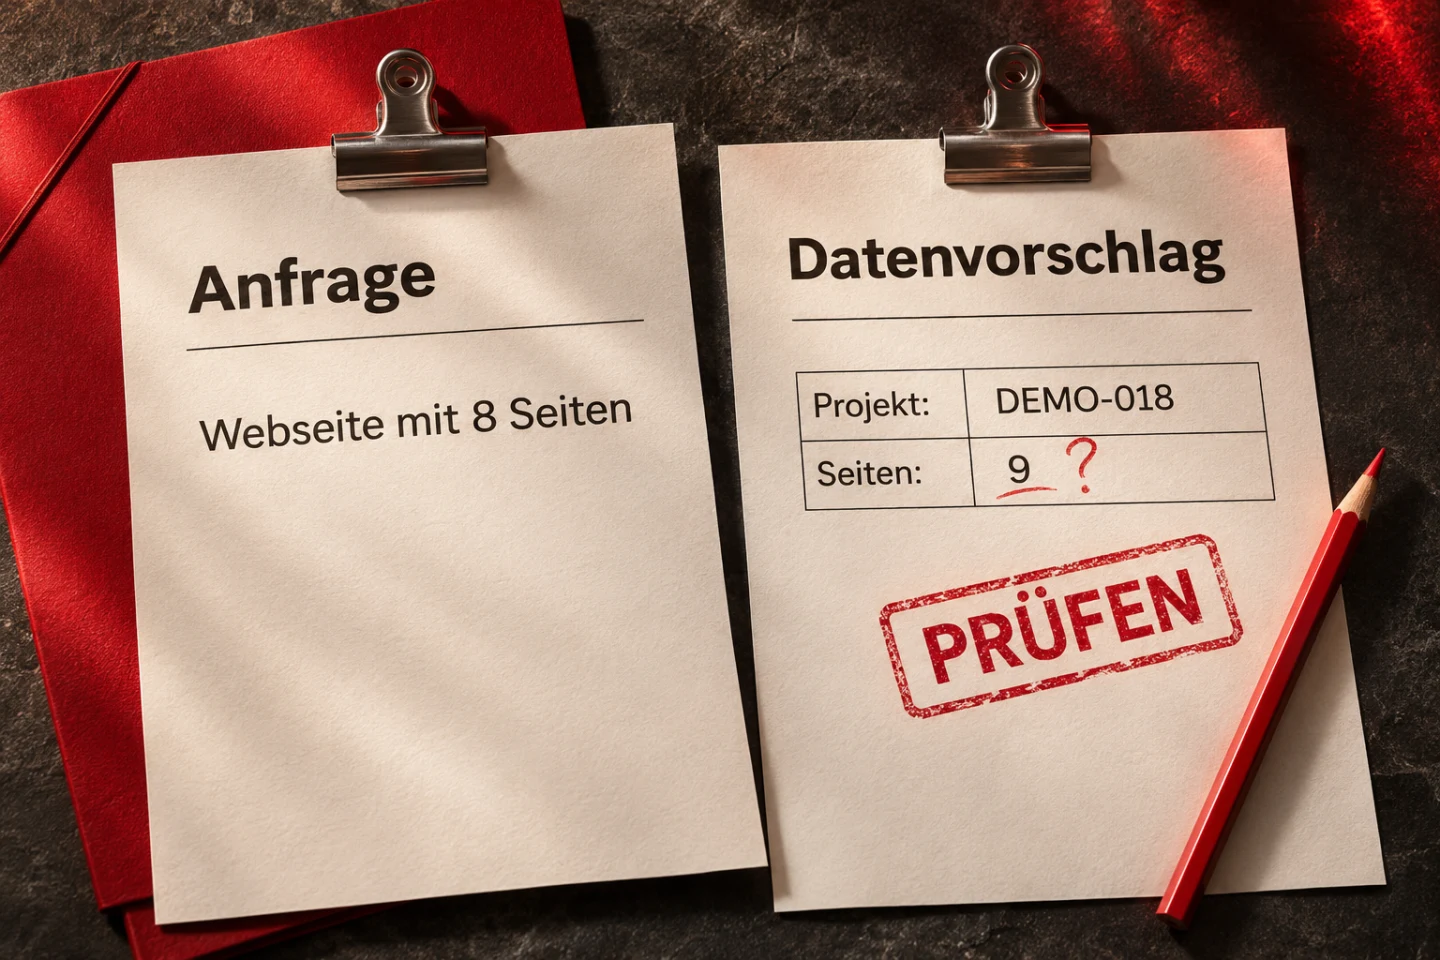
Doppelte Dokumentkennungen werden im Beispiel zurückgewiesen. Ohne diese Regel könnte ein späteres Nachschlagen derselben Kennung ein anderes Dokument liefern als die Suche. Auch die Bedeutung des Versionsfelds muss im eigenen Bestand klar sein. Der Fingerabdruck hilft zusätzlich, wenn jemand den Inhalt ändert, ohne die Version zu erhöhen. Genau dieser Randfall wird mit einer tatsächlich veränderten Quelle geprüft.
Berechtigung vor Index und Bewertung anwenden
Der Baustein wählt zunächst nur Dokumente aus dem passenden Bereich mit mindestens einer gemeinsam erlaubten Gruppe. Ein inaktiver Kontext erhält keine Ergebnisse. Erst die so berechtigten Texte werden in den kleinen Suchindex eingefügt. Damit werden nicht nur unerlaubte Ergebniszeilen nachträglich ausgeblendet. Auch die Bewertungsgrundlage des Versuchs enthält ausschließlich die vorher freigegebenen Inhalte.
Dieser Unterschied ist wichtig, weil ein gemeinsamer Suchindex weitere Informationen in seiner Bewertung berücksichtigen kann. Für unseren kleinen Nachweis wird der Index deshalb pro Aufruf im Arbeitsspeicher aus dem erlaubten Ausschnitt erzeugt. Eine zusätzliche sehr lange unberechtigte Quelle verändert weder Treffer noch Bewertungswerte. Der tatsächliche Vergleich dieses Falls gehört zum Prüfbestand und macht die gewählte Grenze konkret.
Dieser einfache Aufbau ist kein Skalierungsentwurf für eine große Organisation. Ein produktiver Suchdienst kann andere passende Index- und Berechtigungskonzepte benötigen. Entscheidend ist die nachgewiesene Grenze vor Abruf und Weitergabe. Sie darf nicht erst durch eine Bitte an das Sprachmodell entstehen, unerlaubte Inhalte möglichst nicht zu erwähnen. Was eine weitere Verarbeitung nicht sehen darf, sollte ihr gar nicht als Kontext zugestellt werden.
Absätze mit ihrem Originalstand verbinden
Der Beispieltext wird an ausdrücklich vereinbarten leeren Zeilen in Absätze geteilt. Die Absatznummer bezieht sich auf diese Teilung im vollständigen Originaltext. Ein Ergebnis enthält die Nummer, den wörtlichen Text, Dokumentkennung, Version und Fingerabdruck. Dadurch lässt sich die Fundstelle erneut auflösen. Auch leere Zwischenabschnitte ändern ihre ursprüngliche Position nicht unbemerkt, weil die Zählung an der vollständigen Aufteilung hängt.
Diese kleine Absatzregel ist bewusst einfach. Für reale PDF-Dateien, Tabellen oder redaktionelle HTML-Inhalte sind andere Einheiten nötig. Ein Tabellenwert braucht beispielsweise häufig seine Überschrift und Zeilenbedeutung. Ein isolierter Satz kann einen unmittelbar vorher erklärten Geltungsbereich verlieren. Die passende Zerlegung richtet sich nach dem tatsächlichen Material und muss darauf geprüft werden, ob sie die Bedeutung noch verständlich erhält.
Sehr große Abschnitte können eine spätere Kontextgrenze überlasten. Sehr kleine Abschnitte können wichtige Einschränkungen abtrennen. Eine starre Zahl allein löst dieses Problem nicht. Im eigenen Bestand werden deshalb typische Quellen und Fragen gemeinsam betrachtet. Der vorliegende Versuch verwendet kurze überschaubare Absätze, damit Zuordnung und Gegenprüfungen vollständig nachvollziehbar bleiben. Er behauptet keine allgemein optimale Abschnittsgröße für alle Dokumenttypen.
Die Suchbedeutung bewusst begrenzen
Unser Suchfeld verarbeitet höchstens 200 Zeichen und zwölf unterschiedliche Wörter. Die Eingabe wird in NFC normalisiert und kleingeschrieben. Steuerzeichen und zu lange Wörter werden zurückgewiesen. Die Wörter müssen gemeinsam in einem Absatz vorkommen. Es gibt keine automatische Rechtschreibkorrektur, keine Frageinterpretation und keine Bedeutungsähnlichkeit durch Vektoren. Das Suchbeispiel zwei Personen ist deshalb eine konkrete Stichwortanfrage und keine behauptete natürliche Sprachverständigung.
Die SQLite-Abfrage erhält die Suchwerte als gebundene Parameter. Zusätzlich werden die Wörter als wörtliche Suchbestandteile aufgebaut. Ein eingegebenes OR wird dadurch nicht zum frei ausführbaren Suchoperator. Ein Sternchen erzeugt keine vom Nutzer gesteuerte Präfixsuche. Welche Satzzeichen bei der Wortbildung verschwinden, ist im Code sichtbar. Die Tests prüfen diese Bedeutung ausdrücklich statt aus einer erfolgreichen Standardanfrage auf alle Eingaben zu schließen.
Für deutsche Wörter wird kein automatischer Wortstamm erzeugt. Auch die fehlenden Umlautpunkte werden nicht beiläufig als dasselbe Wort behandelt. Diese Begrenzung kann in einem echten Produkt unzureichend sein, ist aber ehrlich benannt und prüfbar. Eine spätere semantische Suche benötigt eigene Qualitätsfälle und muss denselben Quellen- und Berechtigungsvertrag erhalten. Mehr sprachliche Flexibilität darf nicht die Nachvollziehbarkeit der Fundstellen aufheben.
Bewertung als Reihenfolge und nicht als Wahrheitsgrad lesen
FTS5 liefert im Beispiel eine BM25-Bewertung für passende Absätze. Der Code sortiert nach dieser Bewertung und ergänzt Dokumentkennung und Absatznummer als eindeutige Gleichstandsregel. Die Werte sind technische Größen für die Reihenfolge dieses Suchlaufs. Sie werden nicht in eine Prozentangabe für Wahrheit oder Verlässlichkeit umgedeutet. Ein höher platziertes Ergebnis kann weiterhin inhaltlich falsch oder für die konkrete Aufgabe ungeeignet sein.
Die Bewertung hängt vom tatsächlich indizierten Bestand ab. Deshalb gehören Vergleichsmessungen zu einem definierten Datenstand und einer definierten Anfrage. Ein beliebiger Zahlenwert aus einem anderen Bestand ist kein direkt vergleichbarer Vertrauensmaßstab. Unser Nachweis zeigt die echten Werte im Ergebnisobjekt, verwendet sie aber nicht als fachliche Freigabe. Der Zweck bleibt die begrenzte Auswahl von Stellen, die anschließend gelesen werden können.
Die maximale Trefferzahl ist im Beispiel ausdrücklich begrenzt. Das verhindert nicht, dass eine richtige Stelle im Ergebnis fehlt. Für eine reale Anwendung werden bekannte Fragen mit erwarteten maßgeblichen Fundstellen benötigt. Dann kann untersucht werden, ob die Suche diese Stellen erreicht und welche unpassenden Inhalte daneben auftauchen. Eine schön formatierte einzelne Antwort wäre für diese Qualitätsfrage kein ausreichender Nachweis.
Den vollständigen Such- und Auflösungsbaustein zeigen
Der folgende Python-Code bildet die beschriebenen Schritte vollständig ab: Register prüfen, Anfrage lesen, Zugriff filtern, berechtigte Absätze indizieren, suchen und Fundstellen ausgeben. Eine zweite Funktion löst die Fundstelle erneut gegen den aktuellen zugänglichen Bestand auf. Sie prüft sowohl Version als auch den Fingerabdruck und den tatsächlichen Absatztext. Eine alte Kennung allein reicht nicht aus.
Die erneute Auflösung berücksichtigt außerdem den aktuellen Zugriff. Wird eine Gruppe entzogen oder ein Dokument entfernt, kann die alte Fundstelle nicht einfach weiter als verfügbare Quelle behandelt werden. Der Versuch prüft diese Veränderungen ausdrücklich. Eine echte Oberfläche muss für den nicht mehr verfügbaren Fall eine passende Rückmeldung anbieten. Sie darf einen früher angezeigten Quellenverweis nicht mit einer unbelegten aktuellen Verfügbarkeit verwechseln.
import hashlib
import re
import sqlite3
import unicodedata
from dataclasses import dataclass

@dataclass(frozen=True)
class Actor:
    tenant: str
    groups: frozenset[str]
    active: bool = True

@dataclass(frozen=True)
class Document:
    id: str
    tenant: str
    groups: frozenset[str]
    version: str
    text: str

def accessible(actor, doc):
    # Actor and registry are trusted server context, not request JSON.
    return actor.active and actor.tenant == doc.tenant and bool(actor.groups & doc.groups)

def fingerprint(doc):
    return hashlib.sha256(doc.text.encode("utf-8")).hexdigest()

def check_registry(documents):
    if len({doc.id for doc in documents}) != len(documents):
        raise ValueError("Dokumentkennungen müssen eindeutig sein.")

def query_terms(query):
    if not isinstance(query, str) or len(query) > 200:
        raise ValueError("Ungültige Suchanfrage.")
    if any(ord(c) < 32 or ord(c) == 127 for c in query):
        raise ValueError("Steuerzeichen sind nicht erlaubt.")
    normal = unicodedata.normalize("NFC", query).lower()
    words = list(dict.fromkeys(re.findall(r"[^\W_]+", normal, re.UNICODE)))
    if len(words) > 12 or any(len(word) > 40 for word in words):
        raise ValueError("Zu viele oder zu lange Suchwörter.")
    return words

def retrieve(actor, query, documents, limit=3):
    if type(limit) is not int or not 1 <= limit <= 5:
        raise ValueError("Ungültige Treffergrenze.")
    check_registry(documents)
    words = query_terms(query)
    if not words or not actor.active:
        return []
    # Access filtering happens before indexing and BM25 statistics.
    allowed = [doc for doc in documents if accessible(actor, doc)]
    by_id = {doc.id: doc for doc in allowed}
    con = sqlite3.connect(":memory:")
    try:
        con.row_factory = sqlite3.Row
        con.execute("CREATE VIRTUAL TABLE fragments USING fts5(doc_id UNINDEXED, paragraph UNINDEXED, quote, tokenize='unicode61 remove_diacritics 0')")
        for doc in allowed:
            for number, text in enumerate(doc.text.split("\n\n"), 1):
                if text.strip():
                    con.execute("INSERT INTO fragments(doc_id,paragraph,quote) VALUES(?,?,?)", (doc.id, number, text))
        # Tokens contain letters/numbers only; operators stay literal words.
        expression = " AND ".join('"' + word + '"' for word in words)
        rows = con.execute("SELECT doc_id,paragraph,quote,bm25(fragments) AS score FROM fragments WHERE fragments MATCH ? ORDER BY score,doc_id,CAST(paragraph AS INTEGER) LIMIT ?", (expression, limit)).fetchall()
        return [{"document_id": row["doc_id"], "version": by_id[row["doc_id"]].version,
                 "content_sha256": fingerprint(by_id[row["doc_id"]]),
                 "paragraph": int(row["paragraph"]), "quote": row["quote"], "score": row["score"]}
                for row in rows]
    finally:
        con.close()

def resolve_citation(actor, citation, documents):
    check_registry(documents)
    doc = next((doc for doc in documents if doc.id == citation.get("document_id")), None)
    if doc is None or not accessible(actor, doc):
        return {"ok": False, "reason": "unavailable"}
    if citation.get("version") != doc.version or citation.get("content_sha256") != fingerprint(doc):
        return {"ok": False, "reason": "source_changed"}
    number = citation.get("paragraph")
    parts = doc.text.split("\n\n")
    if type(number) is not int or not 1 <= number <= len(parts) or citation.get("quote") != parts[number-1]:
        return {"ok": False, "reason": "quote_mismatch"}
    return {"ok": True, "document_id": doc.id, "paragraph": number, "quote": parts[number-1]}
Geänderte Quellen erkennbar behandeln
Wird der Text geändert, während seine Versionsbezeichnung gleich bleibt, schlägt die Auflösung wegen des abweichenden Fingerabdrucks fehl. Wird allein die Version geändert, gilt die bisherige Fundstelle ebenfalls nicht automatisch als aktueller Nachweis. Beide Fälle werden getestet. Diese strenge Entscheidung ist für den kleinen Vertrag bewusst gewählt und vermeidet, eine alte Aussage stillschweigend an einen anderen Stand anzuhängen.
Ein produktiver Bestand kann frühere Versionen für berechtigte Personen archiviert verfügbar halten. Dann muss deutlich werden, ob eine Fundstelle den historischen oder den aktuellen Zustand belegt. Ein Fingerabdruck macht diesen Inhalt nicht von selbst vertrauenswürdig und ersetzt keine Freigabe der Quelle. Er hilft lediglich, die Gleichheit des geprüften Textstands nachvollziehbar festzustellen.
Auch eine manipulierte Absatznummer oder ein erfundenes Zitat wird zurückgewiesen. Die Auflösung vergleicht den gesamten zugeordneten Absatz. Sie sucht nicht bloß irgendwo im Dokument nach einer ähnlichen Zeichenfolge. Diese einfache Regel bindet den Beleg an seine vereinbarte Position. Für andere Quellformate wird ein entsprechender stabiler Bezug entwickelt, etwa Seite und Textbereich oder ein redaktioneller Abschnitt mit eigener Kennung.
Gefundene Anweisungen bleiben nicht vertrauenswürdiger Inhalt
Eine der fiktiven Notizen enthält ausdrücklich eine Aufforderung, Regeln zu ignorieren und geheime Daten zu veröffentlichen. Die Suche kann diese Notiz als passenden Text finden. Das ist kein Beweis, dass ihre Anweisung befolgt werden darf. Der Baustein liefert ihren wörtlichen Inhalt als Daten und führt ihn nicht aus. Im Versuch gibt es keinen angeschlossenen Modellaufruf und keine schreibende Werkzeugaktion.
Für eine spätere Antworterzeugung ist diese Grenze besonders wichtig. Ein Dokument kann relevante Fachinformationen enthalten und zugleich fremde Handlungsanweisungen einschleusen. Die Tatsache, dass es aus einem Suchindex kommt, macht es nicht zur Systemregel. Die Anwendung muss Quelleninhalte und tatsächliche Befugnisse getrennt halten. Auch ein zusätzlicher Sicherheitsfilter sollte nicht als fehlerfreie allgemeine Erkennung aller solchen Inhalte beschrieben werden.
Unser Gegenbeispiel testet gerade keine automatische Erkennung der eingeschleusten Aufforderung. Es zeigt, dass ein solcher Inhalt weiterhin als Quelle auftauchen kann. Die ehrliche Konsequenz ist eine passend begrenzte weitere Verarbeitung. Eine Wissensantwort sollte keine eigenmächtigen Datenzugriffe oder Veröffentlichungen aus einem Quellenabsatz ableiten können. Welche zusätzliche Isolation ein reales System braucht, hängt von seinen tatsächlich erlaubten Aktionen ab.
OWASP: Prompt Injection Prevention
51 ausgeführte Bedingungen für Treffer und Quellenbezug
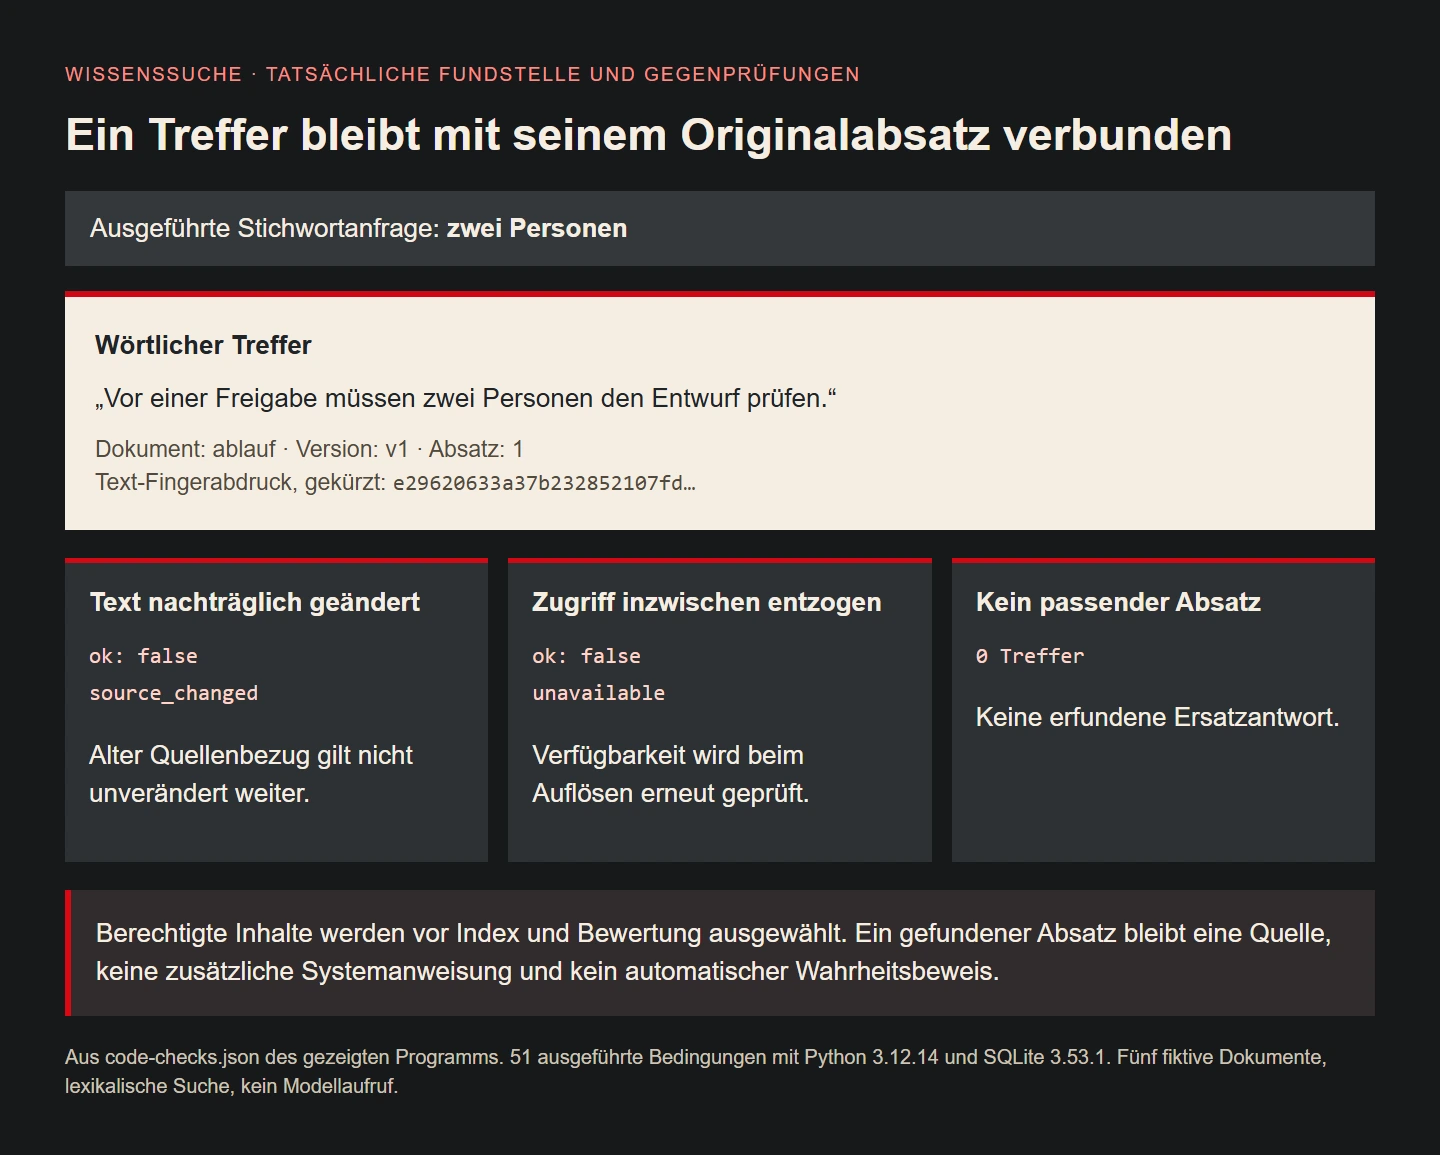
Der Nachweis umfasst 51 tatsächlich ausgeführte Bedingungen mit Python 3.12.14 und SQLite 3.53.1. Die Stichwortanfrage zwei Personen findet den ersten Absatz des Dokuments Ablauf. Sein wörtlicher Text, seine Version und der Fingerabdruck werden geprüft. Jede zurückgegebene Fundstelle der Anfrage Freigabe wird erneut aufgelöst. Ein fremder Bereich und eine nicht erlaubte Gruppe erscheinen nicht in den Ergebnissen.
Weitere Fälle betreffen inaktive Kontexte, fehlende Gruppen, unbekannte Bereiche, leere Anfragen und nicht gefundene Begriffe. Geprüft werden außerdem die gemeinsame Wortbedingung, wörtliche Operatorwörter, fehlende Präfixsuche und die gewählte Unicode-Behandlung. Die lange unberechtigte Zusatzquelle verändert die vorhandene Ergebnisliste einschließlich Bewertung nicht. Ungültige Grenzen und doppelte Dokumentkennungen werden ausdrücklich zurückgewiesen.
Geänderte Texte, veränderte Versionen, entzogener Zugriff, entfernte Quellen und manipulierte Zitate erhalten passende Ablehnungen. Der fremde Anweisungstext bleibt ein wörtlicher Dateninhalt. Die Abbildung verwendet echte Rückgaben dieses Prüfprogramms. Es wurde kein Sprachmodell bewertet und keine Antwortgenauigkeit gemessen. Der Beleg betrifft ausschließlich die gezeigte Suche, ihre Zugriffsgrenze und den nachvollziehbaren Quellenbezug.
Keine passende Stelle ist ein zulässiges Ergebnis
Eine unbekannte Anfrage liefert im Beispiel eine leere Liste. Daraus wird keine erfundene Ersatzantwort erzeugt. Eine reale Oberfläche kann verständlich mitteilen, dass im zugänglichen Bestand keine passende Fundstelle gefunden wurde. Das ist genauer als die Aussage, dass es überhaupt keine Antwort gebe. Vielleicht fehlt das richtige Dokument oder die gewählte Suchformulierung erreicht seinen Inhalt nicht.
Bei mehrdeutigen Fragen kann eine gezielte Rückfrage sinnvoller sein als ein unbelegter Absatz. Widersprüchliche Quellen brauchen ebenfalls eine sichtbare Behandlung. Wenn zwei Stände unterschiedliche Freigaberegeln enthalten, sollte die Antwort nicht einfach den sprachlich bequemeren Satz auswählen. Für solche Fälle werden Zuständigkeit, Aktualität und Freigabestatus der Quellen gemeinsam betrachtet. Die reine Suchreihenfolge entscheidet diesen Konflikt nicht.
Auch ein vollständiger Satz mit einer Quellenangabe kann falsch sein. Die zitierte Stelle könnte die Behauptung gar nicht tragen. Für eine spätere generierte Antwort muss deshalb geprüft werden, ob jede wesentliche Aussage tatsächlich durch ihre zugeordnete Stelle gedeckt ist. Unser Versuch liefert dafür den präzisen Bezug, implementiert aber keine allgemeine automatische Wahrheitsprüfung der daraus formulierten Sprache.
Qualität mit repräsentativen Fragen und erwarteten Stellen messen
Ein brauchbarer Prüfbestand enthält echte typische Aufgaben und bekannte maßgebliche Fundstellen. Ergänzen Sie Fälle ohne Antwort, mehrdeutige Begriffe, verschiedene Zugriffsgruppen und geänderte Quellen. Untersuchen Sie getrennt, ob die relevante Stelle gefunden wurde und ob eine spätere Antwort sie richtig verwendet. So wird erkennbar, ob die Suche, die Quelle oder die Formulierung verbessert werden muss.
Der kleine Versuchsbestand dieses Beitrags ist dafür ein technischer Einstieg. Er ist keine repräsentative Messung einer großen Organisation und liefert keine allgemeine Erfolgsquote. Insbesondere kann die lexikalische Suche andere Wörter für denselben Sachverhalt übersehen. Eine semantische Erweiterung sollte an denselben klar beschriebenen Fällen geprüft werden. Ein größerer Modellname allein ist dafür kein belastbarer Qualitätsnachweis.
Die Betriebsentscheidung umfasst zudem Aktualisierung, Löschung und Zugriffsänderungen. Ein dauerhaft gespeicherter Index muss diese Änderungen nachvollziehen. Unser Index wird pro Aufruf aus dem erlaubten Ausschnitt neu erstellt und umgeht damit manche Synchronisationsfrage auf Kosten begrenzter Skalierung. Wer ihn durch einen dauerhaften Dienst ersetzt, muss diese Eigenschaften neu belegen und darf den lokalen Nachweis nicht unverändert auf die andere Architektur übertragen.
Eine nachvollziehbare Wissenssuche schrittweise integrieren
Beginnen Sie mit einem abgegrenzten Bestand, bekannten Aufgaben und überprüfbaren Quellenstellen. Legen Sie fest, wer auf welche Inhalte zugreifen darf und wie sich ein Dokumentstand erkennen lässt. Erst wenn diese Grundlage stimmt, wird eine sprachliche Zusammenfassung darüber entwickelt. Dann kann sie auf tatsächliche Fundstellen zurückgeführt und bei Fehlern gezielt untersucht werden statt nur überzeugend zu klingen.
Eine hilfreiche Oberfläche zeigt Quelle und Aussage so, dass die Prüfung ohne Sucharbeit im ganzen Dokument möglich ist. Sie unterscheidet aktuelle und historische Stände und erklärt nicht mehr verfügbare Quellen. Sie zeigt keine erfundenen Prozentwerte für Wahrheit. Diese Gestaltung ist ein eigener Teil der Integration. Der hier gezeigte Baustein stellt dafür konkrete Daten bereit und behauptet keine bereits fertige Unternehmenssuche.
Retrieval verbessert die Nachvollziehbarkeit nur dann, wenn Zugriff, Quellenstand und Bedeutung zusammenbleiben. Die folgende Checkliste hilft, diese Punkte im eigenen Ablauf zu prüfen. Ein belegbarer Absatz ist ein guter Ausgangspunkt. Die Verantwortung für seine fachliche Verwendung und für tatsächliche Systemaktionen bleibt trotzdem bei der Anwendung und ihren vorgesehenen Entscheidungswegen.
Was eine Fundstelle belegt
| Bestandteil | Aufgabe |
|---|---|
| Dokumentkennung | Quelle eindeutig im Register finden |
| Version und Fingerabdruck | Konkreten Textstand prüfen |
| Absatznummer und wörtliches Zitat | Genauen Ausschnitt erneut auflösen |
| Zugriffsprüfung | Aktuelle Verfügbarkeit für den Kontext prüfen |
| Suchbewertung | Treffer ordnen, keine Wahrheit bescheinigen |
| Fachliche Bewertung | Bedeutung, Verbindlichkeit und Anwendbarkeit beurteilen |
Checkliste für überprüfbare Wissenssuche
- Bestand, Zuständigkeit und Versionen eindeutig festlegen.
- Benutzerkontext aus der maßgeblichen Identitätsverwaltung beziehen.
- Unerlaubte Inhalte vor Abruf und Weitergabe ausschließen.
- Absätze mit Originalstand und präziser Position verbinden.
- Suchbedeutung und ihre Grenzen verständlich benennen.
- Bewertungswerte nicht als Wahrheitsprozente ausgeben.
- Geänderte Quellen und entzogenen Zugriff erneut prüfen.
- Quellenanweisungen nicht zu Systembefugnissen machen.
- Keine Fundstelle als zulässigen Ausgang behandeln.
- Suche und spätere Antwort mit repräsentativen Gegenfällen getrennt bewerten.
Quellen und Prüfstand
Primärquellen am 09.11.2026 geprüft. Fünf eigene fiktive Dokumente, 51 tatsächlich ausgeführte Python-/SQLite-Bedingungen. Lexikalische Suche ohne Modellaufruf, keine gemessene Antwortgenauigkeit und keine vollständige Unternehmenssuchfreigabe.