Suche, Filter und Seitenaufteilung entwickeln
Treffer vollständig auswählen, sinnvoll sortieren und mit verlässlichen Seitenlinks erreichbar machen.
Suche, Filter und Seite bilden einen gemeinsamen Zustand
Eine Ergebnisliste funktioniert zuverlässig, wenn Suchbegriff, Bereich, Sortierung und Seitenzahl gemeinsam behandelt werden. Ein passender Filter mit einer alten Seitenzahl kann eine scheinbar leere Liste erzeugen. Eine neue Sortierung mit verlorener Auswahl wirkt wie ein Fehler. Deshalb entwickeln wir die vier Angaben als einen nachvollziehbaren Zustand und nicht als voneinander unabhängige Schaltflächen mit jeweils eigener Nebenlogik.
Unser vollständiges Beispiel durchsucht zwölf ausdrücklich fiktive Einträge aus den Bereichen Webseiten, Apps und KI. Drei Treffer passen auf eine Seite. Die kleine Datenmenge macht jede Entscheidung kontrollierbar: Welche Einträge gehören zur Auswahl, in welcher Reihenfolge stehen sie und welche davon erscheinen tatsächlich? Wir verwenden einen eigenen Node-Server mit serverseitig erzeugtem HTML. Der Suchablauf benötigt kein JavaScript im Browser.
Die URL beschreibt die aktuelle Auswahl. Sie kann erneut geöffnet, kopiert und über den normalen Browser-Zurückweg erreicht werden. Ein GET-Formular verändert die Auswahl und normale Links führen zu anderen Ergebnisseiten. Dieser Aufbau bildet eine bewusst einfache Grundlage. Eine spätere dynamische Erweiterung muss dieselben fachlichen Regeln erhalten, statt eine zweite abweichende Bedeutung für Suchbegriff und Seitenzahl einzuführen.
Mit einem ausdrücklich begrenzten Suchvertrag beginnen
Legen Sie zuerst fest, was die Suche tatsächlich leisten soll. Unser Beispiel sucht ausschließlich in Titel und Kurzbeschreibung. Mehrere durch Leerzeichen getrennte Wörter müssen alle vorkommen. Ein Wort kann im Titel und ein anderes in der Beschreibung stehen. Die Bereichsauswahl kommt als zusätzliche Bedingung hinzu. Diese Schnittmenge ist einfach zu erklären und lässt sich anhand einzelner fiktiver Einträge vollständig überprüfen.
Es gibt hier keine automatische Rechtschreibkorrektur, keine Synonymliste und keine Bedeutungssuche mit einem Sprachmodell. Der Begriff prufen findet deshalb nicht automatisch prüfen. Ebenso werden verschiedene Wortformen nicht auf einen gemeinsamen Stamm zurückgeführt. Solche Erweiterungen können sinnvoll sein, benötigen aber eigene Regeln und Beispiele. Die Oberfläche sollte nicht durch eine weitreichende Bezeichnung Erwartungen erzeugen, die ihr tatsächlicher Algorithmus nicht erfüllt.
Punkte und Sternchen bleiben gewöhnliche Zeichen. Eine Eingabe wie Punkt-Stern wird nicht als regulärer Ausdruck ausgeführt. Die Suche erzeugt auch keine SQL-Abfrage aus zusammengesetzten Eingabeteilen, weil dieser Entwurf ein kleines Array verarbeitet. Bei einer späteren Datenbankanbindung muss dieselbe fachliche Bedeutung mit gebundenen Parametern umgesetzt werden. Die gezeigte Array-Suche ist weder Volltextindex noch Leistungsnachweis für einen großen Katalog.
Eingaben vor der Suche einheitlich lesen
Der Parser akzeptiert genau vier Parameternamen. Unbekannte Namen und mehrfach angegebene Werte werden zurückgewiesen. Für Bereich und Sortierung gelten feste erlaubte Werte. Die Seitenzahl muss eine positive dezimale Ganzzahl mit höchstens vier Stellen sein. Null, negative Zahlen, Brüche und Schreibweisen mit führender Null gehören nicht zum Vertrag. Der Server antwortet bei solchen ungültigen Angaben mit einem passenden Fehlerstatus.
Der Suchbegriff wird in NFC normalisiert. Äußerer Leerraum verschwindet und mehrere innere Leerzeichen werden zusammengefasst. Vor dieser Vereinheitlichung werden Steuerzeichen abgewiesen. Nach der Vereinheitlichung sind höchstens 80 Unicode-Codepunkte erlaubt. Das ist eine konkret gewählte Eingabegrenze und keine Behauptung über sichtbare Zeichenbreiten oder eine allgemeine Suchmaschinenregel. Zusammengesetzte sichtbare Zeichen können mehrere Codepunkte besitzen.
Fehlende oder leere optionale Werte führen hier zu den beschriebenen Vorgaben. Diese Entscheidung wird ebenso geprüft wie ungültige Angaben. Wichtig ist die Eindeutigkeit: Wenn ein Parameter zweimal auftaucht, entscheidet nicht zufällig eine Bibliothek über den gültigen Wert. Das Beispiel lehnt die Mehrfachangabe ausdrücklich ab. Ein anderer Vertrag wäre möglich, müsste aber in Parser, Oberfläche und Tests übereinstimmen.
MDN: URLSearchParams · Unicode Normalization
Erst filtern, dann sortieren, dann aufteilen
Die Reihenfolge der Verarbeitung ist entscheidend. Zuerst werden alle passenden Einträge ermittelt. Danach wird diese vollständige Auswahl sortiert. Erst anschließend wird der Ausschnitt für eine Seite gebildet. Würde die Anwendung zuerst drei beliebige Einträge abschneiden und danach filtern, könnte sie Treffer auf anderen Seiten übersehen. Die angezeigte Gesamtzahl wäre dann ebenfalls nicht zuverlässig aus dem Ergebnis ableitbar.
Die Sortierung Neueste zuerst verwendet das Datum und anschließend die eindeutige ID. Die Titelsortierung verwendet einen deutschen Intl.Collator und ebenfalls die ID als Gleichstandsregel. Damit bleibt auch bei gleichen Titeln oder gleichem Datum die Reihenfolge bestimmt. Die Beispieldaten besitzen feste Werte. Die Suche verändert ihre ursprüngliche Reihenfolge nicht, sondern sortiert eine neu erzeugte Auswahl.
Eine stabile Reihenfolge ist eine Voraussetzung für nachvollziehbare Seiten. Sie verhindert jedoch nicht jede Veränderung in einem produktiven Bestand. Wenn neue Inhalte zwischen zwei Aufrufen hinzukommen, kann sich eine mit Versatz berechnete Seite verschieben. Für große oder stark veränderliche Listen kann eine andere Seitenstrategie sinnvoll sein. Diese Entscheidung richtet sich nach Datenmenge, Änderungsrate und der Aufgabe der Besucher.
Den überprüfbaren Suchkern vollständig zeigen
Der folgende Baustein enthält die zwölf Beispieldatensätze, den Eingabeparser, die Auswahl und den Aufbau der URL-Parameter. Er lässt sich unabhängig von der HTTP-Darstellung ausführen. Dadurch können wir etwa die Schnittmenge von Suchbegriff und Bereich prüfen, ohne dafür einen Browserklick nachzustellen. Die sichtbare Oberfläche nutzt anschließend genau denselben Kern und keine zweite nur ähnlich aussehende Suchfunktion.
Die feste Seitengröße beträgt drei. Eine leere Treffermenge besitzt für die Darstellung eine Seite ohne Ergebnis. Eine formal gültige, aber zu große Seitenzahl wird auf die letzte vorhandene Seite begrenzt. Diese Regel unterscheidet sich von einer ungültig geschriebenen Seitenzahl. Der Server behandelt beide Fälle bewusst verschieden und macht den tatsächlich verwendeten Zustand anschließend in der Adresse sichtbar.
export const records = [
  ['01','Webseiten planen','web','2026-02-01','Ziele und Inhalte einer Webseite abstimmen.'],
  ['02','Webseiten pflegen','web','2026-02-02','Regelmäßige Pflege und klare Zuständigkeit.'],
  ['03','Webseiten testen','web','2026-02-03','Bedienung und Inhalt einer Webseite prüfen.'],
  ['04','Webseiten gestalten','web','2026-02-04','Typografie und Hierarchie sinnvoll entwickeln.'],
  ['05','Apps planen','app','2026-02-05','Aufgaben und mobile Wege beschreiben.'],
  ['06','Apps offline nutzen','app','2026-02-06','Entwürfe auf dem Gerät erhalten.'],
  ['07','Apps veröffentlichen','app','2026-02-07','Eine Freigabe nachvollziehbar vorbereiten.'],
  ['08','Apps prüfen','app','2026-02-08','Mobile Bedienwege wiederholt testen.'],
  ['09','KI einsetzen','ki','2026-02-09','Konkrete Aufgaben und Grenzen benennen.'],
  ['10','KI prüfen','ki','2026-02-10','Ergebnisse anhand von Quellen prüfen.'],
  ['11','KI automatisieren','ki','2026-02-11','Einen klar begrenzten Ablauf abstimmen.'],
  ['12','KI dokumentieren','ki','2026-02-12','Entscheidungen und Quellen erhalten.']
].map(([id,title,category,date,summary])=>({id,title,category,date,summary}));
const allowed = new Set(['q','category','sort','page']);
const categories = new Set(['all','web','app','ki']);
const sorts = new Set(['newest','title']);
const collator = new Intl.Collator('de', {sensitivity:'base', numeric:true});
const fold = text => text.normalize('NFC').toLocaleLowerCase('de');
export function readQuery(params) {
  for (const key of params.keys()) {
    if (!allowed.has(key) || params.getAll(key).length !== 1)
      throw new Error('Unzulässiger oder mehrfacher Parameter.');
  }
  const raw = params.get('q') || '';
  if (/[\u0000-\u001f\u007f]/u.test(raw)) throw new Error('Suchbegriff enthält Steuerzeichen.');
  const q = raw.normalize('NFC').trim().replace(/\s+/gu,' ');
  if (Array.from(q).length > 80) throw new Error('Suchbegriff ist zu lang.');
  const category = params.get('category') || 'all';
  const sort = params.get('sort') || 'newest';
  const rawPage = params.get('page') || '1';
  if (!categories.has(category) || !sorts.has(sort) || !/^[1-9][0-9]{0,3}$/.test(rawPage))
    throw new Error('Filter, Sortierung oder Seite ist ungültig.');
  return {q, category, sort, page:Number(rawPage)};
}
export function findRecords(state, source=records) {
  const words = fold(state.q).split(' ').filter(Boolean);
  const filtered = source.filter(row => (state.category === 'all' || row.category === state.category)
    && words.every(word => fold(row.title + ' ' + row.summary).includes(word)));
  filtered.sort((a,b) => (state.sort === 'title' ? collator.compare(a.title,b.title)
    : b.date.localeCompare(a.date)) || a.id.localeCompare(b.id));
  const pages = Math.max(1, Math.ceil(filtered.length / 3));
  const page = Math.min(state.page, pages);
  return {state:{...state,page}, total:filtered.length, pages,
    rows:filtered.slice((page-1)*3,page*3)};
}
export function queryString(state) {
  const p = new URLSearchParams();
  if (state.q) p.set('q',state.q);
  if (state.category !== 'all') p.set('category',state.category);
  if (state.sort !== 'newest') p.set('sort',state.sort);
  if (state.page !== 1) p.set('page',String(state.page));
  return p.size ? '?' + p.toString() : '';
}
Neue Auswahl beginnt auf der ersten Seite
Das GET-Formular enthält Suchbegriff, Bereich und Sortierung, aber kein verborgenes Feld für die aktuelle Seite. Wer eine dieser Angaben ändert und Suchen auslöst, beginnt deshalb auf Seite eins. Dieses kleine Detail verhindert einen häufigen Fehler: Eine Person befindet sich auf einer späten Seite und reduziert die Auswahl anschließend auf wenige Treffer. Die alte Seitenzahl darf dann nicht unbemerkt weitergelten.
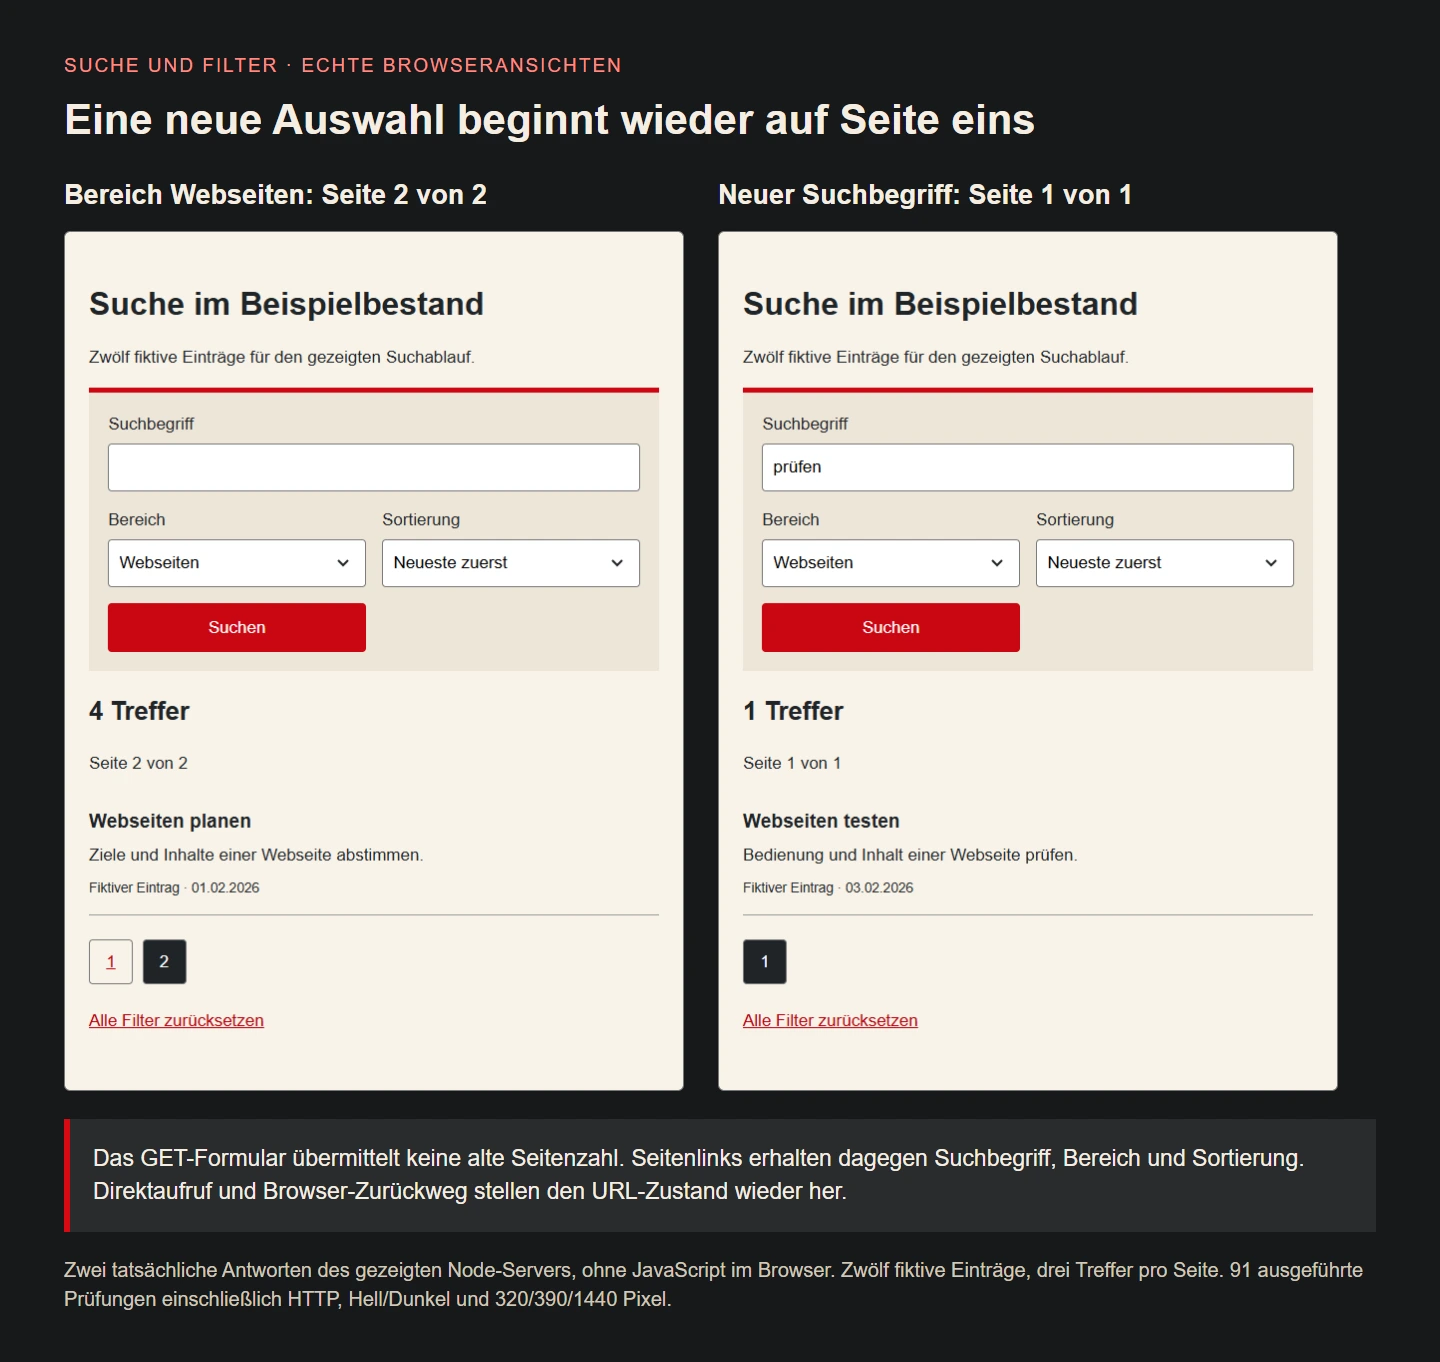
Im tatsächlichen Browserablauf öffnen wir zuerst Seite drei des Gesamtbestands. Danach wird der Bereich Webseiten gewählt. Die neue Auswahl beginnt auf Seite eins von zwei. Ein normaler Seitenlink führt anschließend zur zweiten Seite und erhält den Bereich. Danach sucht die Person innerhalb dieses Bereichs nach prüfen. Nun gibt es genau einen passenden Eintrag auf der ersten und einzigen Ergebnisseite.
Die Regel gilt auch für eine neue Sortierung. Eine geänderte Reihenfolge ist eine neue Sicht auf die Auswahl und beginnt im Formular wieder vorn. Der Server muss dafür keine Vermutung über den zuvor sichtbaren Zustand anstellen. Die übermittelte Anfrage enthält eindeutig die neue Auswahl. Der Browser kann den vorherigen Zustand dennoch über seinen gewöhnlichen Verlauf wieder erreichen.
Seitenlinks erhalten die gesamte Auswahl
Ein Seitenlink wird aus dem aktuellen vollständigen Zustand erzeugt und ändert nur die Seitenzahl. Suchbegriff, Bereich und Sortierung bleiben erhalten. Die URL wird mit URLSearchParams aufgebaut und nicht durch ungeschütztes Zusammenkleben einzelner Benutzereingaben. Bei der Ausgabe in einem HTML-Attribut wird zusätzlich der passende HTML-Kontext berücksichtigt. URL-Kodierung und HTML-Escaping erfüllen dabei unterschiedliche Aufgaben.
Vorgaben werden aus der normalisierten Adresse weggelassen. Für die erste Seite ist keine zusätzliche Seitenangabe nötig. Alle Bereiche und Neueste zuerst müssen ebenfalls nicht ausdrücklich in jeder Adresse stehen. Das verkürzt die Darstellung und vermeidet mehrere unnötige Schreibweisen desselben einfachen Zustands. Diese Normalisierung ist eine Anwendungsregel. Sie ist für sich genommen weder eine Indexierungsstrategie noch eine Rankingzusage.
Die aktuelle Seite wird in der Navigation ausdrücklich als aktuelle Seite bezeichnet. Die anderen Seiten bleiben normale Links. Bei unserem winzigen Bestand können alle vier möglichen Seiten angezeigt werden. Ein großer Katalog benötigt eine begrenzte sinnvolle Seitennavigation oder eine andere Strategie. Tausende Links nur deshalb zu erzeugen, weil die Anzahl rechnerisch bekannt ist, wäre keine hilfreiche Erweiterung dieses Beispiels.
Ungültige Angaben und leere Ergebnisse unterscheiden
Eine ungültige Seitenzahl ist kein Suchergebnis. Sie führt hier zu Status 400 mit einer verständlichen Rücksetzaktion. Ein gültiger Suchbegriff ohne Treffer führt dagegen zu Status 200 und einer klaren leeren Ergebnisanzeige. Diese beiden Situationen brauchen unterschiedliche Erklärungen. Sonst kann eine Person nicht unterscheiden, ob die Eingabe technisch zurückgewiesen wurde oder innerhalb der gewählten Regeln tatsächlich nichts passt.
Eine zu große positive Seite ist formal zulässig, liegt aber außerhalb der aktuellen Auswahl. Unser Beispiel leitet vorübergehend auf die letzte passende Seite weiter. Dabei bleiben die übrigen Angaben erhalten. Wenn überhaupt keine Treffer vorliegen, wird Seite eins verwendet. Die vorübergehende Weiterleitung vermeidet die Behauptung, eine heute nicht vorhandene Ergebnisseite könne auch nach späteren Bestandsänderungen niemals wieder existieren.
Ein anderer Katalog kann für solche Randfälle bewusst einen anderen Vertrag wählen. Entscheidend ist, dass Anzeige, Adresse und Rückmeldung zusammenpassen. Der gezeigte Entwurf verwendet seine Regeln konsequent und prüft die tatsächlichen HTTP-Antworten. Er verbirgt ungültige Angaben nicht einfach hinter einer scheinbar erfolgreichen Standardliste, die die gewählte Suche stillschweigend ignoriert.
Den HTTP-Ablauf und das erzeugte HTML verbinden
Der Server akzeptiert GET auf dem ausdrücklich vorgesehenen Suchpfad. Andere Pfade erhalten 404 und eine nicht unterstützte Methode erhält 405 mit dem erlaubten Verfahren. Gültige Anfragen durchlaufen denselben Parser und Suchkern. Eine abweichende normalisierte Adresse erhält eine vorübergehende Weiterleitung. Erst der eindeutige Zustand erzeugt die eigentliche Ergebnisdarstellung mit Formular, Anzahl, Treffern und Seitennavigation.
Alle variablen Texte werden beim Einfügen in HTML passend maskiert. Das betrifft besonders den Suchbegriff im value-Attribut. Eine Eingabe, die wie ein Bildelement aussieht, bleibt dadurch sichtbarer Feldinhalt und wird kein neues Element. Unsere Prüfung kontrolliert genau diesen Fall. Das ist ein konkreter Ausgabenachweis für diese Vorlage und keine allgemeine Sicherheitsbescheinigung für beliebige zusätzliche Komponenten.
Die Antwort verwendet im kleinen Versuch bewusst no-store. Wir wollen die ausgeführten Zustände unmittelbar beobachten und untersuchen hier keine Cacheoptimierung. Eine reale öffentliche Suche braucht eine gesonderte Entscheidung zu Cache, Datenaktualität und möglichen personenbezogenen Suchbegriffen. Die Einstellung dieses Beispiels ist weder eine Empfehlung für jede öffentliche Ergebnisliste noch ein Nachweis über deren spätere Belastbarkeit.
import {createServer} from 'node:http';
import {readFileSync} from 'node:fs';
import {fileURLToPath} from 'node:url';
import {readQuery, findRecords, queryString} from './search.mjs';
const css = readFileSync(new URL('./example.css',import.meta.url),'utf8');
const escape = value => String(value).replaceAll('&','&').replaceAll('<','<')
.replaceAll('>','>').replaceAll('"','"').replaceAll("'",''');
const shell = body => '<!doctype html><html lang="de"><head><meta charset="utf-8"><meta name="viewport" content="width=device-width,initial-scale=1"><title>Suche im Beispielbestand</title><style>'+css+'</style></head><body><main>'+body+'</main></body></html>';
export function createSearchServer() {
return createServer((req,res) => {
res.setHeader('Content-Type','text/html; charset=utf-8');
res.setHeader('Cache-Control','no-store');
if (req.method !== 'GET') {res.setHeader('Allow','GET');res.writeHead(405);res.end(shell('<h1>Methode nicht unterstützt</h1>'));return;}
const url = new URL(req.url,'http://example.invalid');
if (url.pathname !== '/suche') {res.writeHead(404);res.end(shell('<h1>Nicht gefunden</h1>'));return;}
let result;
try {result = findRecords(readQuery(url.searchParams));}
catch {res.writeHead(400);res.end(shell('<h1>Suchangaben bitte prüfen</h1><p>Suchbegriff, Filter oder Seitenangabe sind ungültig.</p><a href="/suche">Suche zurücksetzen</a>'));return;}
const s=result.state, canonical='/suche'+queryString(s);
if (url.pathname+url.search !== canonical) {res.writeHead(302,{Location:canonical});res.end();return;}
const options=(list,value)=>list.map(([v,t])=>'<option value="'+v+'"'+(v===value?' selected':'')+'>'+t+'</option>').join('');
const form='<form method="get" action="/suche"><label>Suchbegriff<input name="q" value="'+escape(s.q)+'"></label><label>Bereich<select name="category">'+options([['all','Alle'],['web','Webseiten'],['app','Apps'],['ki','KI']],s.category)+'</select></label><label>Sortierung<select name="sort">'+options([['newest','Neueste zuerst'],['title','Titel A bis Z']],s.sort)+'</select></label><button>Suchen</button></form>';
const cards=result.rows.map(row=>'<article data-id="'+row.id+'"><h3>'+escape(row.title)+'</h3><p>'+escape(row.summary)+'</p><small>Fiktiver Eintrag · <time datetime="'+row.date+'">'+row.date.split('-').reverse().join('.')+'</time></small></article>').join('');
const links=Array.from({length:result.pages},(_,i)=>i+1).map(page=>page===s.page?'<span aria-current="page">'+page+'</span>':'<a aria-label="Seite '+page+'" href="/suche'+escape(queryString({...s,page}))+'">'+page+'</a>').join('');
res.writeHead(200);res.end(shell('<h1>Suche im Beispielbestand</h1><p>Zwölf fiktive Einträge für den gezeigten Suchablauf.</p>'+form+'<h2 id="result-title">'+result.total+' Treffer</h2><p id="page-status">Seite '+s.page+' von '+result.pages+'</p>'+ (cards||'<p id="empty">Keine passenden Einträge. Ändern Sie Suchbegriff oder Bereich.</p>')+'<nav aria-label="Ergebnisseiten">'+links+'</nav><a href="/suche">Alle Filter zurücksetzen</a>'));
});
}
if (process.argv[1] && fileURLToPath(import.meta.url) === process.argv[1]) {
const server=createSearchServer();server.listen(0,'127.0.0.1',()=>console.log('http://127.0.0.1:'+server.address().port+'/suche'));
}
Das CSS unterstützt dieselbe Bedienung auf kleinen Ansichten
Das Suchformular ordnet seine Felder bei wenig Platz neu an. Bei sehr schmalen Ansichten stehen sie untereinander. Eingaben und Auswahlfelder erhalten ausreichend hohe Flächen. Der sichtbare Auswahlpfeil liegt mit Abstand zum rechten Rand und der Text bekommt zusätzlichen Platz. Diese Details werden an der tatsächlich erzeugten Oberfläche geprüft, statt allein aus einer vorhandenen Medienabfrage auf gutes Verhalten zu schließen.
Die Fokusdarstellung bleibt deutlich. Für Hell und Dunkel werden passende Farben verwendet, die Interaktion bleibt dieselbe. Die Browserprüfung betrachtet 320, 390 und 1440 Pixel Breite. Das Dokument erzeugt in diesen Fällen keine horizontale Seitenüberbreite. Diese Aussage gilt für die vorliegenden Texte und Daten. Später eingefügte sehr lange untrennbare Inhalte benötigen eine erneute Prüfung ihrer konkreten Darstellung.
*{box-sizing:border-box}body{margin:0;background:#f8f3e9;color:#202428;font:17px/1.5 Arial,sans-serif}main{max-width:70rem;margin:auto;padding:2rem 1.5rem}h1{font-size:2rem;line-height:1.2}form{display:grid;gap:1rem;grid-template-columns:2fr 1fr 1fr auto;align-items:end;padding:1.2rem;border-top:5px solid #cd0712;background:#eee6d9}label{display:grid;gap:.4rem}input,select,button{font:inherit;min-height:48px;border:1px solid #777;border-radius:4px;padding:.65rem;max-width:100%;width:100%}select{appearance:none;background:#fff url("data:image/svg+xml,%3Csvg xmlns='http://www.w3.org/2000/svg' width='12' height='8'%3E%3Cpath d='m1 1 5 5 5-5' fill='none' stroke='%23202428' stroke-width='2'/%3E%3C/svg%3E") no-repeat right 16px center;padding-right:42px}button{background:#cb0712;color:#fff;border-color:#cb0712}article{border-bottom:1px solid #999;padding:.9rem 0}h3{margin:0;font-size:1.2rem}article p{margin:.4rem 0}a{color:#b9000c}:focus-visible{outline:3px solid #cd0712;outline-offset:4px}nav{display:flex;flex-wrap:wrap;gap:.6rem;margin:1.5rem 0}nav a,nav span{min-width:44px;min-height:44px;padding:.55rem 1rem;border:1px solid #777;border-radius:4px;text-align:center}nav [aria-current]{background:#202428;color:white}small{font-size:.85rem}#result-title{scroll-margin-top:1rem}@media(max-width:800px){form{grid-template-columns:1fr 1fr}label:first-child{grid-column:1/-1}}@media(max-width:420px){form{grid-template-columns:1fr}main{padding:1.2rem}h1{font-size:1.7rem}}@media(prefers-color-scheme:dark){body{background:#1e2225;color:#faf3e8}form{background:#30363a}input{background:#fff;color:#202428}a{color:#ff9690}:focus-visible{outline-color:#ff9690}nav [aria-current]{background:#f4eadb;color:#202428}}Den normalen Browserweg tatsächlich benutzen
Alle getesteten Browserkontexte laufen ohne JavaScript. Das Formular sendet eine GET-Anfrage und die Seitensteuerung verwendet gewöhnliche Links. Ein direkter Aufruf stellt den Zustand aus der Adresse her. Nach dem Wechsel auf die zweite Ergebnisseite führt der Browser-Zurückweg wieder zur ersten Seite derselben Bereichsauswahl. Wir beobachten dabei das tatsächliche Dokument und seine angezeigte Seitenangabe.
Die Bedienung beginnt per Tab im beschrifteten Suchfeld. Die tatsächliche Fokusdarstellung wird ebenfalls kontrolliert. Eine produktive Abnahme sollte darüber hinaus die eigene Zielgruppe und ihre verwendeten Hilfstechniken einbeziehen. Unser automatisierter Browserlauf bestätigt die beschriebenen Zustände und Eingaben. Er behauptet keine vollständige Bewertung aller denkbaren unterstützenden Technologien oder aller Browserhistorien außerhalb des geprüften Ablaufs.
Falls die Suche später Ergebnisse ohne Dokumentwechsel nachlädt, kommen neue Aufgaben hinzu. Ladezustand, Fehlerantwort, Reihenfolge paralleler Antworten und eine verständliche Ergebnisankündigung müssen geplant werden. Der zuvor funktionierende Link- und URL-Vertrag bleibt dabei wertvoll. Eine animierte Aktualisierung darf weder die gewählte Seite vergessen noch eine ältere Antwort über einen neueren Suchzustand schreiben.
91 ausgeführte Prüfungen und ihre Grenzen
Der Nachweis umfasst 91 tatsächlich ausgeführte Bedingungen mit Node 24.22.1 und Desktop-Edge. Neun direkte HTTP-Anfragen prüfen Antworten und Weiterleitungen unabhängig von den zusätzlichen Browseraufrufen. Der Suchkern wird unter anderem auf Standardwerte, Schnittmengen, Unicode-Normalisierung, wörtliche Sonderzeichen, leere Ergebnisse, begrenzte Seitenzahlen und stabile Gleichstände geprüft. Die ursprünglichen Beispieldatensätze bleiben nach der Sortierung unverändert.
Im Browser folgen direkte Zustandsaufrufe, Filterwechsel, Seitenwechsel, Zurückgehen, leere Ergebnisse, Rücksetzen und eine sicher als Text erhaltene auffällige Eingabe. Beide Darstellungen und mehrere Breiten gehören dazu. Die Abbildung zeigt zwei tatsächlich erzeugte Ansichten des laufenden Servers. Links ist die zweite Seite einer Bereichsauswahl sichtbar. Rechts hat ein neuer Suchbegriff die Auswahl wieder auf die erste Seite geführt.
Die kleine feste Datenmenge belegt die Logik und die Bedienung dieser Vorlage. Sie belegt keine Antwortzeit unter Last und keine Eignung der Array-Suche für Millionen Datensätze. Es wurde auch kein produktiver Suchdienst einer anderen Anwendung umgebaut. Die Beispiele bleiben bewusst fiktiv, damit nachvollziehbare Funktionsnachweise nicht mit Behauptungen über Kundendaten oder ein bereits vorhandenes öffentliches Angebot verwechselt werden.
Für große Datenbestände die nächste Architekturentscheidung treffen
Bei einer Datenbankanbindung muss die Auswahl vor der Seitenaufteilung erfolgen. Gesamtzahl und sichtbarer Ausschnitt brauchen dieselben fachlichen Filter. Berechtigungen gehören ebenfalls vor beide Berechnungen. Andernfalls könnte eine Liste zwar nur erlaubte Einträge zeigen, ihre Gesamtzahl aber Informationen aus einem anderen Bereich verraten. Unser öffentlicher fiktiver Bestand enthält keine Konten oder Berechtigungsgrenzen und implementiert diese zusätzliche Aufgabe nicht.
Für häufig veränderte oder sehr große Listen sollte die Wahl zwischen Seitenversatz und cursorbasierter Fortsetzung ausdrücklich getroffen werden. Auch ein Suchindex muss seine Aktualität erklären können. Eine heute bearbeitete Beschreibung kann im Index noch einen früheren Stand besitzen. Solche Eigenschaften werden mit realistischen Daten und Lasten geprüft. Aus den zwölf Einträgen dieses Beitrags lassen sich keine seriösen Produktionsgrenzen ableiten.
Beobachten Sie zunächst die tatsächlichen Suchaufgaben. Welche Begriffe verwenden Menschen, welche Filter helfen und wann wird zurückgesetzt? Dabei sind Datenminimierung und der mögliche Personenbezug von Suchbegriffen zu berücksichtigen. Eine erfolglose Suche kann durch fehlenden Inhalt, unverständliche Begriffe oder zu enge Filter entstehen. Eine größere technische Suchmaschine löst diese unterschiedlichen Ursachen nicht automatisch.
Öffentliche Suchadressen brauchen eine bewusste Auffindbarkeitsstrategie
Viele kombinierbare Filter können sehr viele verschiedene Adressen erzeugen. Google beschreibt für solche facettierten Bereiche mögliche Probleme durch unnötige Crawlingarbeit. Deshalb wird für einen realen Bestand entschieden, welche dauerhaften Kategorieziele öffentlich nützlich sind und wie frei kombinierbare Suchzustände behandelt werden. Die reine Funktionsfähigkeit unserer URL-Parameter beantwortet diese redaktionelle und technische Frage noch nicht.
Unser Versuch implementiert keine vollständige Suchmaschinensteuerung. Insbesondere wird aus der Normalisierung der URL kein allgemeiner Canonical-Vertrag für alle Filter abgeleitet. Eine wichtige Kategorie mit eigenständigem Inhalt und eine beliebige leere Suchkombination sind unterschiedliche Fälle. Die konkrete Steuerung muss mit realen Routen, internen Links und Suchmaschinenanforderungen abgestimmt werden. Pauschal alle Varianten gleich zu behandeln wäre zu grob.
Eine gute Ergebnisliste hält mehrere Ebenen zusammen: klare Bedeutung der Eingabe, richtige Auswahl, stabile Reihenfolge, nachvollziehbare Seiten und verständliche Rückkehr. Erst auf dieser Grundlage lohnt sich zusätzlicher Komfort. Die Checkliste und der vollständige Code helfen dabei, den eigenen Ablauf konkret zu prüfen und Erweiterungen an denselben überprüfbaren Regeln auszurichten.
Vertrag für typische Eingaben
| Fall | Ergebnis |
|---|---|
| Ohne Parameter | Zwölf Treffer, drei pro Seite, Neueste zuerst |
| Bereich Webseiten | Vier Treffer auf zwei Seiten |
| Neue Suche prüfen im Bereich Webseiten | Ein Treffer, Seite eins |
| Gültiger Begriff ohne Treffer | 200 mit leerer Anzeige |
| Seite 99 bei vier Treffern | 302 zur letzten passenden Seite |
| Seite null oder mehrfacher Parameter | 400 mit Rücksetzaktion |
| Andere HTTP-Methode | 405 mit erlaubter Methode GET |
Checkliste für Suche und Seitenaufteilung
- Suchfelder und Bedeutung mehrerer Wörter ausdrücklich festlegen.
- Eingaben, erlaubte Werte und Mehrfachparameter eindeutig behandeln.
- Vor dem Aufteilen vollständig filtern und stabil sortieren.
- Gesamtzahl und sichtbare Auswahl aus denselben Regeln bilden.
- Bei neuer Auswahl mit der ersten Seite beginnen.
- In Seitenlinks alle übrigen Angaben erhalten.
- Ungültige Anfrage und gültiges leeres Ergebnis unterscheiden.
- URL-Werte kodieren und HTML-Ausgaben kontextgerecht maskieren.
- Direktaufruf, Zurückweg, Rücksetzen und Tastatur tatsächlich prüfen.
- Datenbankleistung, Berechtigung und Suchmaschinensteuerung gesondert planen.
Quellen und Prüfstand
Primärquellen am 09.11.2026 geprüft. Eigener fiktiver Zwölf-Einträge-Bestand, 91 tatsächlich ausgeführte Bedingungen, neun direkte HTTP-Anfragen und zusätzliche echte Browsernavigationen. Keine Lastmessung oder Produktionsfreigabe.