Indizes mit nachvollziehbaren Messungen bewerten
Zwei synthetische Datenbestände, zwei Listen und ein zusätzlicher Index: Entscheidungen anhand tatsächlicher Beobachtungen treffen.
Ein Datenbankindex lohnt sich, wenn er eine wichtige Arbeitslast zuverlässig verbessert und seine zusätzlichen Kosten vertretbar bleiben. Ein einzelner schneller Durchlauf reicht dafür nicht. Die Entscheidung braucht ein unverändertes fachliches Ergebnis, einen nachvollziehbaren Zugriffsplan und Messungen mit klar abgegrenztem Umfang. Sonst wird aus einer kleinen Zeitdifferenz schnell ein unbegründetes Leistungsversprechen.
Dieser Beitrag untersucht einen konkreten Kandidaten mit PHP und SQLite. Zwei synthetische Datenbestände, zwei unterschiedliche Leseabfragen und ein zurückgerollter Schreibversuch zeigen, warum ein Index nicht automatisch jede Liste beschleunigt. Die Zahlen stammen aus dem tatsächlich ausgeführten Versuch vom 9. November 2026. Sie beschreiben diese Umgebung und diese Datenverteilung. Für die Kapazitätsplanung einer produktiven Webseite ist eine zusätzliche Prüfung der eigenen Arbeitslast erforderlich.
Die Hypothese vor der Messung formulieren
Die Ausgangsfrage lautet nicht: Welche Spalte bekommt einen Index? Sie lautet: Welche wiederkehrende Aufgabe verursacht unter welchen Bedingungen relevante Wartezeit? Eine Kundenansicht könnte die neuesten Ereignisse genau eines Kontos anzeigen. Eine andere Ansicht könnte die neuesten gewöhnlichen Ereignisse aller Konten benötigen. Beide greifen auf dieselbe Tabelle zu. Trotzdem haben sie unterschiedliche Filter und damit unterschiedliche Anforderungen an eine brauchbare Sortierung der gespeicherten Schlüssel.
Für die erste Ansicht lautet unsere Hypothese: Ein gemeinsamer Index auf Konto, Ereignisart und absteigender zeitlicher Reihenfolge verkürzt die Suche nach den letzten 25 seltenen Ereignissen eines Kontos. Die zweite Ansicht ist bewusst eine Gegenprobe. Dort fehlt die Kontobedingung. Wir erwarten deshalb nicht allein aufgrund desselben Tabellennamens denselben Nutzen. Ob der Optimierer einen anderen sinnvollen Weg findet, wird beobachtet statt vorausgesetzt.
Eine gute Hypothese lässt sich widerlegen. Falls die richtige Ergebnisliste unverändert bleibt, der Plan aber keine relevante Arbeit spart und die Laufzeit innerhalb gewöhnlicher Schwankungen liegt, fehlt zunächst ein belastbarer Nutzenbeleg. Dann kann eine andere Spaltenreihenfolge sinnvoll sein. Ebenso kann das Ergebnis lauten, dass diese kleine Tabelle für diese seltene Abfrage keinen zusätzlichen Index benötigt. Auch eine begründete Nichtänderung ist ein fachliches Ergebnis.
Was im Versuch tatsächlich gespeichert wird
Wir erzeugen getrennte Datenbanken mit 10.000 und 50.000 Ereignissen. Es handelt sich um frei erfundene Datensätze ohne Kundenbezug. Die Kontonummer ergibt sich deterministisch aus der laufenden ID und verteilt sich auf 97 Konten. Jedes fünfte Ereignis erhält die Art rare. Die übrigen erhalten common. Zeitstempel werden absichtlich von mehreren Zeilen geteilt. Ein zusätzlicher ID-Vergleich macht die Reihenfolge trotzdem eindeutig.
Jede Zeile enthält außerdem einen Text aus 200 identischen ASCII-Zeichen. Dieser Nutztext ist eine kontrollierte Eigenschaft des Versuchs. Er stellt keine typische Produktbeschreibung, keine reale Logmeldung und keine repräsentative Kompressionsverteilung dar. Gerade diese Offenlegung ist wichtig: Breite Zeilen, unterschiedliche Zeichensätze und stark schwankende Textlängen können andere Speicher- und Zugriffseigenschaften erzeugen. Zwei Zeilenzahlen ersetzen deshalb keine Untersuchung realistischer Datentypen.
CREATE TABLE events (
    id INTEGER PRIMARY KEY,
    account_id INTEGER NOT NULL,
    kind TEXT NOT NULL,
    created_at INTEGER NOT NULL,
    payload TEXT NOT NULL
);

CREATE INDEX events_account_kind_recent
ON events (account_id, kind, created_at DESC, id DESC);
Die zweite Anweisung wird erst nach der ersten Messphase ausgeführt. Der Primärschlüssel bleibt in beiden Phasen erhalten. „Ohne Index“ bedeutet in diesem Artikel daher ohne den zusätzlichen Kandidatenindex. Es bedeutet nicht, dass die Datenbank überhaupt keine geordnete Primärschlüsselstruktur besitzt. Solche begrifflichen Verkürzungen können einen Vergleich sonst schon in der Beschreibung verfälschen.
Der Ergebnisvertrag bleibt unverändert
Die gezielte Abfrage filtert auf Konto 42 und die seltene Ereignisart. Sie liefert ausschließlich ID und Zeitstempel. Die breite Gegenprobe filtert nur auf die gewöhnliche Ereignisart und liefert zusätzlich den Nutztext. Beide Listen werden absteigend nach Zeitstempel und anschließend nach ID sortiert. Die Begrenzung auf 25 Zeilen gehört zur fachlichen Aufgabe und bleibt vor und nach der Änderung identisch.
SELECT id, created_at
FROM events
WHERE account_id = :account_id AND kind = :kind
ORDER BY created_at DESC, id DESC
LIMIT 25;

SELECT id, created_at, payload
FROM events
WHERE kind = :kind
ORDER BY created_at DESC, id DESC
LIMIT 25;
Ein schnelleres Ergebnis wäre wertlos, wenn dabei eine ältere Zeile an die Stelle einer neueren träte. Deshalb berechnet das Prüfprogramm die erwartete Liste zusätzlich in PHP. Es filtert die ursprünglichen Datensätze, sortiert sie mit einem eigenen Vergleich und begrenzt sie erst danach. Jede gemessene SQL-Ausführung wird außerhalb des Zeitfensters mit dieser vollständigen Referenzliste verglichen. Gleiche Zeilenanzahlen allein würden vertauschte oder falsche Datensätze nicht erkennen.
Die gemeinsame Zeitstempelvergabe prüft außerdem einen häufig übersehenen Randfall. Ohne die zweite Sortierspalte könnte eine Liste bei gleichen Zeitwerten unterschiedlich ausfallen. Eine scheinbare Änderung durch den Index wäre dann möglicherweise nur eine vorher unbestimmte Reihenfolge. Deshalb wird die fachlich verlangte Ordnung zuerst präzisiert. Der Index darf anschließend die Durchführung verbessern, ohne diesen Vertrag neu zu definieren.
Die Messgrenze ausdrücklich festlegen
Die verwendete Umgebung bestand aus PHP 8.4.27 mit SQLite 3.53.4 unter Windows. Jede Datenbank wurde im Arbeitsspeicher angelegt. Es gab keine Verbindung zu einem Datenbankserver und keinen Netzwerkweg. Die Ergebnisse enthalten folglich weder Serverwarteschlangen noch Verbindungsaufbau, Netzwerkübertragung oder das Rendering einer vollständigen Webseite. Auch ein kalter Dateisystemcache wurde nicht untersucht.
Vor jeder Lesephase wurden drei Aufwärmdurchläufe je Abfrage ausgeführt. Danach folgten elf Messrunden. Innerhalb jeder Runde wurde zuerst die gezielte und anschließend die breite Abfrage ausgeführt. Zeitlich erfasst wurden execute() und fetchAll(). Das Vorbereiten der Anweisung, der Vergleich mit der Referenzliste und die Erzeugung der Ausgangsdaten lagen außerhalb dieses Zeitfensters. Die Grenze ist damit enger als die gesamte Dauer einer HTTP-Anfrage.
Die Zeitmessung verwendet PHPs monotone hochauflösende Uhr hrtime. Eine monotone Uhr eignet sich für Zeitdifferenzen, weil eine Änderung der Kalenderuhr den gemessenen Abstand nicht entsprechend verschiebt. Die Ausgabe wird aus Nanosekunden in Millisekunden umgerechnet. Die feine Einheit erhöht allerdings nicht automatisch die Aussagekraft einer einzelnen winzigen Messung. Betriebssystemplanung und andere Prozesse bleiben mögliche Einflüsse.
$start = clockNs();
$statements[$name]->execute($query['params']);
$actual = $statements[$name]->fetchAll();
$elapsed = (clockNs() - $start) / 1000000;
check($actual === $references[$name], 'Timed query result mismatch');
$phaseData['queries'][$name]['samples_ms'][] = $elapsed;
Der Ausschnitt stammt aus der ausgeführten Messschleife. clockNs() prüft dabei, ob hrtime(true) einen ganzzahligen Wert liefert. Das vollständige Prüfprogramm verwirft einen ungeeigneten Timerzustand durch eine Ausnahme. Damit wird ein fehlgeschlagener Zeitaufruf nicht versehentlich wie eine gültige Null behandelt. Die Ergebnisprüfung erfolgt nach dem zweiten Uhrenaufruf und beeinflusst das erfasste Abfrageintervall deshalb nicht direkt.
Die tatsächlich beobachteten Laufzeiten
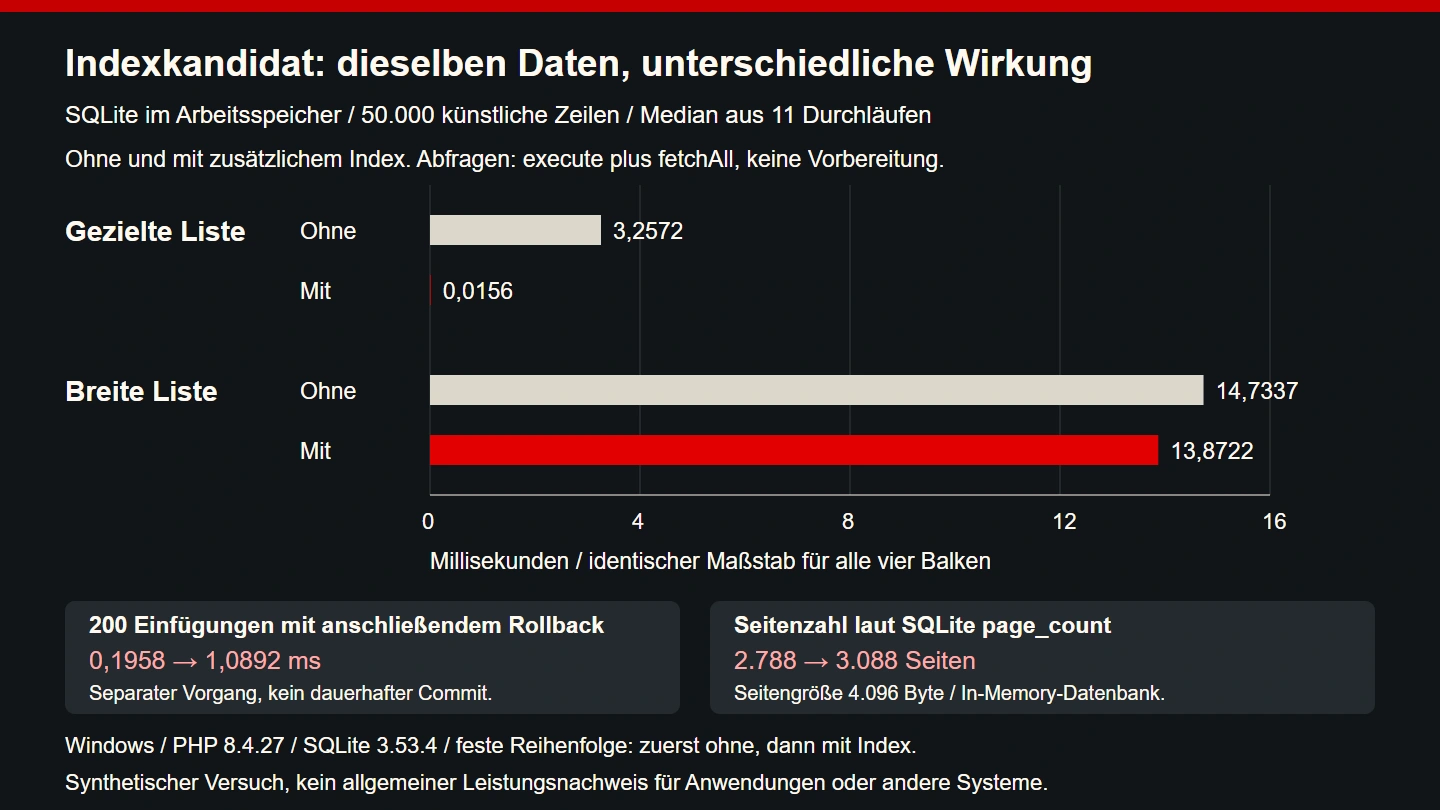
Die folgende Tabelle zeigt die Mediane der jeweils elf erfassten Durchläufe. Alle Werte sind Millisekunden. Die Zahlen wurden aus dem gespeicherten Ergebnisprotokoll übernommen. Vier Nachkommastellen dienen der Rückverfolgbarkeit dieses kleinen Versuchs. Sie versprechen keine entsprechende Stabilität bei einer erneuten Ausführung und sind keine zugesicherte Antwortzeit für eine Kundenanwendung.
| Zeilen | Zusätzlicher Index | Gezielte Liste | Breite Liste | 200 Einfügungen mit Rollback |
|---|---|---|---|---|
| 10.000 | Nein | 0,4358 | 2,5969 | 0,1848 |
| 10.000 | Ja | 0,0084 | 2,7961 | 0,3767 |
| 50.000 | Nein | 3,2572 | 14,7337 | 0,1958 |
| 50.000 | Ja | 0,0156 | 13,8722 | 1,0892 |
Bei der gezielten Liste liegen die beobachteten Mediane mit dem Kandidaten deutlich unter den Werten ohne ihn. Das passt zur Hypothese. Bei der breiten Liste ist das Bild uneinheitlich: Im kleineren Bestand liegt der Wert danach höher, im größeren etwas niedriger. Daraus lässt sich kein belastbarer allgemeiner Beschleunigungseffekt dieser zweiten Abfrage ableiten. Ihr unveränderter Plan liefert dafür eine zusätzliche Erklärung.
Der Median ist der mittlere Wert nach dem Sortieren der elf Messungen. Einzelne Ausreißer verändern ihn weniger stark als einen einfachen Mittelwert. Er ist trotzdem kein Vertrauensintervall, kein hoher Lastperzentilwert und kein Nachweis eines statistisch abgesicherten Effekts. Im privaten Versuchsprotokoll bleiben sämtliche Einzelwerte sowie Minimum und Maximum erhalten. Eine produktive Entscheidung sollte diese Streuung prüfen statt nur die schönste Zahl in eine Präsentation zu übernehmen.
Der Ausführungsplan erklärt den Unterschied
Ohne den Kandidaten meldete SQLite für beide Abfragen einen Tabellendurchlauf und eine zusätzliche temporäre Sortierstruktur. Danach verwendete die gezielte Abfrage einen abdeckenden Zugriff über events_account_kind_recent. Die breite Abfrage behielt dagegen den Tabellendurchlauf samt temporärer Sortierung. Das sind beobachtete Pläne dieser konkreten SQLite-Version mit diesen Statistiken. Andere Datenverteilungen können zu anderen Entscheidungen führen.
Gezielte Liste vorher:
SCAN events
USE TEMP B-TREE FOR ORDER BY

Gezielte Liste nachher:
SEARCH events USING COVERING INDEX events_account_kind_recent
    (account_id=? AND kind=?)

Breite Liste vorher und nachher:
SCAN events
USE TEMP B-TREE FOR ORDER BY
Der Index beginnt mit dem Konto und der Ereignisart. Für die gezielte Liste stehen beide Werte fest. Dahinter liegen Zeitstempel und ID bereits in der benötigten Reihenfolge. Die beiden ausgegebenen Spalten sind im Index enthalten. Die Erklärung von Mehrspaltenindizes und abdeckenden Zugriffen findet sich in der SQLite-Dokumentation zur Abfrageplanung. Hier erklärt dieser Aufbau den beobachteten Nutzen, ohne daraus eine universelle Spaltenreihenfolge abzuleiten.
Bei der breiten Liste fehlt die erste Filterbedingung. Außerdem wird der Nutztext benötigt, der nicht Bestandteil dieses Index ist. Es wäre dennoch ungenau zu behaupten, der Optimierer könne unter solchen Bedingungen grundsätzlich niemals irgendeinen Indexzugriff wählen. Entscheidend ist der tatsächliche Plan. Die Dokumentation zu EXPLAIN QUERY PLAN warnt zudem davor, dessen Darstellungsformat als dauerhaft stabile Programmierschnittstelle zu behandeln. Ein Diagnoseprotokoll darf die Zeilen zeigen, eine Anwendung sollte ihre Fachlogik nicht an diesen Zeichenketten festmachen.
Schreibaufwand und Platzbedarf gehören dazu
Ein zusätzlicher Index muss bei passenden Datenänderungen mitgeführt werden. Unser ergänzender Versuch fügte deshalb je Durchlauf 200 neue Ereignisse in einer Transaktion ein und rollte diese anschließend vollständig zurück. Zwei Aufwärmdurchläufe gingen elf erfassten Durchläufen voraus. Gemessen wurden Transaktionsbeginn, vorbereitete Einfügungen und Rollback zusammen. Nach jedem Durchlauf wurde geprüft, ob wieder exakt die ursprüngliche Zeilenzahl vorhanden war.
Die beobachteten Schreibmediane stiegen nach dem Indexaufbau. Diese Beobachtung macht den zusätzlichen Pflegeaufwand sichtbar. Sie misst jedoch keine dauerhaft bestätigten Schreibvorgänge auf einer SSD. Die Datenbank lag im Speicher und jeder Stapel endete mit Rollback. Eine reale Schreiblast mit Commit, Journal, Sicherungsstrategie und gleichzeitigen Lesern braucht einen eigenen Versuch. Insbesondere darf die Differenz nicht als allgemeiner Preis jeder einzelnen Einfügung vermarktet werden.
Auch die reservierten Datenbankseiten wurden vor den Schreibversuchen erfasst. Bei einer Seitengröße von 4096 Byte stieg die Seitenzahl im kleineren Bestand von 561 auf 620 und im größeren von 2788 auf 3088. Das beschreibt den Seitenumfang der gesamten Datenbank in der jeweiligen Phase. Es ist weder eine Messung des PHP-Arbeitsspeichers noch eine exakte isolierte Größenangabe allein für den Index.
Die Bedeutung von page_count und page_size ist in der offiziellen PRAGMA-Referenz beschrieben. Für eine Betriebsentscheidung wären zusätzlich etwa Sicherungsvolumen, verfügbare Reserven und die Dauer späterer Wartung relevant. Ein schneller Leseweg kann sinnvoll sein, obwohl er Platz kostet. Sinnvoll wird die Abwägung erst, wenn der konkrete Nutzen und die tatsächlich untersuchten Kosten getrennt benannt werden.
Statistiken und Reihenfolge fair dokumentieren
Das Prüfprogramm führt vor jeder Phase ANALYZE aus. Diese Arbeit wird nicht der gemessenen Abfragezeit zugeschlagen. Damit erhält der Optimierer für beide Phasen Statistiken über den jeweiligen Zustand. Das ist eine bewusst festgelegte Bedingung des kleinen Experiments. Für den laufenden Betrieb empfiehlt SQLite inzwischen in vielen Fällen PRAGMA optimize. Die ANALYZE-Dokumentation beschreibt diesen empfohlenen Wartungsweg. Unser Versuchsaufbau ist keine Anweisung, vor jeder Webanfrage sämtliche Tabellen zu analysieren.
Die Phasen wurden immer in derselben Reihenfolge ausgeführt: zuerst ohne den zusätzlichen Index, danach mit ihm. Das begrenzt die Aussage, weil sich Hintergrundlast und thermische Bedingungen während eines Laufs ändern können. Drei Aufwärmrunden entfernen diese Möglichkeit nicht. Für eine robustere Vergleichsreihe wären mehrere frische Datenbanken, wechselnde Phasenreihenfolgen und wiederholte Läufe zu unterschiedlichen Zeitpunkten sinnvoll. Ein veröffentlichter Methodenabschnitt sollte solche Grenzen sichtbar lassen.
Ebenso wichtig ist die Verteilung der Parameter. Ein einzelnes Konto mit 25 jüngsten Treffern bildet weder ein sehr großes Sonderkonto noch ein fast leeres Konto vollständig ab. Für die eigene Anwendung sollte eine kleine, begründete Parameterfamilie entstehen: häufige und seltene Werte, kleine und große Mandanten sowie passende und leere Ergebnisse. Dabei bleibt das fachliche Sortier- und Berechtigungsmodell unverändert. Sonst werden verschiedene Aufgaben miteinander verglichen.
Den Nutzen in der gesamten Anwendung bewerten
Eine auffällige Einzelmessung sagt noch nicht, wo die Entwicklungszeit am besten eingesetzt wird. Die gezielte Liste könnte täglich tausendmal geöffnet werden oder nur einmal im Quartal. Die breite Liste könnte dagegen den häufigsten Einstieg bilden. Für die Priorisierung werden deshalb Aufrufhäufigkeit, betroffene Benutzer und die tatsächlich wahrgenommene Wartezeit ergänzt. Diese Größen wurden im synthetischen Versuch nicht erhoben. Sie müssen aus der eigenen Anwendung stammen und dürfen nicht nachträglich erfunden werden.
Auch die Lage der Messgrenze hilft bei dieser Entscheidung. Eine schnellere Datenbankabfrage macht eine Webseite nicht um denselben absoluten Anteil schneller, wenn deren größte Wartezeit beim externen Versanddienst entsteht. Umgekehrt kann eine kurze, sehr häufig wiederholte Abfrage unter hoher Parallelität relevant werden. Deshalb betrachtet die technische Untersuchung sowohl die einzelne Liste als auch ihren Platz im vollständigen Ablauf. Ein Index ist eine mögliche Maßnahme innerhalb dieses Ablaufs.
Für eine belastbare Vergleichsreihe werden außerdem unveränderte Nebenbedingungen benötigt. Wenn gleichzeitig Nutztext gekürzt, Ergebnisfelder entfernt und ein Index ergänzt werden, bleibt der Anteil der einzelnen Änderung unklar. Solche kombinierten Verbesserungen können produktiv sinnvoll sein. Ihr Ergebnis sollte dann aber als gemeinsames Änderungspaket dokumentiert werden. Wer die Wirkung eines bestimmten Index untersuchen möchte, verändert für diesen Vergleich ausschließlich den vorgesehenen Kandidaten und hält den Ergebnisvertrag fest.
Schließlich benötigt auch der Indexbestand Pflege. Zwei ähnlich benannte Strukturen sind nicht automatisch gleichwertig. Eindeutigkeit, verwendete Sortierungen und andere Abfragen können einen Unterschied machen. Eine scheinbar doppelte Struktur wird deshalb nicht allein aufgrund ihres Präfixes entfernt. Zuerst werden ihre fachliche Aufgabe und ihre tatsächlichen Nutzer geprüft. Für das anschließende Entfernen gelten dieselben Anforderungen an Sicherung, Rücknahme und erneute Ergebnisprüfung wie für das Hinzufügen.
Andere Datenbanksysteme richtig einbeziehen
Die hier gemessenen Zahlen stammen ausschließlich aus SQLite. PostgreSQL und MySQL wurden dafür nicht als Server gestartet. Ihre Werkzeuge sind dennoch für die Übertragung der Methode relevant. Die PostgreSQL-Dokumentation zu EXPLAIN unterscheidet geschätzte Planungskosten von tatsächlich gemessenen Zeiten. Die Kostenwerte sind keine direkt ablesbaren Millisekunden. Auch wiederholt ausgeführte innere Planknoten müssen im Zusammenhang ihrer Schleifenzahl verstanden werden.
Sowohl PostgreSQLs Variante mit ANALYZE als auch MySQL 8.4 EXPLAIN ANALYZE führen die untersuchte Anweisung tatsächlich aus. Das ist für lesende Testfälle hilfreich und für schreibende Anweisungen entscheidend. Eine Diagnose darf nicht unbemerkt produktive Änderungen erzeugen. Für Untersuchungen werden deshalb eine geeignete isolierte Umgebung und ein vorher verstandener Transaktionsumfang gewählt. Ein Rollback ist dabei kein pauschales Versprechen, jede denkbare Nebenwirkung einer beliebigen Anweisung rückgängig zu machen.
Auch die Bedeutung von abdeckenden Zugriffen, Speicherseiten und physischer Zeilenablage ist systemspezifisch. Ein SQLite-Plantext wird nicht durch das Austauschen eines Produktnamens zu einem PostgreSQL-Plan. Übertragbar sind die Fragen: Ist das Ergebnis korrekt? Welche Arbeit wird vermieden? Welche Statistik liegt zugrunde? Welche Kosten kommen hinzu? Die Antworten werden mit dem tatsächlich eingesetzten System neu erhoben.
Entscheidungsmatrix für den nächsten Schritt
| Beobachtung | Sinnvolle Einordnung | Nächster Schritt |
|---|---|---|
| Gezielte Liste schneller und Ergebnis identisch | Hypothese für diese Daten gestützt | Weitere relevante Parameter und Lastbedingungen prüfen |
| Breite Liste mit gleichem Plan | Kein belegter allgemeiner Nutzen dieses Kandidaten | Eigene Hypothese für diese Listenaufgabe formulieren |
| Schreibversuch langsamer | Zusätzlicher Pflegeaufwand beobachtet | Dauerhafte reale Schreiblast getrennt messen |
| Mehr Datenbankseiten | Zusätzlicher Platzbedarf im Gesamtzustand | Wartung, Sicherungen und Reserven einbeziehen |
| Nur ein kleiner Zeitunterschied | Schwankung und Methodeneffekt möglich | Rohwerte, Wiederholungen und Messgrenze untersuchen |
Vor einer produktiven Änderung wird daraus eine konkrete Entscheidungsvorlage. Sie enthält die betroffene Benutzeraufgabe, den Kandidaten, die Ergebnisprüfungen und die erwartete Verbesserung innerhalb eines definierten Lastbereichs. Außerdem wird festgehalten, wann die Änderung zurückgenommen oder neu untersucht wird. Ein zukünftiger Datenzuwachs, eine andere Sortierung oder ein neues Exportfeld kann den zuvor sinnvollen Index anders bewerten lassen.
Checkliste für nachvollziehbare Indexversuche
- Geschäftliche Liste, Filter, Sortierung und Begrenzung eindeutig beschreiben.
- Bestehende Primärschlüssel und zusätzliche Kandidaten getrennt benennen.
- Erwartete Zeilen und Reihenfolge unabhängig vom gemessenen SQL prüfen.
- Datengröße, Werteverteilung und synthetische Eigenschaften dokumentieren.
- Laufzeitversionen und relevante Datenbankeinstellungen festhalten.
- Aufwärmen, Wiederholungen und zeitlich eingeschlossene Arbeit offenlegen.
- Rohwerte behalten und neben dem Median auch die Streuung ansehen.
- Pläne vor und nach der Änderung mit denselben Parametern erfassen.
- Schreiben, Platzbedarf und Wartung passend zur tatsächlichen Nutzung prüfen.
- Keine Speichermessung als Festplatten- oder Netzwerktest ausgeben.
- Wiederholungs- und Rücknahmekriterien vor der Übernahme festlegen.
Der ausgeführte Versuch bestand insgesamt 168 Prüfungen. Darin enthalten sind vollständige Ergebnisvergleiche der Aufwärm- und Messabfragen, die wiederhergestellten Zeilenzahlen nach jedem Schreibstapel und Integritätsprüfungen der Datenbanken. Die Anzahl ist ein nachvollziehbarer Prüfumfang dieses Beispiels. Sie macht aus zwei synthetischen Datenbeständen keine allgemeingültige Lastsimulation. Genau diese Trennung ermöglicht eine belastbare fachliche Aussage ohne überzogene Versprechen.