Webhooks mit Wiederholungen und Fehlerfällen verarbeiten
Ankunft, fachliche Wirkung und Rückmeldung trennen und erneute Zustellungen nachvollziehbar behandeln.
Eine erneute Zustellung darf keinen zweiten Auftrag erzeugen
Ein Webhook informiert eine Anwendung über ein Ereignis in einem anderen System. Dafür sendet die Gegenstelle eine HTTP-Anfrage. Diese einfache Verbindung enthält eine schwierige Unsicherheit: Die empfangende Anwendung kann eine Änderung bereits gespeichert haben, während ihre Antwort auf dem Rückweg verloren geht. Der Absender sieht dann keinen eindeutigen Erfolg und kann dieselbe Information erneut zustellen.
Die richtige Frage lautet deshalb nicht nur, ob die Anfrage ankommt. Sie lautet auch, welche Wirkung ein wiederholtes Ereignis haben darf. Unser vollständiges Beispiel verarbeitet einen ausdrücklich fiktiven Zähler. Ein Ereignis addiert einen kleinen Wert und speichert einen Verarbeitungsbeleg. Die Wiederholung liefert den vorhandenen Beleg zurück, ohne erneut zu addieren. Es gibt keine Zahlung, Bestellung oder echte Kundenänderung.
Der Baustein wurde mit echten lokalen HTTP-Anfragen einschließlich paralleler Zustellung ausgeführt. Zusätzlich wurden ein Fehler vor dem Speichern und ein gezielt verlorener Antwortweg nach dem Speichern durchgespielt. Diese Fälle machen den entscheidenden Unterschied sichtbar: Eine fehlende Antwort sagt noch nicht, ob die fachliche Wirkung stattgefunden hat. Der gespeicherte Zustand muss diese Frage beim nächsten Versuch eindeutig beantworten können.
Ereignis und Übermittlungsversuch ausdrücklich unterscheiden
Unser Lehrvertrag verwendet eine Ereigniskennung im signierten Inhalt und eine zusätzliche Kennung für den Übermittlungsversuch. Mehrere Versuche können dasselbe Ereignis tragen. Für die fachliche Wiederholungssperre ist die Ereigniskennung entscheidend. Würde jeder neue Übermittlungsversuch automatisch als neuer Auftrag gelten, könnte eine berechtigte erneute Zustellung die Wirkung mehrfach auslösen. Das wäre trotz korrekter Signatur ein fachlicher Fehler.
Ein tatsächlicher Anbieter kann andere Kennungen und Wiederholungsregeln verwenden. GitHub dokumentiert beispielsweise, dass eine angeforderte erneute Zustellung dieselbe Delivery-Kennung behält. Unsere frei gewählten Demo-Kennungen bilden nicht diese Schnittstelle nach. Vor einer Integration muss deshalb geklärt werden, welche Kennung eine stabile fachliche Identität besitzt und welche nur einen Transportvorgang beschreibt. Die Bedeutung lässt sich nicht allein aus dem Feldnamen ableiten.
Im Beispiel wird die Quelle fest an den konfigurierten Zugang gebunden. Sie wird nicht aus einem frei gesetzten Mandantenfeld im Ereignis übernommen. Der Verarbeitungsbeleg besitzt einen gemeinsamen eindeutigen Schlüssel aus Quelle und Ereigniskennung. Eine echte Anwendung mit mehreren Anbietern oder Kundenbereichen braucht eine passende maßgebliche Zuordnung. Die Kennung aus einer beliebigen Anfrage darf keine zusätzlichen Zugriffsrechte erzeugen.
GitHub: dokumentierte Zustellkennungen
Den unveränderten Inhalt zuerst authentifizieren
Der Empfänger berechnet einen HMAC über einen festen Zweckbezeichner, die Übermittlungskennung, den Zeitwert und die tatsächlich empfangenen Inhaltsbytes. Erst nach erfolgreichem Vergleich wird das JSON gelesen. Eine nachträgliche Umformatierung der Bytes vor der Prüfung würde den vereinbarten Prüfwert verändern. Sender und Empfänger müssen dasselbe ausdrücklich beschriebene Format verwenden. Der Code nutzt dafür die vorhandene Python-Kryptografiebibliothek.
Dieses Format ist ein eigener begrenzter Lehrvertrag und kein kompatibler GitHub-Endpunkt. Die GitHub-Dokumentation zeigt, warum eine reale Integration die Originalbytes und das dort festgelegte Signaturverfahren beachten muss. Andere Anbieter können andere Header und Regeln verlangen. Ein selbst gewähltes Demo-Feld darf nicht unter dem Namen einer fremden Schnittstelle als bereits funktionsfähige Integration ausgegeben werden.
Der Versuch erzeugt einen eigenen kurzlebigen 32-Byte-Schlüssel. Er wird nicht veröffentlicht und nicht als Teil des Prüfergebnisses gespeichert. Für einen echten Betrieb braucht der Empfänger seinen geregelten geheimen Zugang und eine geschützte Transportverbindung. Die lokale Schleife dieses Beitrags verwendet keine produktiven Anbieterzugänge. Sie prüft den eigenen Annahme- und Verarbeitungskern, nicht die Erreichbarkeit eines externen Webhookdienstes.
Zeitfenster, Bytegrenze und JSON-Vertrag begrenzen
Vor der Verarbeitung gelten eine Grenze von 8192 Bytes und eine bewusst gewählte Zeittoleranz von fünf Minuten. Eine ungültige Signatur oder ein nicht passender Zeitwert führt zur Ablehnung. Das Zeitfenster ist keine dauerhafte Wiederholungssperre. Eine zulässige erneut signierte Übermittlung kann weiterhin dasselbe Ereignis enthalten. Die fachliche Ereignisidentität bleibt deshalb auch nach einer erfolgreichen Authentifizierung notwendig.
Der JSON-Decoder weist doppelte Schlüssel und nicht endliche Sonderzahlen ausdrücklich zurück. Die Ausgabe muss genau Ereigniskennung, Art und Wert enthalten. Nur die Art increment ist zulässig. Der Wert muss eine ganze Zahl von eins bis einhundert sein. Ein Wahrheitswert zählt hier nicht als Ganzzahl und eine Zeichenfolge mit einer Ziffer wird nicht stillschweigend umgewandelt. Die Gegenfälle werden tatsächlich ausgeführt.
Diese engen Regeln dienen dem kleinen fiktiven Zähler. Eine reale Ereignisschnittstelle kann mehr Felder und weitere Ereignisarten brauchen. Jede zusätzliche Art benötigt ihren fachlichen Vertrag. Unbekannte Handlungen sollten nicht allein deshalb ausgeführt werden, weil ein Objekt formal wie JSON aussieht. Der Empfänger muss wissen, welche Bedeutung er tatsächlich unterstützt und welche Eingaben er sichtbar zurückweist.
Wirkung und Beleg in derselben Transaktion speichern
Der Kern beginnt vor der schreibenden Verarbeitung eine unmittelbare SQLite-Transaktion. Innerhalb dieser Transaktion prüft er den vorhandenen Beleg. Fehlt er, wird der Zähler geändert und anschließend der Beleg mit Inhaltsfingerabdruck und Ergebnis gespeichert. Erst danach wird gemeinsam bestätigt. Ein Fehler vor diesem Abschluss setzt beide Änderungen zurück. Es bleibt keine Zähleränderung ohne zugehörigen abgeschlossenen Beleg übrig.
Die unmittelbare Schreibtransaktion serialisiert die konkurrierenden Änderungen im gezeigten SQLite-Aufbau. Zwei gleichzeitig eintreffende Versuche können dadurch nicht beide unabhängig einen fehlenden Beleg sehen und dieselbe Wirkung ausführen. Der zweite erhält nach dem ersten Abschluss den vorhandenen Stand. Zusätzlich beschreibt der eindeutige Datenbankschlüssel die fachliche Identität. Der tatsächliche parallele HTTP-Versuch prüft das Zusammenspiel beider Regeln.
Diese Grenze betrifft ausschließlich die gezeigte lokale Datenbankwirkung. Ein zusätzlicher Mailversand oder ein Auftrag an einen anderen Dienst liegt nicht automatisch in derselben Transaktion. Solche weiteren Wirkungen benötigen einen eigenen verlässlichen Übergang, etwa eine passend entwickelte Outbox mit eigener Verarbeitung. Eine SQLite-Transaktion kann nicht stellvertretend garantieren, dass jedes fremde System dieselbe Änderung genau einmal ausführt.
Wiederholung und widersprüchliche Wiederverwendung unterscheiden
Eine identische Wiederholung findet denselben gespeicherten Inhaltsfingerabdruck und liefert das ursprüngliche Ergebnis zurück. Sie verändert den Zähler nicht. Im Test kommt dasselbe Ereignis unter einer anderen Übermittlungskennung erneut an. Der vorhandene Beleg entscheidet weiterhin über die fachliche Wirkung. Die bloße Zahl der Transportversuche wird nicht zur Zahl neuer Aufträge.
Wird dieselbe Ereigniskennung mit anderen Bytes wiederverwendet, antwortet der Empfänger mit einem Konflikt. Das gilt im bewusst strengen Lehrvertrag auch für semantisch ähnliche JSON-Texte mit anderen Leerzeichen. Die Regel bewahrt die Zuordnung zu den ursprünglichen Bytes. Für einen tatsächlichen Anbieter muss geklärt werden, ob er den Inhalt bei Wiederholungen bytegleich liefert oder eine andere eindeutig definierte Vergleichsform nötig ist.
Ein Konflikt ist kein gewöhnlicher vorübergehender Verarbeitungsfehler. Blindes Wiederholen desselben widersprüchlichen Inhalts löst ihn nicht. Er verlangt eine Prüfung der Ereignisidentität und des erwarteten Vertrags. Eine echte Integration sollte diesen Fall verständlich sichtbar machen und keine späteren Daten stillschweigend über den bereits bestätigten Inhalt schreiben. Der vorhandene Beleg bleibt im Beispiel unverändert maßgeblich.
Den vollständigen Verarbeitungskern nachvollziehen
Der folgende Python-Baustein enthält Authentifizierung, striktes Lesen, Fachvertrag, Transaktion und Verarbeitungsbelege. Die Datenbank ist eine tatsächliche Datei. Jeder Aufruf verwendet eine eigene Verbindung. Der äußere HTTP-Empfänger muss die eingehenden Header und die vollständigen Bytes an diesen Kern übergeben. Die lokale Versuchsanordnung verwendet dafür einen kleinen mehrfädigen Server, veröffentlicht aber keinen produktiven Endpunkt.
Der optionale Aufruf nach der Zähleränderung dient ausschließlich als kontrollierter Fehlerpunkt der eigenen Prüfung. Er stammt aus dem vertrauenswürdigen Testaufbau und nicht aus einem Anfragefeld. Dort kann gezielt ein Fehler vor dem gemeinsamen Abschluss ausgelöst werden. Eine Produktionsintegration benötigt diesen Testhaken nicht als öffentliche Funktion. Die Grenze zwischen Teststeuerung und fremdem Ereignisinhalt bleibt ausdrücklich erhalten.
import hashlib
import hmac
import json
import re
import sqlite3

def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("Doppelter Schlüssel")
        result[key] = value
    return result

def reject_constant(value):
    raise ValueError("Ungültiger Zahlenwert")

class WebhookReceiver:
    def __init__(self, database, secret, after_update=None):
        if not isinstance(secret, bytes) or len(secret) != 32:
            raise ValueError("Demo-Schlüssel muss 32 Bytes lang sein.")
        self.database, self.secret = database, secret
        self.after_update = after_update
        with sqlite3.connect(database) as con:
            con.execute("CREATE TABLE IF NOT EXISTS counter(id INTEGER PRIMARY KEY CHECK(id=1), total INTEGER NOT NULL)")
            con.execute("INSERT OR IGNORE INTO counter VALUES(1,0)")
            con.execute("CREATE TABLE IF NOT EXISTS receipts(source TEXT NOT NULL, event_id TEXT NOT NULL, body_hash TEXT NOT NULL, result INTEGER NOT NULL, PRIMARY KEY(source,event_id))")

    def receive(self, raw, delivery_id, timestamp, signature, now):
        if not isinstance(raw, bytes) or len(raw) > 8192:
            return 413, {"error": "body_size"}
        if (not isinstance(delivery_id,str) or not re.fullmatch(r"[a-z0-9-]{1,64}",delivery_id)
            or not isinstance(timestamp,str) or not re.fullmatch(r"[0-9]{10}",timestamp)
            or not isinstance(signature,str) or not re.fullmatch(r"[0-9a-f]{64}",signature)
            or type(now) is not int or abs(now-int(timestamp)) > 300):
            return 401, {"error": "authentication"}
        material = ("demo-webhook-v1\n"+delivery_id+"\n"+timestamp+"\n").encode()+raw
        expected = hmac.new(self.secret, material, hashlib.sha256).hexdigest()
        if not hmac.compare_digest(expected, signature):
            return 401, {"error": "authentication"}
        try:
            event = json.loads(raw.decode("utf-8"), object_pairs_hook=unique_object, parse_constant=reject_constant)
        except (ValueError, UnicodeDecodeError, RecursionError):
            return 400, {"error": "invalid_json"}
        if (not isinstance(event,dict) or set(event) != {"event_id","kind","value"}
            or not isinstance(event["event_id"],str) or not re.fullmatch(r"evt-[a-z0-9-]{1,40}",event["event_id"])
            or event["kind"] != "increment" or type(event["value"]) is not int
            or not 1 <= event["value"] <= 100):
            return 422, {"error": "event_contract"}
        digest = hashlib.sha256(raw).hexdigest()
        source = "demo-source"  # Bound to this configured secret, never chosen by event JSON.
        con = sqlite3.connect(self.database, timeout=5, isolation_level=None)
        try:
            con.execute("BEGIN IMMEDIATE")
            old = con.execute("SELECT body_hash,result FROM receipts WHERE source=? AND event_id=?",(source,event["event_id"])).fetchone()
            if old:
                con.rollback()
                if old[0] != digest:
                    return 409, {"error": "event_conflict"}
                return 200, {"status": "duplicate", "result": old[1]}
            con.execute("UPDATE counter SET total=total+? WHERE id=1",(event["value"],))
            result = con.execute("SELECT total FROM counter WHERE id=1").fetchone()[0]
            if self.after_update:
                self.after_update(event["event_id"])
            con.execute("INSERT INTO receipts VALUES(?,?,?,?)",(source,event["event_id"],digest,result))
            con.commit()
            return 200, {"status": "applied", "result": result}
        except Exception:
            con.rollback()
            return 503, {"error": "temporary_processing_failure"}
        finally:
            con.close()
Ein gespeichertes Ergebnis ist nicht der spätere Gesamtstand
Das erste Ereignis erhöht den Zähler im Versuch auf drei. Ein anderes Ereignis erhöht ihn später auf sieben. Wenn danach das erste erneut kommt, erhält es weiterhin sein ursprüngliches Ergebnis drei. Der Beleg beschreibt die damalige abgeschlossene Verarbeitung. Er wird nicht stillschweigend durch den gerade aktuellen Gesamtzähler ersetzt. Diese Zuordnung macht eine Wiederholung nachvollziehbar.
Ein tatsächlicher Geschäftsprozess kann einen anderen geeigneten Beleg benötigen, etwa eine Vorgangskennung oder einen eindeutig gespeicherten Ergebnisstatus. Wichtig ist seine stabile Bedeutung. Der Empfänger sollte nicht bei jeder Wiederholung eine neue scheinbar erfolgreiche Bearbeitung erfinden. Eine bereits erfolgte Wirkung wird anhand ihrer vorhandenen Identität bestätigt und kann bei Bedarf über einen gesonderten aktuellen Statusabruf ergänzt werden.
Auch die Aufbewahrung des Belegs hat Folgen. Wird er zu früh gelöscht, kann eine spätere alte Übermittlung wieder wie ein neues Ereignis aussehen. Unser Beispiel löscht keine Belege automatisch. Eine reale Anwendung muss Aufbewahrung, Wiederholungszeitraum und Wiederherstellung gemeinsam planen. Eine Sicherung nur des Zählers ohne die zugehörigen Belege wäre für diesen Vertrag ebenfalls kein vollständiger konsistenter Verarbeitungsstand.
Den Fehler vor dem Abschluss wirklich zurücksetzen
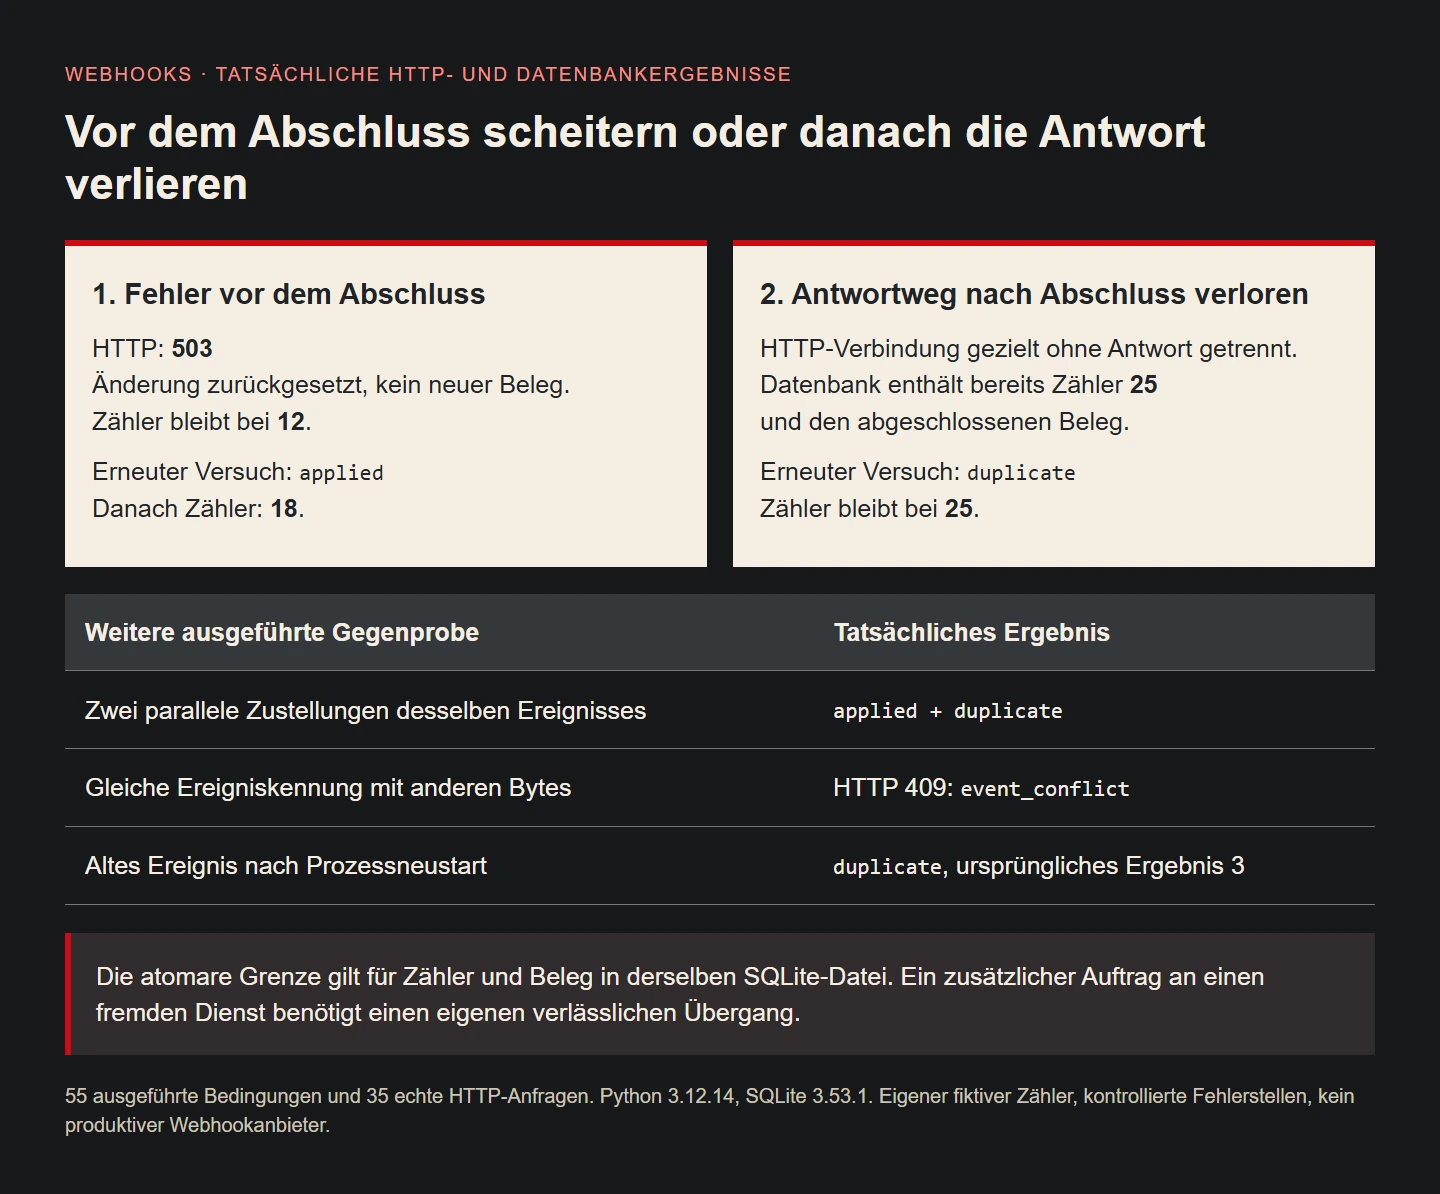
Ein kontrollierter Test bricht nach der Zähleränderung ab, bevor der Beleg eingefügt und die Transaktion bestätigt wird. Der HTTP-Empfänger liefert einen vorübergehenden Fehler zurück. Die anschließende direkte Datenbankkontrolle zeigt den unveränderten vorherigen Zähler und keinen Beleg für dieses Ereignis. Der zunächst ausgeführte Änderungsschritt ist damit nicht als halber Erfolg liegen geblieben.
Der nächste Versuch desselben Ereignisses kann danach regulär arbeiten. Er erzeugt genau die vorgesehene Änderung und einen passenden Beleg. Dieser Ablauf unterscheidet sich vom Konfliktfall mit bereits bestätigten anderen Bytes. Ein vorübergehender Fehler darf einen erneuten Versuch erlauben. Ein Widerspruch in einer vorhandenen Ereignisidentität benötigt dagegen eine fachliche Klärung statt einer unendlichen automatischen Wiederholungsschleife.
Die konkrete Rückmeldung und die Wiederholungsstrategie hängen bei einem echten Anbieter von dessen Vertrag ab. Unser Testempfänger verwendet für den vorübergehenden Fehler Status 503 und einen Retry-After-Hinweis. Daraus wird nicht behauptet, dass jeder fremde Anbieter automatisch genau nach diesem Hinweis handelt. Vor einer Veröffentlichung werden die tatsächlich dokumentierten Antwortfristen und Wiederholungsregeln der gewählten Gegenstelle geprüft.
Eine verlorene Antwort nach dem Abschluss gezielt nachstellen
Ein zweiter kontrollierter Fall lässt die Transaktion erfolgreich abschließen und trennt erst danach die HTTP-Verbindung, ohne eine Antwort zu senden. Der aufrufende Test beobachtet einen verlorenen Rückweg. Eine direkte Datenbankkontrolle findet aber bereits die Zählerwirkung und den Beleg. Dieser Unterschied wäre durch die Aussage Anfrage fehlgeschlagen allein nicht sichtbar geworden.
Die echte erneute HTTP-Zustellung desselben Ereignisses findet den vorhandenen Beleg. Sie gibt duplicate zurück und verändert den Zähler nicht weiter. Damit ist der entscheidende Wiederholungsfall konkret ausgeführt. Der Versuch simuliert den Verlust gezielt an einer bekannten Stelle. Er misst keine zufällige Ausfallquote realer Internetverbindungen und verspricht keine allgemeine fehlerfreie Zustellung über mehrere fremde Systeme.
Anschließend wird der empfangende Prozess beendet und mit derselben Datenbankdatei sowie demselben eigenen Versuchsschlüssel neu gestartet. Ein früheres Ereignis bleibt eine Wiederholung und liefert seinen alten Beleg. Der Nachweis hängt also nicht nur an einem flüchtigen Set im Prozessspeicher. Für den realen Betrieb muss zusätzlich der tatsächliche Wiederherstellungsweg dieser zusammengehörigen Daten und Zugänge geklärt werden.
55 ausgeführte Bedingungen mit 35 HTTP-Anfragen
Die Prüfung verwendet Python 3.12.14 und SQLite 3.53.1. Ihre 55 Bedingungen untersuchen erste Verarbeitung, identische Wiederholung, geänderten Inhalt unter gleicher Kennung, alte Belege nach späteren Änderungen und echte parallele Übermittlung. Fehler vor dem Abschluss, verlorene Antwort nach dem Abschluss und ein Prozessneustart gehören ebenfalls dazu. Die gespeicherten Wirkungen werden jeweils unabhängig aus der Datenbank gelesen.
Weitere Anfragen verwenden falsche Signaturen, unpassende Zeitwerte, beschädigtes JSON, doppelte Schlüssel, ungültige UTF-8-Bytes, Sonderzahlen und falsche Feldtypen. Nicht unterstützte Ereignisart, zusätzliche Eigenschaften, fehlende Felder und übergroßer Inhalt werden zurückgewiesen. Diese Fälle verändern den fachlichen Zähler nicht und erzeugen keinen passenden Verarbeitungsbeleg. Die Summe des kontrollierten Ablaufs bleibt bei fünfundzwanzig.
Die Erklärgrafik verwendet tatsächliche Rückgaben und einen echten gespeicherten Stand nach dem gezielten Antwortverlust. Es wurde kein produktiver Webhookanbieter konfiguriert. Es gibt keinen Lasttest und keine Garantie für alle möglichen Störungen einer Infrastruktur. Der Nachweis gilt für den ausgeführten kleinen Empfänger und die atomare Wirkung in seiner lokalen SQLite-Datei. Genau diese Grenze bleibt auch in der Darstellung sichtbar.
Langsame Arbeit von verlässlicher Annahme trennen
Für längere Aufgaben kann der Empfänger einen geprüften Eingang zunächst dauerhaft annehmen und die eigentliche Arbeit später ausführen. Dann muss seine Antwort genau diese dauerhafte Annahme bedeuten. Eine Nachricht nur im flüchtigen Arbeitsspeicher zu halten und trotzdem eine erfolgreiche Übernahme zu behaupten, würde bei einem Prozessabbruch einen anderen Vertrag liefern. Der tatsächlich zugesagte Zustand muss technisch abgesichert sein.
Unser kleiner Zähler arbeitet dagegen synchron bis zum Datenbankabschluss. Er braucht keine lange Hintergrundarbeit. Eine reale Integration kann eine eigene Inbox oder Warteschlange benötigen, muss dann aber ihre Zustände, Wiederholungen und Übergänge gesondert prüfen. Der Wechsel zu einer anderen Architektur übernimmt nicht automatisch alle Eigenschaften des hier ausgeführten Transaktionsbeispiels. Besonders externe Nebenwirkungen brauchen zusätzliche Aufmerksamkeit.
Eine Betriebsübersicht sollte erkennbar machen, welche Ereignisse abgeschlossen, wiederholt, widersprüchlich oder vorübergehend gescheitert sind. Dabei sind Kennungen und begrenzte Fehlergründe meist hilfreicher als unkontrollierte vollständige Nutzlastkopien. Welche Inhalte tatsächlich protokolliert werden dürfen und benötigt werden, wird für die reale Aufgabe entschieden. Der Versuch speichert ausschließlich seinen eigenen fiktiven Prüfbestand und keine fremden Nutzerdaten.
Die konkrete Anbieteranbindung mit demselben Vertrag abnehmen
Vor einer echten Verbindung werden Ereignisnamen, Signaturverfahren, Kennungen, Antwortfristen und Wiederholungsregeln aus der aktuellen Originaldokumentation übernommen. Die Zielberechtigung wird an den passenden konfigurierten Zugang gebunden. Anschließend folgen erlaubte, ungültige und wiederholte Fälle über den tatsächlichen Integrationsweg. Ein funktionierender eigener Testsender ist dafür eine Grundlage, aber noch kein Beleg für Kompatibilität mit einem fremden Dienst.
Prüfen Sie auch Bestandsänderungen und Wiederherstellung. Ein Empfänger, dessen neue Version andere Felder verlangt, kann ältere Wiederholungen plötzlich zurückweisen. Ein zurückgespielter Datenstand kann zuvor abgeschlossene Ereignisse vergessen. Solche Übergänge gehören in den Betriebsvertrag und dürfen nicht erst bei der nächsten Störung als überraschende Eigenschaft entdeckt werden. Die gespeicherte Ereignisidentität verbindet dabei Technik und fachliche Wirkung.
Ein verlässlicher Webhookablauf unterscheidet Ankunft, Prüfung, dauerhafte Wirkung und Rückmeldung. Er behandelt Wiederholungen als erwartbaren Teil des Vertrages und macht widersprüchliche Identitäten sichtbar. Der vollständige Baustein und seine Gegenversuche helfen, diese Regeln konkret zu verstehen. Die Anwendung übernimmt danach genau die Verantwortung, deren tatsächliche Grenzen sie auch ausgeführt und überprüft hat.
Eine fachliche Reihenfolge nicht aus dem Eintreffen ableiten
Das Beispiel addiert kleine Werte. Es behauptet nicht, dass mehrere verschiedene Ereignisse immer in ihrer fachlichen Reihenfolge eintreffen. Bei einem echten Statuswechsel kann diese Reihenfolge wichtig sein. Eine alte Meldung darf einen neueren freigegebenen Stand nicht ungeprüft überschreiben. Dafür benötigt die Anwendung einen eigenen Vertrag, etwa eine maßgebliche Versionsnummer oder einen aktuellen Abgleich mit dem Ursprungssystem. Die Wiederholungssperre beantwortet diese andere Frage nicht automatisch.
Auch zwei unterschiedliche Ereigniskennungen können dieselbe fachliche Absicht betreffen. Ob sie getrennte Änderungen oder eine gemeinsame Änderung bedeuten, muss aus dem Anbieter- und Geschäftsvertrag hervorgehen. Eine zufällige Ähnlichkeit der Inhalte genügt nicht für eine Zusammenführung. Der gezeigte Baustein behandelt ausschließlich dieselbe stabile Ereignisidentität als Wiederholung. Diese Begrenzung hält seine Wirkung nachvollziehbar und macht sichtbar, welche zusätzlichen Regeln eine tatsächliche Integration noch benötigt.
Die geprüften Fehlerorte unterscheiden
| Fall | Erwarteter Zustand |
|---|---|
| Erstes gültiges Ereignis | Wirkung und Beleg gemeinsam speichern |
| Identisches Ereignis erneut | Alten Beleg ohne neue Wirkung liefern |
| Gleiche Kennung mit anderen Bytes | 409, vorhandenen Stand erhalten |
| Fehler vor Abschluss | 503, Änderung und Beleg zurücksetzen |
| Antwort nach Abschluss verloren | Wirkung bleibt, erneuter Versuch findet Beleg |
| Zwei parallele gleiche Ereignisse | Eine Wirkung und ein Beleg |
| Neustart mit derselben Datei | Frühere Belege weiterhin maßgeblich |
Checkliste für wiederholbare Webhooks
- Stabile Ereignisidentität aus dem tatsächlichen Anbietervertrag ableiten.
- Signatur über die vereinbarten ursprünglichen Bytes prüfen.
- Quelle und Zielberechtigung an maßgeblichen Kontext binden.
- Größe, Zeitfenster, Feldtypen und Ereignisarten begrenzen.
- Wirkung und Verarbeitungsbeleg atomar zusammenführen.
- Identische Wiederholung und widersprüchliche Identität unterscheiden.
- Alte Belege als ursprüngliche Ergebnisse erhalten.
- Fehler vor und nach Abschluss sowie parallele Zustellung tatsächlich prüfen.
- Neustart, Wiederherstellung und Belegaufbewahrung gemeinsam planen.
- Zusätzliche externe Wirkungen mit eigenen verlässlichen Übergängen absichern.
Quellen und Prüfstand
Primärquellen am 09.11.2026 geprüft. Eigener fiktiver Zähler, 55 tatsächlich ausgeführte Bedingungen und 35 HTTP-Anfragen mit Python 3.12.14 und SQLite 3.53.1. Eigenes Demo-Signaturformat, kein produktiver Anbieterendpunkt und keine allgemeine Genau-einmal-Garantie für externe Wirkungen.