SQL-Abfragen verstehen und mit Ausführungsplänen verbessern
Von der fachlichen Liste bis zum tatsächlichen SQLite-Plan: überprüfbare Hypothesen statt pauschaler Geschwindigkeitsversprechen.
Eine SQL-Abfrage wird nicht dadurch gut, dass sie kurz aussieht oder irgendeinen Index verwendet. Sie muss die fachlich richtigen Zeilen liefern und zur tatsächlichen Nutzung passen. Erst danach lässt sich sinnvoll beurteilen, welche Arbeit die Datenbank dafür erledigt. Dieser Leitfaden zeigt einen nachvollziehbaren Ablauf vom Ergebnisvertrag über einen Ausführungsplan bis zu einem gezielt begründeten zusammengesetzten Index. Ein kleines PHP- und SQLite-Beispiel macht die Entscheidungen überprüfbar.
Vor jeder Optimierung den Ergebnisvertrag festlegen
Unsere fiktive Anwendung zeigt die neuesten offenen Aufträge eines ausgewählten Kunden. Die Liste enthält höchstens zwanzig Einträge und benötigt lediglich ID, Erstellungszeit und Betrag. Bei gleichem Erstellungszeitpunkt entscheidet die höhere ID über die Reihenfolge. Diese Beschreibung ist der Ergebnisvertrag. Sie legt fest, was nach einer Änderung weiterhin stimmen muss.
Die Kundenauswahl muss in einer echten Anwendung aus einer bereits geprüften Berechtigung stammen. Ein gebundener Parameter schützt nicht davor, dass eine fremde Kundennummer abgefragt wird. Datenbankabfrage und Zugriffsentscheidung sind unterschiedliche Aufgaben. Unsere Funktion erhält die Kundennummer ausdrücklich als Argument und behauptet nicht, damit eine Anmeldung oder Mandantentrennung vollständig umzusetzen.
Schreiben Sie vor der technischen Arbeit zwei oder drei Gegenbeispiele auf. Ein geschlossener Auftrag desselben Kunden darf nicht erscheinen. Ein offener Auftrag eines anderen Kunden ebenfalls nicht. Zwei Aufträge mit gleicher Zeit dürfen ihre Reihenfolge nicht beliebig tauschen. Solche fachlichen Eigenschaften sind bei der Prüfung hilfreicher als ein bloßer Vergleich der Anzahl zurückgegebener Zeilen.
Das Datenmodell des Lernbeispiels
Die kleine Tabelle verwendet ganzzahlige Zeitwerte in Sekunden und ganzzahlige Centbeträge. Das macht Vergleiche im Beispiel eindeutig. Eine echte Anwendung benötigt zusätzlich eine bewusste Strategie für Zeitzonen, Währungen und zulässige Statusübergänge. Diese Fragen verschwinden nicht durch einen Index. Für unsere Untersuchung genügen die folgenden Spalten und ausdrücklich erfundene Aufträge.
CREATE TABLE orders (
    id INTEGER PRIMARY KEY,
    customer_id INTEGER NOT NULL,
    status TEXT NOT NULL,
    created_at INTEGER NOT NULL,
    total_cents INTEGER NOT NULL
);
Die ID identifiziert einen einzelnen Auftrag. Die Kundennummer verbindet ihn fachlich mit einer Person oder Organisation. Der Status begrenzt die gewünschte Teilmenge. Der Zeitwert bestimmt zusammen mit der ID die Reihenfolge. Der Betrag wird ausgegeben, steuert aber in diesem Vorgang weder Auswahl noch Sortierung. Diese unterschiedlichen Rollen begründen später, welche Spalten der vorgeschlagene Index enthält.
Eine Benennung wie total_cents dokumentiert die Einheit und verhindert zumindest einige Missverständnisse bei der Anzeige. Sie beweist allerdings nicht, dass alle gespeicherten Daten korrekt berechnet wurden. Prüfen Sie bei einer realen Diagnose auch unplausible Werte und fehlende fachliche Einschränkungen, bevor Sie ausschließlich nach Geschwindigkeit suchen.
Die Abfrage zuerst lesbar formulieren
SELECT id, created_at, total_cents
FROM orders
WHERE customer_id = :customer_id
  AND status = :status
ORDER BY created_at DESC, id DESC
LIMIT 20;
Die WHERE-Bedingungen beschreiben gemeinsam die gewünschte Teilmenge. ORDER BY legt die Reihenfolge fest und LIMIT begrenzt die Ausgabe. Die explizite Spaltenliste zeigt, welche Informationen die Oberfläche tatsächlich braucht. Sie verhindert außerdem, dass eine später ergänzte interne Notizspalte automatisch an jeden bisherigen Abnehmer geliefert wird.
Die zweite Sortierspalte ist bewusst gewählt. Viele Aufträge können dieselbe Sekunde als Zeitwert haben. Ohne zusätzlichen eindeutigen Schlüssel ist die Reihenfolge dieser Zeilen nicht fachlich festgelegt. Ein schnellerer Plan kann dann scheinbar ein anderes Ergebnis liefern, obwohl nur eine zuvor unbestimmte Reihenfolge sichtbar wird. Solche Effekte sollten nicht mit einer beschädigten Datenbank verwechselt werden.
Vermeiden Sie beim Lesen die Vorstellung, SQL beschreibe einen festen Programmablauf Zeile für Zeile. Die Datenbank kann unterschiedliche Zugriffswege wählen, solange sie die definierte Bedeutung erfüllt. Unsere Aufgabe ist es, diese Bedeutung klar auszudrücken und anschließend den gewählten Weg zu untersuchen.
Welche Beobachtung beantwortet welche Frage?
| Beobachtung | Hilft bei | Beweist allein nicht |
|---|---|---|
| Ergebnisvergleich | Fachliche Gleichheit und Reihenfolge | Gute Laufzeit unter Last |
| Ausführungsplan | Gewählter Zugriffsweg und Sortierschritte | Geschäftlichen Nutzen einer Änderung |
| Wiederholte Messung | Verhalten unter beschriebenen Bedingungen | Identisches Verhalten jeder Installation |
| Anwendungsbeobachtung | Häufigkeit und Gesamtwirkung | Ursache ohne weitere Untersuchung |
Halten Sie diese Nachweise auseinander. Ein Plan kann erklären, warum ein bestimmter Weg plausibel erscheint. Eine Zeitmessung beschreibt, wie sich eine konkrete Ausführung verhalten hat. Eine häufig ausgeführte mittelgroße Abfrage kann für die Anwendung wichtiger sein als eine sehr langsame seltene Verwaltungsaktion. Die Auswahl des Problems gehört deshalb zur Optimierung.
Mit dem Plan die tatsächliche Hypothese prüfen
SQLite bietet dafür EXPLAIN QUERY PLAN. Für unser Beispiel wird derselbe SELECT mit denselben gebundenen Werten untersucht. Interessant ist, ob die Tabelle durchsucht wird, ob ein bestimmter Index zur Auswahl dient und ob eine zusätzliche temporäre Sortierstruktur verwendet wird. Die genaue Textausgabe ist laut Dokumentation nicht als dauerhaft stabiles Anwendungsformat gedacht.
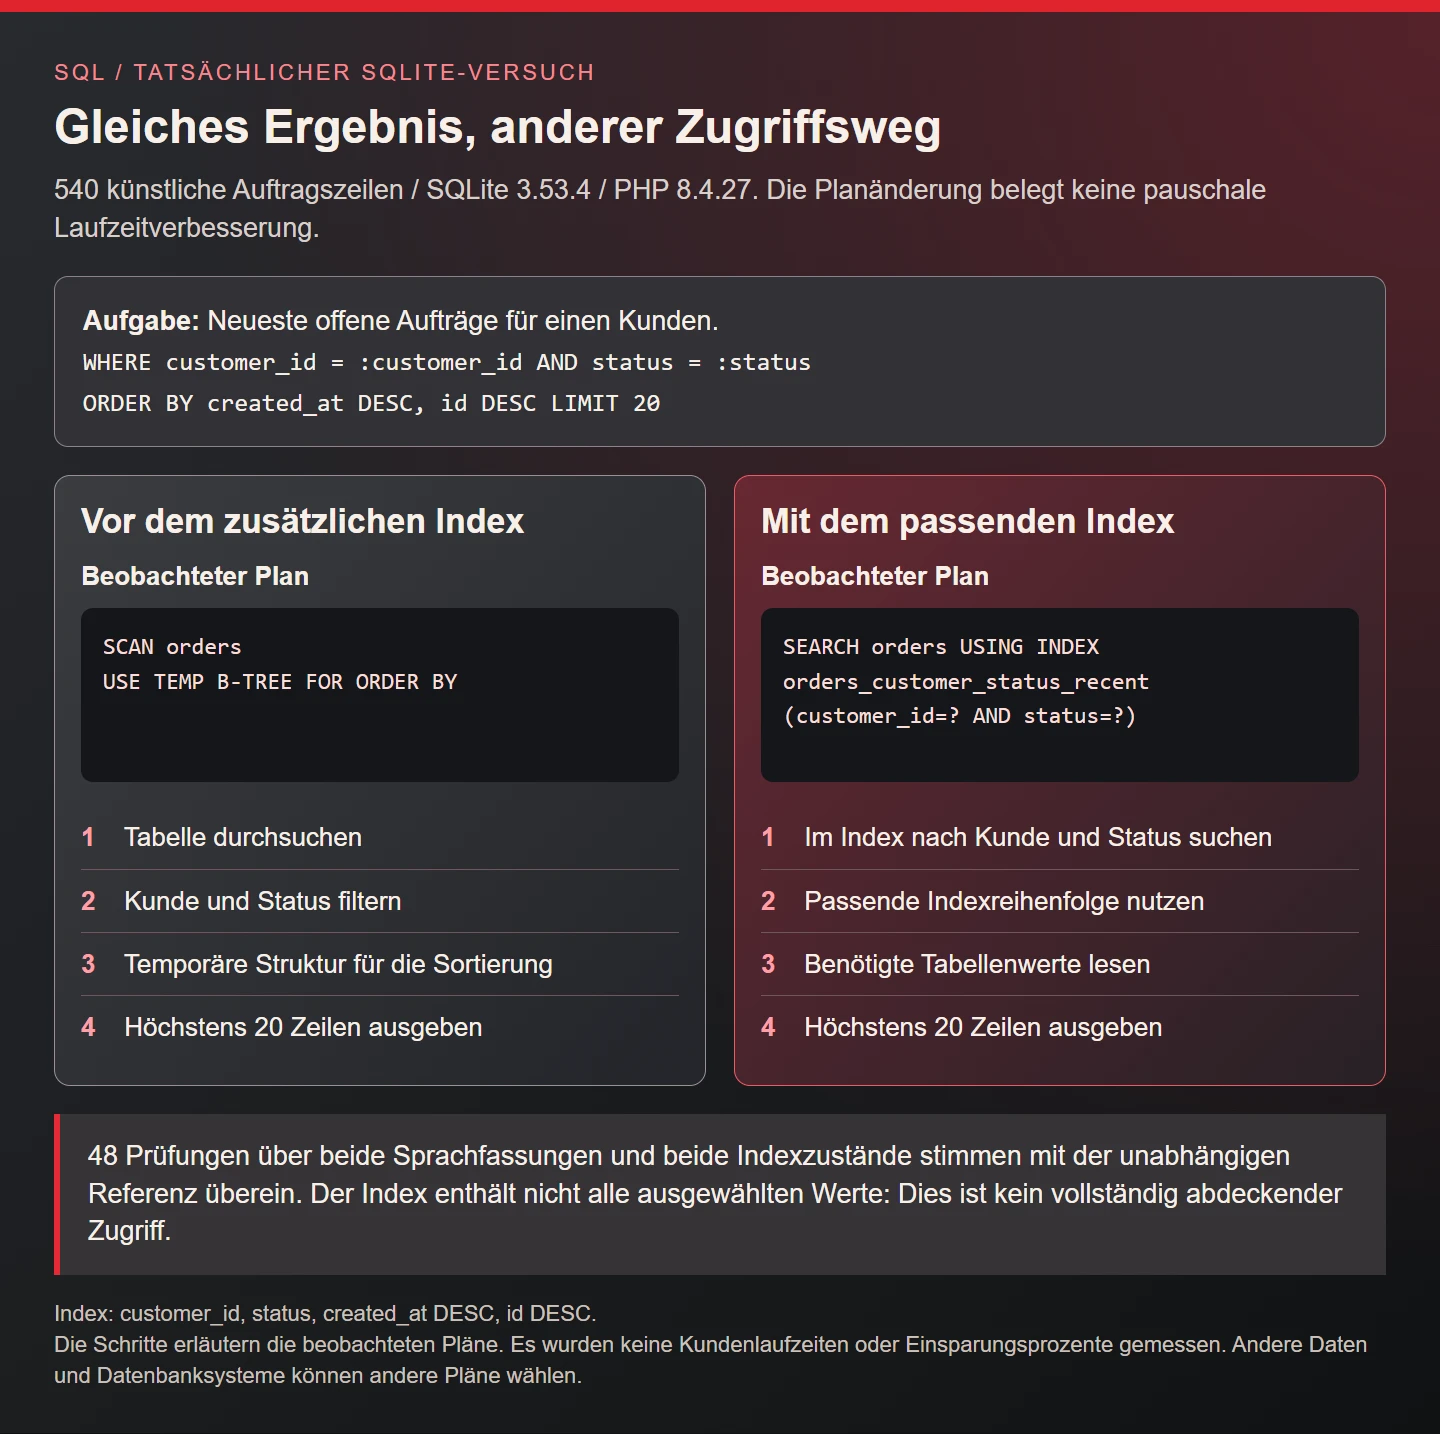
In der künstlichen Prüfdatenbank wurde zuerst ohne den zusätzlichen Index abgefragt. Anschließend wurde nur dieser Index angelegt und dieselbe Abfrage erneut ausgeführt. Ergebnis und Reihenfolge mussten gleich bleiben. Diese gezielte Änderung macht den Zusammenhang überprüfbar. Würden gleichzeitig Datenmodell, Filter und Sortierung geändert, wäre eine abweichende Beobachtung wesentlich schwerer zuzuordnen.
Ein vollständiger Tabellendurchlauf ist nicht automatisch ein Fehler. Wenn eine Tabelle klein ist oder ein großer Anteil ihrer Zeilen gebraucht wird, kann ein solcher Weg sinnvoll sein. Die nützliche Frage lautet, welche Arbeit für den konkreten Zugriff vermeidbar ist. Ein beliebiger Indexname im Plan ist noch kein Qualitätsurteil.
Den zusammengesetzten Index aus der Aufgabe ableiten
CREATE INDEX orders_customer_status_recent
ON orders (customer_id, status, created_at DESC, id DESC);
Die ersten beiden Spalten entsprechen den Gleichheitsbedingungen. Innerhalb dieser Kombination folgen die Sortierspalten in der angeforderten Reihenfolge. Diese Anordnung ist eine begründete Hypothese für unseren festen Listenzugriff. Die SQLite-Dokumentation zur Abfrageplanung erklärt mehrspaltige Indizes und die Verbindung von Suche und Sortierung.
Die Begründung lautet nicht einfach „die wichtigste Spalte zuerst“. Kundennummer, Status und Reihenfolge bilden zusammen das Zugriffsmuster. Eine globale Liste aller offenen Aufträge besitzt ein anderes Muster. Sie kann einen anderen Index benötigen oder mit einer anderen Strategie auskommen. Prüfen Sie deshalb die tatsächlich wichtigen Abfragen gemeinsam, bevor jede einzelne ihren eigenen fast gleichen Index erhält.
Auch die PostgreSQL-Dokumentation zu mehrspaltigen Indizes beschreibt die Bedeutung führender Spalten für B-Baum-Indizes. Daraus folgt keine systemübergreifende Regel, dass spätere Spalten ohne erste Bedingung niemals nutzbar wären. Optimierer besitzen weitere Strategien. Für eine Entscheidung zählt der Plan Ihres Systems mit Ihren Daten.
Das Ergebnis des kleinen Versuchs richtig einordnen
Der Prüfablauf dieses Artikels vergleicht die tatsächlichen SQLite-Pläne vor und nach dem Indexaufbau. Außerdem berechnet er die erwartete Liste unabhängig aus den künstlichen Eingabezeilen. Dadurch genügt es nicht, dass zwei möglicherweise falsche SQL-Ausführungen zufällig übereinstimmen. Die Prüfung betrachtet Kundenzuordnung, Status, Begrenzung und Reihenfolge ausdrücklich.
Die Beobachtung eines anderen Zugriffswegs ist kein erfundener Geschwindigkeitsgewinn. Es wurden keine Prozentwerte für eine Kundenanwendung ermittelt. Eine kurze In-Memory-Demo bildet weder Plattenzugriffe noch gleichzeitige Nutzer oder das Wachstum eines produktiven Bestands vollständig ab. Ihr Wert liegt darin, dass die technische Hypothese nachvollziehbar geprüft wird.
Bewahren Sie bei eigenen Untersuchungen Abfrage, Parameterklasse, Schema, relevante Indizes und Plan gemeinsam auf. Sonst lässt sich später kaum beurteilen, ob ein vermeintlicher Rückschritt durch veränderte Daten, neue Filter oder eine andere Datenbankversion entstanden ist. Vergleiche brauchen einen beschriebenen Kontext.
PDO-Parameter für Werte verwenden
Die folgende Funktion setzt die Abfrage in PHP um. Sie erwartet eine vorbereitete PDO-Verbindung mit geeigneter Fehlerbehandlung. Die Auswahllogik bleibt fest und die beiden Werte werden gebunden. Das PHP-Handbuch zu PDO::prepare() unterscheidet solche Werte ausdrücklich von Bezeichnern und beliebigen SQL-Teilen.
<?php
declare(strict_types=1);

function recentOrders(PDO $db, int $customerId, string $status): array
{
    $stmt = $db->prepare(
        'SELECT id, created_at, total_cents
         FROM orders
         WHERE customer_id = :customer_id
           AND status = :status
         ORDER BY created_at DESC, id DESC
         LIMIT 20'
    );
    $stmt->bindValue(':customer_id', $customerId, PDO::PARAM_INT);
    $stmt->bindValue(':status', $status, PDO::PARAM_STR);
    $stmt->execute();
    return $stmt->fetchAll(PDO::FETCH_ASSOC);
}
Ein Parameter kann daher nicht einfach den Namen einer Sortierspalte ersetzen. Soll die Oberfläche mehrere Sortierungen anbieten, ordnen Sie jeder erlaubten Auswahl einen festen bekannten Ausdruck zu. Das Bindungsverfahren für Kundennummer und Status bleibt davon unberührt. Ungeprüfte Textteile in ORDER BY wären weiterhin selbst zusammengesetztes SQL.
Die PDO-Dokumentation zu vorbereiteten Anweisungen beschreibt den Sicherheitsnutzen gebundener Werte. Sie weist zugleich auf weiterhin gefährliche ungesicherte andere Abfrageteile hin. Für unsere Funktion bedeutet das: Werte sind Werte und Struktur bleibt im Programm festgelegt. Die fachliche Erlaubnis, den ausgewählten Kunden abzufragen, wird zuvor geklärt.
Filter verbessern, ohne ihre Bedeutung zu ändern
Bei Zeiträumen lohnt ein Blick auf die tatsächlich gespeicherte Darstellung. Für unsere ganzzahligen Zeitwerte kann eine Monatsauswahl durch eine untere eingeschlossene und eine obere ausgeschlossene Grenze beschrieben werden. Beide Grenzen werden zuvor passend zur fachlichen Zeitzone berechnet. So muss nicht jede Zeile für die Auswahl zunächst in einen formatierten Monatsnamen umgewandelt werden.
Diese Empfehlung ersetzt keine Prüfung von Sommerzeit oder Zeitzonen. Ein Kalendermonat in einer Geschäftszeitzone ist eine fachliche Definition. Werden seine Grenzen falsch berechnet, kann eine technisch gut indizierbare Abfrage trotzdem die falschen Aufträge liefern. Fügen Sie in diesem Fall gezielte Beispiele direkt an den Grenzen hinzu.
Die SQLite-Übersicht zum Optimierer zeigt verschiedene Strategien für Bedingungen und Indizes. Vermeiden Sie pauschale Aussagen wie „eine Funktion verhindert immer jeden Index“. Ausdrucksindizes und systemspezifische Optimierungen ändern solche Annahmen. Formulieren Sie zunächst eine einfach vergleichbare Alternative und prüfen Sie deren Bedeutung und Plan.
Joins und vervielfachte Zeilen erkennen
Wenn zu jedem Auftrag mehrere Positionen existieren, kann ein Join auf die Positionstabelle denselben Auftrag mehrfach liefern. Ein nachträglich hinzugefügtes DISTINCT mag die sichtbaren Dubletten entfernen, beantwortet aber noch nicht, ob die Abfrage fachlich richtig modelliert wurde. Wird lediglich geprüft, ob eine passende Position existiert, kann eine Existenzbedingung die Absicht deutlicher ausdrücken.
Bei Summen ist die Gefahr besonders groß. Eine zweite Verbindung auf eine weitere Detailtabelle kann Zeilen vervielfachen und Beträge mehrfach zählen. Kontrollieren Sie an einem kleinen von Hand nachvollziehbaren Datensatz, welche Zeile vor der Aggregation wie oft vorkommt. Die Reparatur des Ergebnisses hat Vorrang vor dem Beschleunigen einer falschen Summe.
Für eine Produktionsdiagnose gehören deshalb fachliche Beziehungen in die Untersuchung. Eine Liste mit korrekten Spaltennamen kann trotzdem eine falsche Verknüpfungsbedingung enthalten. Vergleichen Sie einzelne bekannte Fälle und die erwartete Anzahl von Beziehungen, bevor Sie aus dem Plan auf ein reines Indexproblem schließen.
Zu viele einzelne Abfragen als Anwendungsproblem behandeln
Eine Seite kann zunächst zwanzig Aufträge laden und danach für jeden Auftrag einzeln den Kundennamen abfragen. Jede Einzelabfrage mag schnell sein. Die Gesamtzahl und die wiederholten Wege zwischen Anwendung und Datenbank können trotzdem unnötige Arbeit erzeugen. Eine Beobachtung nur der langsamsten einzelnen SQL-Anweisung übersieht diesen Effekt leicht.
Prüfen Sie, ob die benötigten Stammdaten in einer passenden gemeinsamen Abfrage oder in einer gezielten Sammelabfrage geladen werden können. Laden Sie dabei nicht wahllos alle Beziehungen mit. Eine kleine Übersicht braucht möglicherweise weder sämtliche Positionstexte noch die vollständige Änderungshistorie. Die richtige Datenmenge folgt aus der Oberfläche und nicht aus dem maximal verfügbaren Objektmodell.
Notieren Sie im Prüfprotokoll daher auch, wie häufig die Abfrage pro Seitenaufruf ausgeführt wird. Das ist eine andere Messgröße als ihre einzelne Dauer. Eine Änderung sollte beide Aspekte verständlich machen, wenn sie ihren Nutzen aus der Vermeidung wiederholter Arbeit bezieht.
Seitennavigation und stabile Reihenfolge planen
Für die erste Liste begrenzt LIMIT die Ausgabe. Bei vielen Folgeseiten muss die Navigation gesondert geplant werden. Eine große OFFSET-Auswahl kann bedeuten, dass zunächst viele vorherige Einträge durchlaufen und verworfen werden. Ob das praktisch relevant ist, hängt von Datenmenge, Plan und tatsächlicher Nutzung ab. Ein selten verwendetes Verwaltungsarchiv hat andere Anforderungen als ein fortlaufender Arbeitsstrom.
Eine mögliche Alternative ist eine Fortsetzung nach dem letzten gesehenen Paar aus Erstellungszeit und ID. Sie muss exakt zur absteigenden Sortierung passen. Die Eindeutigkeit beider Werte verhindert Mehrdeutigkeit bei gleichen Zeiten. Der Fortsetzungszustand darf aber weder Berechtigungsprüfung noch den ursprünglichen Kundenfilter ersetzen. Ein Cursor ist keine Zugriffserlaubnis.
Berücksichtigen Sie außerdem, was bei zwischenzeitlich eingefügten oder geänderten Aufträgen passieren soll. Eine stabile Sortierregel allein erzeugt noch keine unveränderliche Momentaufnahme über mehrere Seitenaufrufe. Benennen Sie die gewünschte fachliche Erfahrung, bevor Sie zwei Navigationsvarianten ausschließlich anhand ihrer Geschwindigkeit vergleichen.
Indizes haben Kosten im laufenden Betrieb
Ein zusätzlicher Index muss bei relevanten Schreibvorgängen gepflegt werden und belegt Speicher. Für eine selten verwendete Liste kann dieser Aufwand wichtiger sein als eine kleine Verbesserung beim Lesen. Ermitteln Sie deshalb, welche Zugriffe häufig sind, wie viele Änderungen stattfinden und welche bestehenden Indizes ähnliche Aufgaben erfüllen.
Im Beispiel fehlt total_cents bewusst im Index. Die Abfrage muss den Betrag weiterhin aus der Tabelle beziehen. Ein breiterer abdeckender Index wäre eine weitere Hypothese mit anderen Kosten. Sie sollte nicht allein deshalb umgesetzt werden, weil das Wort „abdeckend“ besser klingt. Begrenzen Sie den Versuch und messen Sie die tatsächlich relevante Wirkung.
Der Aufbau eines Index auf einer großen produktiven Tabelle ist zudem ein geplanter Datenbankeingriff. Geeignete Verfahren und mögliche Sperren unterscheiden sich nach System. Entwickeln Sie Migration, Sicherung und Rückweg passend zur Umgebung. Eine erfolgreiche kleine SQLite-Anweisung ist keine allgemeine Betriebsfreigabe für denselben Schritt auf einem stark genutzten Datenbankserver.
EXPLAIN und tatsächliche Ausführung unterscheiden
PostgreSQL dokumentiert EXPLAIN und EXPLAIN ANALYZE getrennt. Die ANALYZE-Variante führt die untersuchte Anweisung tatsächlich aus und ergänzt Laufzeitbeobachtungen. Diese Unterscheidung ist besonders bei schreibenden Anweisungen wesentlich. Ein Diagnoseaufruf darf nicht als folgenlose Beschreibung behandelt werden, wenn er reale Änderungen ausführt.
Auch MySQL 8.4 beschreibt seine EXPLAIN-Varianten mit eigenen unterstützten Formaten und Grenzen. Übertragen Sie weder die genaue Syntax noch die Bedeutung einzelner Ausgabefelder ungeprüft zwischen Systemen. Ein Plan aus SQLite wird nicht durch Umbenennen seiner Spalten zu einem gemessenen PostgreSQL- oder MySQL-Plan.
Führen Sie vertiefte Experimente in einer dafür geeigneten Umgebung durch. Für den Vergleich interessieren repräsentative Datenverteilungen und Parameter, nicht nur die Gesamtzahl der Zeilen. Ein sehr großer Kunde und viele kleine Kunden können denselben Tabellenumfang mit völlig anderen Zugriffseigenschaften erzeugen.
Eine kompakte Diagnosematrix
| Symptom | Erste Untersuchung | Möglicher nächster Versuch |
|---|---|---|
| Falsche Summe | Join-Vervielfachung und Filter | Beziehungen vor Aggregation klären |
| Aufwendige sortierte Liste | Filter, Reihenfolge und Plan | Passenden zusammengesetzten Index prüfen |
| Viele kurze Abfragen | Aufrufe pro Oberfläche | Gezielte Sammelabfrage untersuchen |
| Späte Seiten werden träge | OFFSET und Nutzung | Passende Fortsetzungsnavigation vergleichen |
| Schreibvorgänge verschlechtern sich | Indexbestand und Änderungen | Unnötige ähnliche Indizes bewerten |
Die Matrix ist eine Orientierung und keine automatische Diagnose. Halten Sie für jeden Versuch die ursprüngliche Beobachtung, die fachliche Erwartung und die geänderte technische Annahme fest. So bleibt auch ein verworfener Ansatz nützlich, weil er eine konkrete Frage beantwortet hat.
Den Nutzen nach der Änderung kontrollieren
Nach einer erfolgreichen Einzelprüfung beginnt die Beobachtung im vorgesehenen Arbeitsablauf. Prüfen Sie beispielsweise, ob die Übersicht tatsächlich schneller verfügbar ist oder ob der wahrgenommene Engpass in einer ganz anderen Komponente liegt. Eine zusätzliche Netzwerkabfrage, eine große Antwort oder eine aufwendige Darstellung kann den Nutzen einer verbesserten SQL-Anweisung überdecken. Diese Beobachtung macht die Datenbankarbeit nicht wertlos, ordnet sie aber in den gesamten Seitenaufruf ein.
Vereinbaren Sie vor der Übernahme, welche fachlichen und technischen Bedingungen weiter gelten müssen. Dazu gehören korrekte Ergebnisse, passende Zugriffsrechte und ein vertretbarer Schreibaufwand. Halten Sie auch einen Rückweg bereit, falls sich eine Annahme unter der echten Nutzung als unzutreffend erweist. Eine Optimierung ist eine überprüfbare Änderung und kein endgültiges Urteil über jede spätere Datenverteilung.
Checkliste für eine nachvollziehbare Verbesserung
- Ergebnis, Filter und eindeutige Reihenfolge sind beschrieben.
- Berechtigungen werden unabhängig vom Parameterbinden geprüft.
- Die Ausgangsabfrage und repräsentative Werte sind gesichert.
- Der Plan wird für das tatsächlich eingesetzte System gelesen.
- Eine Änderung prüft eine verständliche Hypothese.
- Ergebnisgleichheit wird mit fachlichen Gegenbeispielen kontrolliert.
- Messung und Planbeobachtung werden nicht verwechselt.
- Aufrufhäufigkeit und Gesamtwirkung sind berücksichtigt.
- Schreibkosten, Indexaufbau und Rückweg sind geplant.
- Der Nachweis nennt Umgebung und Grenzen statt pauschaler Erfolgsprozente.
Häufige Fragen zur SQL-Optimierung
Braucht jede Filterspalte einen eigenen Index? Nein. Entscheidend sind die tatsächlich gemeinsam verwendeten Bedingungen und Sortierungen. Mehrere einzelne Indizes sind nicht automatisch gleichwertig mit einem passend zusammengesetzten Index. Lesen Sie den konkreten Plan.
Ist SELECT * immer falsch? Eine explizite Auswahl macht unsere Schnittstelle verständlich und begrenzt die Ausgabe. Daraus folgt kein universelles Verbot. Beurteilen Sie benötigte Daten, Kopplung und Übertragung für den konkreten Abnehmer.
Kann man aus einem besseren Plan eine feste Beschleunigung ableiten? Ein anderer Zugriffsweg begründet eine Hypothese. Eine belastbare Laufzeitaussage braucht Messungen unter beschriebenen Bedingungen. Die hier geprüfte Demo verspricht keine bestimmte Verbesserung für fremde Datenbanken.