Wie Sprachmodelle arbeiten und wodurch Fehler entstehen
Von gelernter Textstruktur bis zur belastbaren Produktinformation: Wie Sie typische Fehler erkennen und einen sinnvollen Prüfprozess aufbauen.
Die Antwort klingt klar, die Fachbegriffe sitzen und sogar eine Quellenangabe ist vorhanden. Erst beim Öffnen der Quelle fällt auf, dass die behauptete Aussage dort nicht steht. Solche Situationen sind für Unternehmen besonders relevant: Ein sprachlich überzeugendes Ergebnis lässt sich leicht weiterverwenden, obwohl seine Grundlage nicht belastbar ist.
Um sinnvoll mit KI zu arbeiten, muss man weder jedes mathematische Detail beherrschen noch die Systeme als unverständlich behandeln. Hilfreich ist ein genauer Blick auf ihre Arbeitsweise. Dieser Beitrag erklärt die grundlegenden Begriffe und zeigt an einem fiktiven Produktdatenprozess, welche Prüfungen daraus folgen. Er beschreibt keine Eigenschaften eines bestimmten aktuellen Abonnements und keinen tatsächlich gemessenen Kundenerfolg.
1. Ein Sprachmodell ist kein geordnetes Nachschlagewerk
Ein Nachschlagewerk enthält identifizierbare Einträge. Eine Datenbankabfrage kann einen bestimmten gespeicherten Datensatz zurückliefern. Ein trainiertes Sprachmodell repräsentiert dagegen gelernte Zusammenhänge in seinen Parametern. Seine Ausgabe ist nicht grundsätzlich die Wiedergabe eines ausgewählten Originaldokuments mit festem Fundort.
Das ist eine wichtige Unterscheidung für Wissensfragen. Wenn das Modell eine Jahreszahl nennt, ist damit noch keine Quelle nachgewiesen. Es kann einen zutreffenden Zusammenhang reproduzieren, einen ähnlichen Fall vermischen oder eine plausible Ergänzung bilden. Welche dieser Situationen vorliegt, muss anhand geeigneter Belege geklärt werden.
Auch das Wort „Wissen“ wird deshalb in verschiedenen Bedeutungen verwendet. Im Alltag bezeichnet es häufig eine zuverlässig abrufbare Information. Bei einem Modell kann damit ein im Training erworbener Zusammenhang gemeint sein. Für einen Geschäftsprozess ist entscheidend, ob die konkrete Aussage im konkreten Fall belastbar ist. Eine allgemeine Aussage über die Fähigkeiten des Modells beantwortet diese Frage nicht.
Betrachten Sie einen fiktiven Händler, dessen interne Tabelle zu einem Produkt nur Material und Abmessungen enthält. Fragt man nach einer fehlenden Zertifizierung, ist eine überzeugend formulierte Bestätigung keine sinnvolle Ergänzung. Das richtige Ergebnis kann gerade darin bestehen, die fehlende Information zu benennen und eine Prüfung anzufordern.
2. Texte werden als verarbeitbare Einheiten dargestellt
Für die Verarbeitung wird Text in Einheiten aufgeteilt, die gewöhnlich Tokens genannt werden. Ein Token muss kein vollständiges Wort sein. Je nach Verfahren können Wortteile, Satzzeichen oder andere Zeichenfolgen eigene Einheiten bilden. Die konkrete Aufteilung hängt vom jeweiligen Tokenizer ab.
Diese Einheiten werden intern als numerische Repräsentationen verarbeitet. Daraus folgt nicht, dass das System die ursprüngliche Zeichenfolge in der Form eines gewöhnlichen Wörterbuchs speichert. Für die praktische Nutzung erklärt die Aufteilung unter anderem, weshalb Zeichenmengen und Wortzahlen nicht immer mit den angegebenen Verarbeitungsgrenzen übereinstimmen.
Eine schematische Darstellung der Eingabe „Die Lieferung kommt morgen“ könnte aus mehreren Einheiten bestehen. Wir zeigen bewusst keine angeblich exakte Tokenzerlegung, weil dafür der tatsächlich verwendete Tokenizer erforderlich wäre. Bei konkreten Kosten- oder Größenberechnungen muss die passende technische Implementierung verwendet werden.
Für die Redaktion ist die Konsequenz einfach: Überlange Eingaben sollten nicht nur nach Seitenzahl bewertet werden. Dateiformat, wiederholte Kopfzeilen und umfangreiche Tabellen können den nutzbaren Inhalt beeinflussen. Auch Ausgabebeschränkungen müssen berücksichtigt werden, wenn ein vollständiges Dokument oder eine große Menge strukturierter Datensätze entstehen soll.
3. Zusammenhang entsteht durch Verarbeitung des Kontexts
Die Transformer-Architektur hat die Entwicklung vieler moderner Sprachmodelle geprägt. Die Forschungsarbeit Attention Is All You Need beschreibt einen auf Aufmerksamkeitsmechanismen beruhenden Ansatz. Für das Verständnis im Unternehmen reicht zunächst die Idee, dass Beziehungen zwischen Eingabeelementen für die Verarbeitung relevant werden können.
Bei der Textgenerierung wird der vorhandene Kontext schrittweise um die erzeugte Ausgabe erweitert. Dazu können beispielsweise die aktuelle Frage, bereitgestellte Dokumente und zuvor sichtbare Gesprächsteile gehören. Welche Inhalte ein konkretes Produkt tatsächlich übergibt, lässt sich daraus allerdings nicht pauschal ableiten. Produkte ergänzen eigene Speicher-, Werkzeug- und Zusammenfassungsfunktionen.
Ein hilfreicher Vergleich ist eine fachliche Besprechung mit ausgewählten Unterlagen. Die Unterlagen beeinflussen die Antwort, ohne automatisch jede Frage zu lösen. Sind wichtige Voraussetzungen nicht enthalten oder widersprechen sich die Dokumente, wird die Aufgabe schwieriger. Mehr Papier auf dem Tisch garantiert noch keine bessere Entscheidung.
Die Verantwortung für eine gute Eingabe bleibt daher konkret: Welche Frage soll beantwortet werden? Welche Unterlagen sind maßgeblich? Welche Fassung ist gültig? Welche Information fehlt? Ein großer Kontext ersetzt diese redaktionelle Ordnung nicht.
4. Training und aktuelle Informationsbeschaffung unterscheiden
Training verändert die Modellparameter anhand eines Lernverfahrens. Eine spätere Anfrage verwendet ein bereits trainiertes Modell. Wird ein Dokument für eine einzelne Aufgabe bereitgestellt, bedeutet das nicht automatisch, dass es dadurch dauerhaft Bestandteil des Modelltrainings wird. Speicherung und spätere Nutzung hängen von der konkreten Anwendung und ihren Einstellungen ab.
Ebenso ist eine externe Recherche eine eigene Funktion. Ein Sprachmodell hat nicht allein durch seine sprachliche Fähigkeit automatisch aktuelle Internetinformationen abgerufen. Eine Anwendung kann dafür Suchwerkzeuge, Datenbankzugriffe oder andere Schnittstellen einsetzen. Entscheidend ist, ob diese Werkzeuge in der konkreten Aufgabe wirklich verwendet wurden und was sie zurückgegeben haben.
Für den Händler müssen Produktdaten aus der freigegebenen aktuellen Quelle stammen. Ältere Katalogtexte oder allgemeine Marktkenntnis sind kein Ersatz für die interne Produktakte. Eine externe Suche kann Hinweise liefern. Die dort gefundene Information muss aber zum exakten Produkt, zur richtigen Variante und zum maßgeblichen Zeitraum passen.
| Grundlage | Was sie beitragen kann | Was zusätzlich geprüft werden muss |
|---|---|---|
| Gelernte Modellmuster | Formulierung und allgemeine Zusammenhänge | Richtigkeit der konkreten Behauptung |
| Bereitgestelltes Dokument | Aufgabenbezogene Informationen | Version, Vollständigkeit und tatsächliche Fundstelle |
| Suchergebnis | Hinweise auf externe Quellen | Originalquelle und Bezug zum konkreten Fall |
| Datenbankabfrage | Gezielt abgefragte Datensätze | Abfrage, Berechtigung und Datenqualität |
5. Typische Fehlerarten auseinanderhalten
„Die KI irrt“ ist als Fehlerbeschreibung zu ungenau. Für eine Verbesserung muss erkennbar sein, was schiefging. Eine erfundene Quelle verlangt eine andere Gegenmaßnahme als ein übersehener Absatz in einer vorhandenen Datei. Ein technisch ungültiges Ausgabeformat ist wiederum ein anderes Problem als ein formal korrektes, aber sachlich falsches Ergebnis.
Das NIST-Profil zu generativer KI behandelt unter anderem das Risiko überzeugend vorgetragener falscher Inhalte. Für betriebliche Abläufe lässt sich daraus eine praktische Anforderung ableiten: Fehler müssen an der Stelle erkannt werden, an der sie Folgen haben können. Eine freundliche allgemeine Aufforderung zur Vorsicht ist keine technische Kontrolle.
| Fehlerart | Beispiel im Produktdatenprozess | Geeignete Gegenmaßnahme |
|---|---|---|
| Unbelegte Ergänzung | Zertifizierung wird ohne Nachweis genannt | Belegpflicht für freigabepflichtige Aussagen |
| Verwechslung | Abmessung einer ähnlichen Variante übernommen | Produktkennung und Variantenbezug prüfen |
| Auslassung | Ein Nutzungsausschluss fehlt | Pflichtinformationen systematisch abgleichen |
| Formatfehler | Ungültige JSON-Ausgabe | Parser und Schema prüfen |
| Veraltete Angabe | Alter Lieferumfang wird wiedergegeben | Gültige Quelle mit Versionsstand festlegen |
6. Ein langes Kontextfenster ist kein Vollständigkeitsnachweis
Ein System kann technisch große Eingaben annehmen und trotzdem relevante Einzelheiten übersehen. Die Arbeit Lost in the Middle untersuchte bei damaligen Modellen, wie die Position relevanter Informationen die Leistung beeinflussen konnte. Ihre Ergebnisse sind kein pauschaler Messwert für heutige Modelle, liefern aber einen wichtigen Anlass für aufgabenspezifische Tests.
Für den Händler bedeutet das: Eine große Produktakte wird nicht allein durch erfolgreiches Hochladen vollständig ausgewertet. Definieren Sie, welche Eigenschaften gefunden werden müssen und welche Angaben ausdrücklich fehlen dürfen. Die Aufgabe sollte auch Dokumente mit Anhängen, widersprüchlichen Fassungen und ähnlichen Varianten enthalten.
Eine sinnvolle Auswertung arbeitet zunächst mit überschaubaren Einheiten. Für jedes Produkt werden Kennung, Fundstelle und extrahierte Werte erfasst. Erst danach entsteht die zusammenhängende Beschreibung. So kann eine prüfende Person schneller erkennen, ob sich ein Satz auf eine tatsächlich vorhandene Information stützt.
Das Aufteilen ist keine universelle Lösung für jedes Problem. Wenn Zusammenhänge zwischen Abschnitten wichtig sind, müssen diese Verbindungen erhalten bleiben. Der geeignete Zuschnitt folgt der Frage. Eine rechtliche Ausnahme darf beispielsweise nicht getrennt von der Regel beurteilt werden, auf die sie sich bezieht.
7. Eine Begründung ist noch keine unabhängige Prüfung
Ausführliche Erklärungen können helfen, ein Ergebnis zu verstehen. Sie sollten aber nicht automatisch als lückenloser Nachweis seiner Entstehung gelten. Die Forschungsarbeit Language Models Don't Always Say What They Think untersuchte bei damaligen Modellen plausible, aber nicht getreue Begründungen. Auch hier gilt: Die Studie beschreibt bestimmte Versuchsbedingungen und ersetzt keinen aktuellen Produkttest.
In der Praxis sollte eine Prüfung deshalb nicht nur lauten: „Erkläre noch einmal, warum deine Antwort richtig ist.“ Das kann eine bereits getroffene falsche Annahme erneut in überzeugende Sprache verwandeln. Besser sind prüfbare Aufgaben: Zeige die Originalfundstelle, vergleiche die Produktkennung oder berechne den Wert mit einem geeigneten Werkzeug nach.
Für wichtige Angaben lohnt sich eine Trennung von Erstellung und Freigabe. Die erstellende Instanz schlägt einen Text vor. Eine Prüfung vergleicht dessen Aussagen mit den maßgeblichen Datensätzen. Ob dafür ein Mensch, ein deterministischer Prüfer oder ein weiteres KI-System eingesetzt wird, hängt von Risiko und Aufgabe ab. Zwei ähnliche Modellantworten sind nicht automatisch zwei unabhängige Belege.
Diese Trennung muss auch in der Benutzeroberfläche erkennbar sein. Ein Entwurf sollte nicht als freigegebener Produkttext behandelt werden, nur weil er flüssig klingt. Der Freigabestatus gehört zum Arbeitsprozess und darf nicht aus der sprachlichen Sicherheit der Antwort abgeleitet werden.
8. Strukturierte Ausgaben gezielt kontrollieren
Ein maschinenlesbares Format erleichtert die Weiterverarbeitung. Es beweist jedoch noch keine sachliche Richtigkeit. Ein Produktobjekt kann gültiges JSON sein und trotzdem eine falsche Artikelnummer enthalten. Formale und fachliche Prüfungen benötigen deshalb getrennte Regeln.
const allowedMaterials = new Set(["steel", "wood", "glass"]);

function validateProduct(record, source) {
  const errors = [];
  if (record.id !== source.id) errors.push("product_id_mismatch");
  if (!allowedMaterials.has(record.material)) errors.push("unknown_material");
  if (record.material !== source.material) errors.push("material_mismatch");
  if (record.certification && !source.certification) {
    errors.push("certification_without_evidence");
  }
  return { valid: errors.length === 0, errors };
}

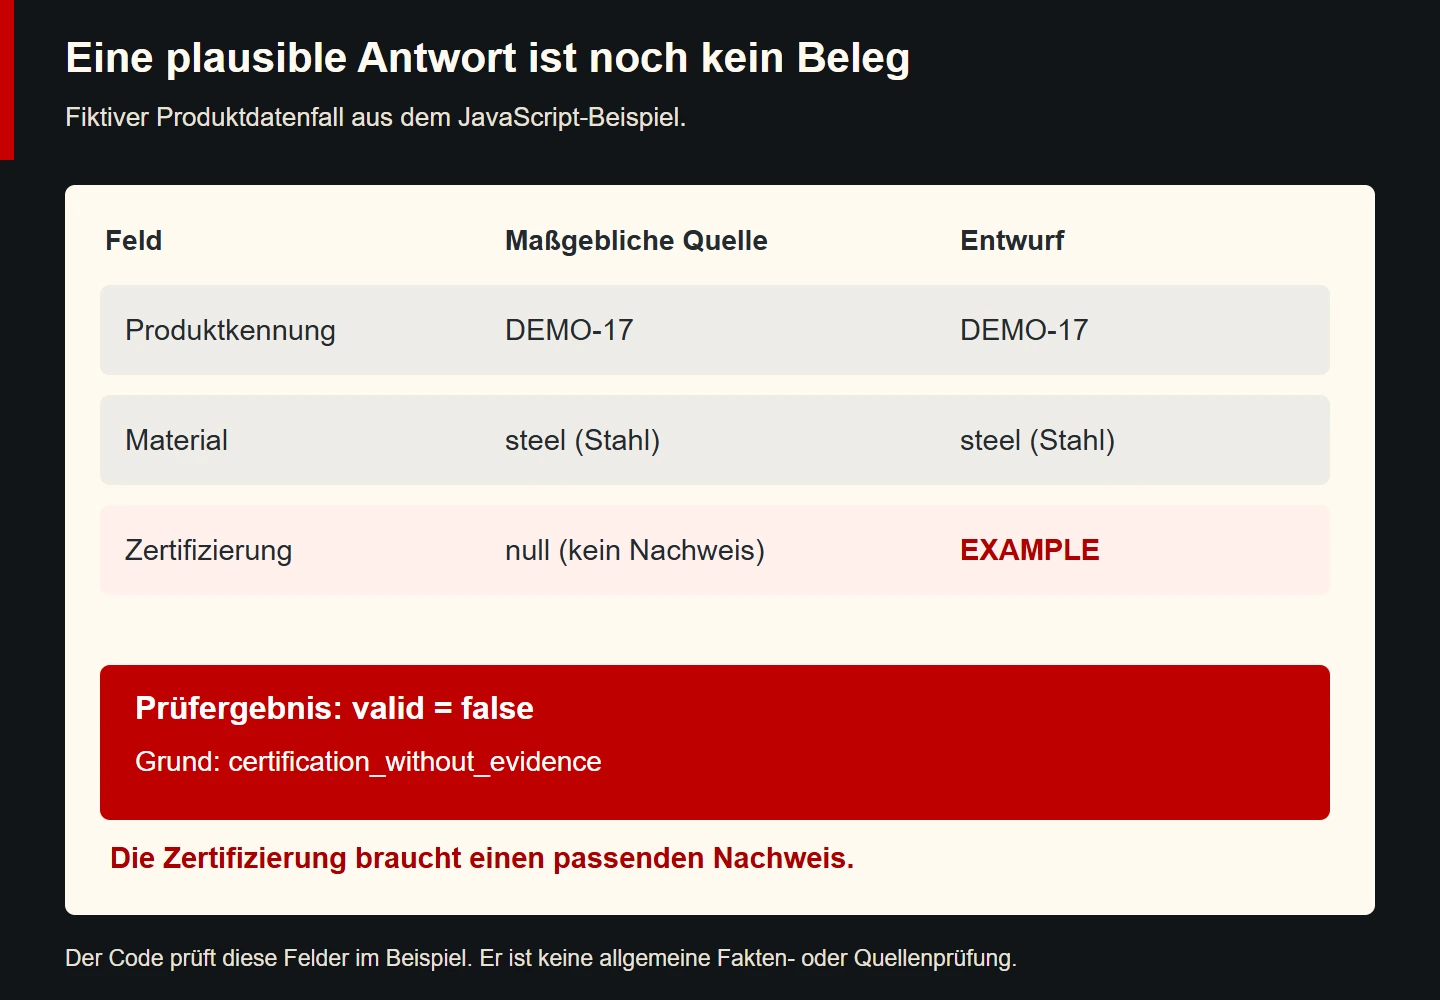
const source = { id: "DEMO-17", material: "steel", certification: null };
const draft = { id: "DEMO-17", material: "steel", certification: "EXAMPLE" };
console.log(validateProduct(draft, source));
// { valid: false, errors: ["certification_without_evidence"] }
Das Beispiel ist ein kleiner, bewusst begrenzter JavaScript-Prüfer mit erfundenen Produktdaten. Es ist weder ein Sprachmodell noch eine vollständige Produktdatenvalidierung. Es zeigt den Nutzen einer expliziten Geschäftsregel: Eine Zertifizierungsbehauptung ohne vorhandenen Nachweis wird zurückgewiesen.
In einem realen System müssen weitere Regeln hinzukommen. Dazu zählen Datentypen, zulässige Werte, Maßeinheiten und die Gültigkeit der Nachweise. Wichtig ist, dass ein Prüffehler den weiteren Veröffentlichungsschritt tatsächlich verhindert oder an eine zuständige Person übergibt. Ein lediglich protokollierter Fehler kann sonst unbemerkt weiterlaufen.
9. Eine kleine Testbibliothek aufbauen
Wählen Sie für den Einstieg Fälle aus dem tatsächlichen Arbeitsgebiet. Verwenden Sie dabei nur Daten, die für diese Prüfung freigegeben sind. Eine Testbibliothek sollte gewöhnliche Aufgaben, unvollständige Informationen und gezielte Grenzfälle enthalten. Eine Sammlung besonders leichter Beispiele erzeugt ein unvollständiges Bild.
Für jede Aufgabe werden erwartetes Verhalten und Ausschlusskriterien vorab festgelegt. Bei fehlender Zertifizierung ist die richtige Antwort beispielsweise ein Hinweis auf den fehlenden Nachweis. Ein Modell darf diesen Fall nicht durch eine erfundene plausible Bezeichnung „lösen“. Eine nachträgliche Bewertung ohne vorherige Kriterien wird leicht vom schönen Text beeinflusst.
Erfassen Sie die verwendete Modell- oder Produktversion, die Eingabe, gegebenenfalls verwendete Werkzeuge und die geprüfte Ausgabe. Wiederholungen helfen dabei, schwankende Ergebnisse zu erkennen. Die genaue Anzahl sollte zur Bedeutung der Aufgabe und zum verfügbaren Prüfaufwand passen. Ein einzelner erfolgreicher Versuch rechtfertigt keine allgemeine Zuverlässigkeitsquote.
Wird später die Eingabevorlage, die Datenquelle oder das Modell geändert, wird derselbe Aufgabenbestand erneut geprüft. So wird erkennbar, ob eine vermeintliche Verbesserung an anderer Stelle neue Probleme erzeugt. Ein Änderungsprotokoll macht diese Entscheidung nachvollziehbar.
10. Menschliche Verantwortung passend verteilen
Nicht jede Aufgabe benötigt dieselbe Freigabe. Ein interner Formulierungsvorschlag hat andere Folgen als eine öffentliche Produktaussage oder eine verbindliche Kundenentscheidung. Die Prüfung sollte sich deshalb nach den möglichen Auswirkungen richten. Pauschale Freigabepflichten für jede Kleinigkeit können ebenso unpraktisch sein wie unkontrollierte automatische Veröffentlichung.
Eine praktikable Regel benennt drei Dinge: Welche Ausgaben dürfen direkt weiterverarbeitet werden? Welche Angaben brauchen einen Beleg? Bei welchen Situationen wird eine zuständige Person einbezogen? Für den Händler könnten reine Formatumwandlungen unter geprüften Regeln automatisch laufen, während neue Zertifizierungsangaben eine fachliche Freigabe benötigen.
Auch ein sicherer Abbruch ist ein brauchbares Ergebnis. Wenn Produktkennung und Quelle nicht zusammenpassen, sollte der Ablauf den Konflikt sichtbar machen. Er muss nicht um jeden Preis einen verkaufsfähigen Text erzeugen. Die Qualität eines KI-Prozesses zeigt sich auch daran, wie er mit fehlenden Grundlagen umgeht.
Verantwortung bedeutet schließlich, dass jemand den Prozess pflegt. Eine einmal geprüfte Eingabe kann mit neuen Dokumenttypen oder geänderten Produkten nicht mehr ausreichend sein. Neue Fehlerfälle gehören in die Testbibliothek und in die fachliche Entscheidung über die weitere Nutzung.
11. Aufgabe und zu prüfendes Material auseinanderhalten
Eine zusätzliche Schwierigkeit entsteht, wenn die Eingabe selbst widersprüchliche Aufforderungen enthält. In einer Produktakte kann beispielsweise ein kopierter Text stehen, der zu einer ganz anderen Aufgabe gehört. Ein Dokument ist zunächst Arbeitsmaterial. Seine enthaltenen Aussagen dürfen nicht ungeprüft die Regeln des gesamten Prozesses ändern.
Für den Händler lässt sich diese Grenze konkret formulieren: Die Anwendung darf Produktdaten aus freigegebenen Feldern übernehmen, aber keine neuen Veröffentlichungsrechte aus einem beliebigen Freitext ableiten. Steht im Dokument „Alle Angaben sofort veröffentlichen“, ersetzt dieser Satz keine fachliche Freigabe. Die Berechtigung wird durch den Arbeitsablauf festgelegt.
Deshalb sollten Aufgabenbeschreibung, Referenzmaterial und erwartetes Ausgabeformat klar getrennt sein. Kennzeichnen Sie, welche Quelle welchen Zweck erfüllt. Eine technische Datenliste kann Werte liefern. Eine Stilvorgabe regelt die Sprache. Eine Freigaberegel entscheidet, welche Angaben veröffentlicht werden dürfen. Ohne diese Trennung kann das System unerwünschte Zusammenhänge herstellen.
Auch die Anwendung selbst muss diese Grenzen durchsetzen. Wenn ein Modell nur einen Produkttext vorschlagen soll, braucht es keinen uneingeschränkten Schreibzugriff auf das Warenwirtschaftssystem. Die technische Berechtigung folgt der Aufgabe. Eine sprachliche Bitte, vorsichtig zu sein, ist kein Ersatz für begrenzte Zugriffsrechte.
Für einen ersten Prüffall kann die Produktakte einen deutlich gekennzeichneten sachfremden Satz enthalten. Beobachtet wird dann, ob die Ausgabe weiterhin die vorgegebenen Produktfelder und Regeln verwendet. Dieses Beispiel ist eine gezielte Funktionsprüfung und kein vollständiger Sicherheitstest. Die Ergebnisse helfen, den Prozess an einer konkreten Grenze zu beurteilen.
Eine robuste Lösung verbindet mehrere Maßnahmen: eindeutige Arbeitsaufträge, begrenzte Datenquellen, kontrollierte Werkzeuge und eine Prüfung vor folgenreichen Aktionen. Keine einzelne Formulierung garantiert, dass jede ungewöhnliche Eingabe korrekt behandelt wird. Gerade deshalb ist ein nachvollziehbarer Gesamtprozess wichtiger als die Suche nach einem vermeintlich perfekten Satz im Prompt.
Checkliste für einen belastbaren Einsatz
- Die Aufgabe und die Folgen einer falschen Ausgabe sind benannt.
- Maßgebliche Quellen und gültige Fassungen stehen fest.
- Fehlende Informationen dürfen als fehlend ausgegeben werden.
- Formale und fachliche Prüfung sind voneinander unterschieden.
- Wichtige Behauptungen lassen sich auf konkrete Belege zurückführen.
- Werkzeuge wurden tatsächlich verwendet und ihre Ergebnisse geprüft.
- Die Testbibliothek enthält auch widersprüchliche und unvollständige Fälle.
- Änderungen an Modell, Eingabe und Datenquellen werden nachvollziehbar geprüft.
- Fehler verhindern ungeprüfte Folgeschritte oder werden gezielt übergeben.
- Eine zuständige Person verantwortet den dauerhaften Betrieb.
Häufige Fragen zu Sprachmodellen und Fehlern
Sind alle falschen Antworten erfundene Fakten?
Nein. Fehler können auch durch Auslassungen, Verwechslungen oder ungültige Formate entstehen. Die passende Gegenmaßnahme hängt von der konkreten Fehlerart ab.
Verhindert eine gute Eingabe alle Fehler?
Eine klare Eingabe verbessert die Voraussetzungen. Sie ersetzt keine Quellenprüfung oder fachliche Freigabe, wenn die Folgen einer falschen Aussage erheblich sind.
Ist ein zweites Modell automatisch eine unabhängige Kontrolle?
Nein. Modelle können ähnliche Informationslücken oder Annahmen teilen. Eine Kontrolle wird belastbarer, wenn sie andere überprüfbare Belege oder geeignete deterministische Prüfungen verwendet.
Wann ist eine Aufgabe für KI ungeeignet?
Wenn erforderliche Informationen fehlen, Fehler nicht rechtzeitig erkannt werden können oder die notwendigen Rechte nicht geklärt sind, muss der Ablauf angepasst oder die Aufgabe anders gelöst werden.
Quellen und weiterführende Beiträge
Geprüft am 9. November 2026. Grundlagen sind die oben verlinkte Transformer-Arbeit von Vaswani und Mitautoren, das NIST-Profil zu generativer KI sowie die Forschungsarbeiten zu langen Kontexten und nicht getreuen Begründungen. Historische Studien werden als solche eingeordnet und nicht als Messung aktueller Produkte ausgegeben. Produktdaten, Regeln und Prüfschritte sind eigene redaktionelle Beispiele.
Den praktischen Vergleich ergänzt unser Beitrag ChatGPT und Claude im Agenturalltag. Für die Veröffentlichung von Inhalten bietet der Leitfaden Anforderungen an professionelle Unternehmenswebseiten den übergeordneten Rahmen.