Strukturierte Daten anhand geeigneter Anwendungsfälle
Vokabular, Einbindung und Suchfunktion unterscheiden: mit konkreten Datenquellen, ausgeführten Prüfungen und ehrlichen Aussagegrenzen.
Strukturierte Daten beschreiben Inhalte in einer Form, die Programme gezielt auswerten können. Eine Überschrift bleibt dabei eine Überschrift für Leser. Zusätzlich kann eine maschinenlesbare Beschreibung deutlich machen, dass sie zu einem Artikel gehört. Dieser Zusammenhang ist der Ausgangspunkt. Das Markup sollte vorhandene Inhalte beschreiben und keine zweite, werblich günstigere Wirklichkeit hinter der sichtbaren Webseite erzeugen.
Für die Umsetzung braucht es drei getrennte Entscheidungen: Welcher Gegenstand wird beschrieben? Welches Vokabular passt dazu? Welche Anforderungen stellt ein bestimmter Dienst an seine Auswertung? Wer diese Ebenen unterscheidet, kann einen kleinen sinnvollen Anwendungsfall auswählen und tatsächlich prüfen. Der folgende Beitrag zeigt dies an einem eigenen konstruierten Lernartikel. Das Beispiel ist kein realer Kundennachweis und verspricht keine besondere Suchdarstellung.
Vom Seiteninhalt zum passenden Gegenstand
Beginne bei der tatsächlichen Hauptaufgabe einer Seite. Ein Fachbeitrag erklärt ein Thema. Eine Produktseite beschreibt ein konkretes Angebot. Eine Veranstaltungsseite enthält Informationen über einen bestimmten Termin. Diese Unterschiede sind wichtiger als die Frage, welche Suchdarstellung besonders auffällig aussieht. Ein Datentyp sollte aus dem vorhandenen Inhalt folgen. Das gewünschte Erscheinungsbild in einer Ergebnisliste rechtfertigt keinen unpassenden Typ.
Die Schema.org-Beschreibung von Article ordnet den Typ als Artikel ein und zeigt seine Beziehungen und Eigenschaften. Eine solche Typbeschreibung ist eine Vokabulargrundlage. Sie ist nicht automatisch eine Liste aller Bedingungen für jede Suchmaschine. Eine Eigenschaft kann im Vokabular vorgesehen sein, ohne dass ein bestimmter Dienst daraus eine besondere Darstellung erzeugt.
Für die Planung genügt zunächst eine Zuordnungstabelle mit Seitentyp, sichtbarem Gegenstand und verfügbaren Angaben. Bei einem Artikel können das Überschrift, Verfasser und Sprache sein. Wenn Informationen fehlen, wird die Lücke dokumentiert. Sie wird nicht durch eine erfundene Person, ein beliebiges Datum oder eine ausgedachte Bewertung geschlossen. Die saubere Grenze ist Teil der Qualität des Datensatzes.
Prüfe außerdem, ob mehrere Gegenstände vorkommen. Ein Artikel kann ein Produkt besprechen, ohne selbst eine Produktangebotsseite zu sein. Die bloße Erwähnung eines Unternehmens macht den gesamten Beitrag nicht zu einem Unternehmensprofil. Die Beschreibung muss die Beziehungen sinnvoll erklären. Für einen ersten Anwendungsfall ist eine kleine klare Zuordnung häufig besser als ein umfangreiches Netz aus ungenau verbundenen Objekten.
Ein nützliches Auswahlkriterium ist die Pflegefähigkeit. Wer die Angaben im sichtbaren Beitrag aktualisiert, sollte nachvollziehen können, wo die maschinenlesbare Fassung entsteht. Eine einmalig eingefügte Kopie ohne weitere Zuständigkeit kann später auseinanderlaufen. Wähle deshalb einen Fall, dessen Datenquelle und Aktualisierung verständlich sind. Die technische Einfachheit der ersten Einbindung darf die spätere Pflege nicht verdecken.
Vokabular, Einbindungsformat und Suchfunktion trennen
Schema.org beschreibt Begriffe und Beziehungen. JSON-LD ist eine mögliche Form, solche Angaben einzubinden. Die Auswertung durch eine Suchmaschine ist eine weitere Ebene. In der Google-Einführung zu strukturierten Daten wird JSON-LD als gewöhnlich empfohlener Weg erläutert. Die Dokumentation nennt daneben weitere unterstützte Formate. JSON-LD ist deshalb keine Voraussetzung dafür, dass überhaupt strukturierte Daten existieren können.
Diese Trennung hilft bei Gesprächen über Fehler. Ein syntaktisch fehlerhaftes JSON-Dokument ist ein anderes Problem als eine unzutreffende Artikelüberschrift. Eine korrekt beschriebene Seite kann wiederum ohne besondere Ergebnisdarstellung erscheinen. Wenn diese Ebenen vermischt werden, wird eine technische Prüfung leicht als umfassender Wirksamkeitsnachweis missverstanden.
Die Google-Dokumentation zu Article nennt im hier geprüften Quellenstand passende empfohlene Eigenschaften und ausdrücklich keine erforderlichen Eigenschaften für diesen Typ. Daraus folgt weder, dass beliebige leere Angaben sinnvoll wären, noch, dass dieselbe Regel für andere Suchfunktionen gilt. Anforderungen müssen für den konkreten Anwendungsfall und den jeweiligen Quellenstand gelesen werden.
Behandle Beispiele aus einer Dokumentation ebenfalls mit Sorgfalt. Sie können mehrere Eigenschaften zeigen, damit deren Verwendung verständlich wird. Eine vollständige Übernahme ohne passende Ausgangsdaten würde den Zweck verfehlen. Für den eigenen Inhalt wird nur übernommen, was tatsächlich zutrifft und sachlich vertreten werden kann. Fehlende Bilder oder Verfasserprofile dürfen nicht durch fremde oder erfundene Angaben ersetzt werden.
Bei einer späteren Erweiterung wird erneut geprüft, welche Rolle eine Eigenschaft besitzt. Das vermeidet zwei Extreme: unnötig viele Angaben einzufügen oder aus Vorsicht nur einen kaum aussagekräftigen Datensatz zu belassen. Die Entscheidung beruht auf Inhalt, gepflegten Daten und tatsächlich geltenden Anforderungen. Eine besonders lange JSON-Datei ist kein eigenständiges Qualitätsmerkmal.
Ein kleiner Lernartikel mit zwei passenden Beschreibungen
Das folgende Beispiel besteht aus einem sichtbaren Ausschnitt und einem dazugehörigen JSON-LD-Block. Beide gehören zu einer konstruierten Lernansicht. Die Beispielredaktion ist eine benannte Demonstrationsrolle und keine behauptete reale Organisation. Die Überschrift, die kurze Beschreibung und die Sprache sind bewusst einfach gehalten. So lässt sich der Zusammenhang ohne fremde Daten oder einen echten Veröffentlichungsprozess untersuchen.
<article lang="de">
  <h1>Materialangaben verständlich prüfen</h1>
  <p class="author">Beispielredaktion</p>
  <p class="description">Ein Lernbeispiel zur Prüfung sichtbarer Materialangaben.</p>
</article>
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "Materialangaben verständlich prüfen",
  "description": "Ein Lernbeispiel zur Prüfung sichtbarer Materialangaben.",
  "inLanguage": "de",
  "author": {
    "@type": "Organization",
    "name": "Beispielredaktion"
  }
}
</script>
Die reduzierte Form erklärt ausgewählte Zuordnungen. Sie ist keine vollständig ausgearbeitete Vorlage für jede Veröffentlichung. Insbesondere werden kein tatsächliches Veröffentlichungsdatum, kein Bild und keine reale Verfasseradresse behauptet. Für eine produktive Seite wären die tatsächlich vorhandenen geeigneten Angaben zu prüfen. Eine Demonstration darf diesen Beschaffungsschritt nicht überspringen.
Im JSON-LD sind Eigenschaftsnamen wie headline und author technische Begriffe. Sie werden nicht für jede Sprachfassung frei übersetzt. Die Werte beschreiben dagegen den jeweiligen Inhalt. In der englischen Lernfassung ändern sich deshalb Überschrift, Beschreibung und inLanguage passend zum sichtbaren Text. Die Übereinstimmung wird pro Sprachfassung geprüft und nicht aus der Existenz einer Übersetzung vermutet.
Die gewählte Beschreibung fasst den Lernartikel zusammen. Sie ersetzt dessen eigentlichen Inhalt nicht. In einem realen Beitrag müsste der Text die angekündigte Erklärung tatsächlich leisten. Ein treffender Metadatensatz kann einen inhaltsarmen oder unzutreffenden Beitrag nicht nachträglich in einen belastbaren Fachartikel verwandeln. Die sichtbare Information bleibt die Grundlage.
Das Beispiel zeigt außerdem, warum eine automatische Datenquelle hilfreich sein kann. Wenn sichtbare Überschrift und headline aus demselben redaktionellen Feld entstehen, sinkt eine bestimmte Art doppelter Pflege. Das beweist noch keine vollständige Richtigkeit. Eine falsch gepflegte Ausgangsangabe kann schließlich in beiden Darstellungen identisch falsch erscheinen. Gemeinsame Herkunft und sachliche Wahrheit sind unterschiedliche Prüffragen.
Was der tatsächlich ausgeführte Vergleich bestätigt
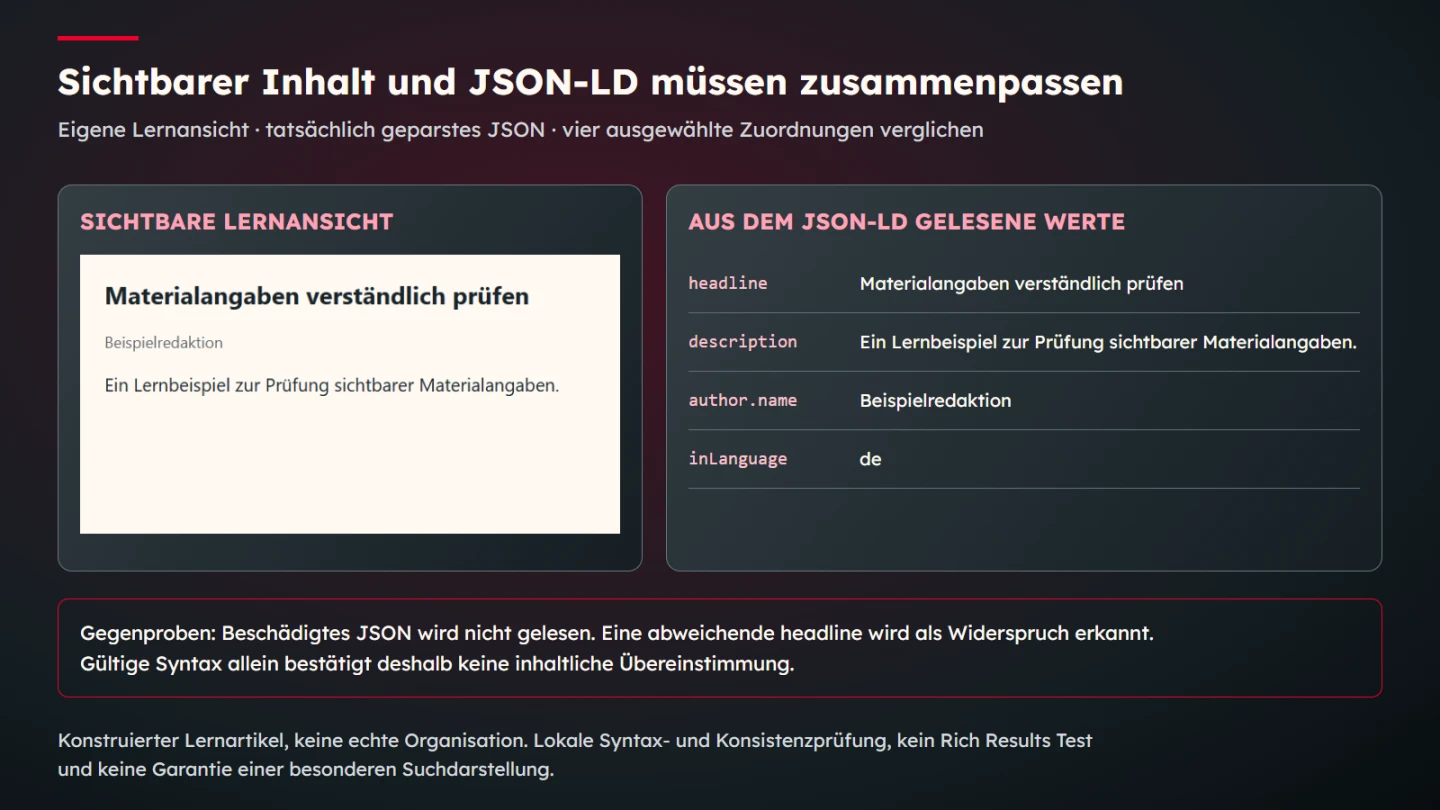
Für die Prüfung wird der im Artikel veröffentlichte Code tatsächlich ausgelesen. Der Browser stellt die sichtbare Lernansicht dar. Der JSON-Block wird als JSON geparst. Anschließend werden Überschrift, Beschreibung, Verfassername und Sprachangabe mit den entsprechenden sichtbaren Angaben verglichen. Die englische Fassung wird eigenständig mit ihrem eigenen Text geprüft.
Diese Kontrolle beantwortet begrenzte Fragen. Ist der Block syntaktisch lesbar? Sind die ausgewählten Angaben innerhalb dieses Beispiels gleich? Wird tatsächlich ein Article beschrieben? Sie ist keine allgemeine Validierung des gesamten Schema.org-Vokabulars. Sie prüft auch nicht, ob eine Suchmaschine die Seite abgerufen hat oder eine bestimmte Suchfunktion ausspielen wird.
Zwei Gegenproben machen den Unterschied deutlich. Ein absichtlich beschädigter JSON-Block scheitert beim Parsen. Eine geänderte headline bleibt syntaktisch gültig, stimmt aber nicht mehr mit der sichtbaren Überschrift überein. Diese zweite Abweichung zeigt, warum ein reiner Syntaxerfolg für den redaktionellen Abgleich nicht ausreicht.
Beide Gegenproben bleiben isolierte Lernfälle. Es werden keine falschen Angaben auf einer echten Webseite veröffentlicht. Der Sinn besteht darin, die begrenzte Kontrolle zu erklären. Ein erfolgreich erkannter Unterschied rechtfertigt nicht die Behauptung, jede denkbare Irreführung werde automatisch entdeckt. Weitere Eigenschaften, Beziehungen und Inhalte benötigen ihre jeweils passende fachliche Prüfung.
Für die praktische Arbeit hilft es, Prüfungen ebenso präzise zu benennen. Ein JSON-Parser prüft die lesbare Struktur. Ein eigener Abgleich vergleicht ausgewählte Werte. Ein externer Dienst prüft die von ihm unterstützten Regeln. Ein Mensch beurteilt unter anderem den tatsächlichen Inhaltsbezug. Das Ergebnis sollte immer sagen, welche dieser Aufgaben wirklich ausgeführt wurde.
Eine Prüftabelle für die tatsächliche Umsetzung
Vor der Veröffentlichung werden technische und redaktionelle Kontrollen zusammengeführt. Die Tabelle verhindert, dass ein einzelnes grünes Ergebnis alle anderen Fragen überdeckt. Sie eignet sich auch für die Abstimmung zwischen Redaktion und Entwicklung. Jede Zeile hat eine klar begrenzte Aussage. So lassen sich offene Punkte gezielt bearbeiten.
| Prüffrage | Passende Grundlage | Grenze des Ergebnisses |
|---|---|---|
| Ist JSON lesbar? | Tatsächlicher Parserlauf | Bestätigt keine inhaltliche Richtigkeit |
| Passt der Typ zum Gegenstand? | Sichtbarer Hauptinhalt und Vokabular | Erzeugt keine Suchdarstellung |
| Stimmen die Angaben überein? | Abgleich mit der sichtbaren Fassung | Prüft nur die ausgewählten Eigenschaften |
| Sind Dienstanforderungen erfüllt? | Aktuelle Dokumentation und passendes Prüfwerkzeug | Garantiert keine tatsächliche Anzeige |
| Bleiben Daten aktuell? | Pflegeprozess und erneute Prüfung | Ein früherer Erfolg gilt nicht unbegrenzt |
| Wurde die veröffentlichte Seite erfasst? | Tatsächlicher Abruf- oder Indexierungsnachweis | Ist keine Folge einer lokalen Vorschau |
Die allgemeinen Google-Richtlinien für strukturierte Daten verlangen einen zutreffenden Bezug zum sichtbaren Inhalt. Sie erklären außerdem, dass selbst korrektes Markup keine besondere Anzeige garantiert. Diese beiden Punkte gehören zur Planung. Ein Testbericht darf deshalb nicht mit einer zugesicherten Darstellung in Suchergebnissen verwechselt werden.
Bei produktiven Seiten ist zusätzlich die tatsächlich ausgelieferte Fassung entscheidend. Eine Vorlage kann korrekt aussehen, während ein zweiter Baustein widersprüchliche Daten ergänzt. Prüfe den vollständigen ausgegebenen Inhalt und nicht nur eine einzelne Datei. Mehrere Datensätze sind nicht grundsätzlich falsch. Ihre Beziehungen und möglichen Widersprüche müssen aber verständlich bleiben.
Dasselbe gilt für Bilder, Daten und Verfasser. Wenn solche Angaben verwendet werden, müssen sie zu der konkreten Veröffentlichung gehören. Ein beliebiges Unternehmenslogo ist nicht automatisch das beschriebene Artikelbild. Das heutige Bearbeitungsdatum ist nicht automatisch das frühere Veröffentlichungsdatum. Eine technische Eigenschaft braucht eine passende tatsächliche Bedeutung.
Pflege und Erweiterung ohne unkontrollierte Vervielfachung
Eine einmalige Einbindung ist nur der Anfang. Artikel werden umbenannt, Beschreibungen überarbeitet und Inhalte erweitert. Lege fest, wo die jeweiligen Angaben gepflegt werden und welche Ausgabe daraus entsteht. Wenn zwei getrennte Stellen dieselbe Information speichern, braucht diese doppelte Verantwortung eine bewusste Lösung. Unbemerkte Abweichungen sind ansonsten eine absehbare Folge.
Nutze bei der Erweiterung echte Fälle. Eine passende Navigation kann beispielsweise eine eigene strukturierte Beschreibung erhalten, wenn ihr tatsächlicher Verlauf bekannt ist. Eine reale Organisation kann als solche beschrieben werden, wenn ihre Angaben verlässlich vorliegen. Daraus folgt keine Pflicht, jeden theoretisch verfügbaren Typ in jede Seite einzubauen. Der konkrete Inhalt bleibt der Maßstab.
Bewertungen und andere besonders überzeugend wirkende Angaben verdienen eine eindeutige Grundlage. Das Beispiel enthält bewusst keine Sterne oder erfundenen Stimmen. Auch eine Demo darf nicht zufällig in die öffentliche Beschreibung übernommen werden. Halte Lerndaten und tatsächliche Veröffentlichungsdaten getrennt. Bei der Übernahme eines Codebeispiels muss jeder verbliebene Beispielwert überprüft werden.
Eine klare Zuständigkeit hilft bei Änderungen an Dienstanforderungen. Die Dokumentation einer Suchfunktion kann sich ändern, ohne dass sich das zugrunde liegende Vokabular im gleichen Maß verändert. Prüfe deshalb die relevante Quelle erneut, wenn eine neue Funktion eingeführt oder ein alter Anwendungsfall wesentlich überarbeitet wird. Ein früherer Quellenstand ist ein Nachweis damaliger Prüfung und keine Zusicherung für spätere Regeln.
Für eine kleine Webseite ist eine begrenzte gut gepflegte Lösung häufig die bessere Arbeitsgrundlage. Sie lässt sich verstehen, prüfen und erklären. Umfang entsteht aus tatsächlichen Inhalten und Anwendungsfällen. Die Menge der Eigenschaften allein beantwortet keine Leserfrage und ist kein Ersatz für gute redaktionelle Daten.
Freigabe als nachvollziehbare Entscheidung
Die abschließende Freigabe verbindet den sichtbaren Gegenstand mit der ausgegebenen Beschreibung. Halte die betrachtete Seite, den Quellenstand und die tatsächlich ausgeführten Kontrollen fest. Eine kurze präzise Notiz ist hilfreicher als ein pauschaler Vermerk, alles sei optimiert. Sie erklärt, was bestätigt wurde und welche Fragen außerhalb der Prüfung bleiben.
- Der gewählte Typ passt zum tatsächlichen Hauptinhalt.
- Verwendete Angaben besitzen eine nachvollziehbare Grundlage.
- Sichtbare und maschinenlesbare Werte stimmen im vorgesehenen Umfang überein.
- Sprachfassungen werden mit ihren jeweiligen Inhalten geprüft.
- Beispielwerte und erfundene Bewertungen sind ausgeschlossen.
- Die ausgegebene Gesamtseite wurde auf widersprüchliche Beschreibungen angesehen.
- Aktuelle dienstspezifische Anforderungen wurden passend eingeordnet.
- Prüfwerkzeuge werden nur mit tatsächlich ausgeführten Ergebnissen genannt.
- Eine besondere Suchdarstellung wird nicht zugesichert.
- Pflege und spätere Änderungen haben eine konkrete Zuständigkeit.
Im Lernartikel besteht das bestätigte Ergebnis aus lesbarem JSON und übereinstimmenden ausgewählten Angaben. Diese Aussage ist klein genug, um tatsächlich geprüft zu werden. Genau daraus entsteht eine tragfähige Grundlage für die Erweiterung. Strukturierte Daten sind am nützlichsten, wenn sie vorhandene Informationen präzise beschreiben und ihre Grenzen ebenso nachvollziehbar bleiben wie ihre technische Form.
Einen Widerspruch schrittweise untersuchen
Angenommen, die sichtbare Überschrift des Lernartikels wird in Materialbezeichnungen sorgfältig prüfen geändert. Der JSON-LD-Block enthält weiterhin Materialangaben verständlich prüfen. Beide Texte sind sprachlich plausibel. Der Parser kann den Block weiterhin lesen. Der Widerspruch wird erst durch den Vergleich der tatsächlichen Werte sichtbar. Die erste Maßnahme ist deshalb die Suche nach ihrer Datenquelle und nicht ein Wechsel des Datentyps.
Prüfe zunächst, ob die beiden Fassungen aus getrennten Feldern stammen. Wenn ja, ist zu entscheiden, welche Quelle maßgeblich sein soll. Danach wird die Ausgabe erneut betrachtet. Wenn beide Werte bereits aus demselben Feld erzeugt werden, könnte eine zwischengespeicherte oder zusätzlich eingebundene Fassung beteiligt sein. Diese Vermutung muss anhand der tatsächlich ausgelieferten Seite geprüft werden. Sie ist kein Grund, blind mehrere weitere Blöcke hinzuzufügen.
Bei einer Sprachabweichung läuft die Suche ähnlich. Ein englischer sichtbarer Text mit einem deutschen headline-Wert ist nicht durch ein deutsches Quellfeld gerechtfertigt. Die Ausgabe muss dem vorgesehenen Inhalt folgen. Prüfe deshalb die Auswahl der Sprache an der Stelle, an der die Daten zusammengestellt werden. Eine allgemeine Übersetzungszuordnung im Projekt beweist nicht, dass diese konkrete Ausgabe bereits die richtige Fassung verwendet.
Wenn die Angaben schließlich übereinstimmen, wird die Korrektur präzise dokumentiert. Bestätigt wurde die beseitigte Abweichung der geprüften Eigenschaften. Es wurde dadurch keine Suchanzeige ausgelöst oder zugesichert. Diese enge Formulierung hilft, technische Fehlerbehebung und spätere Beobachtungen der Sichtbarkeit auseinanderzuhalten. Beides kann relevant sein, braucht aber jeweils eine eigene Grundlage.
Die Datenzuordnung vor einer Erweiterung dokumentieren
Eine kleine Zuordnungstabelle spart bei späteren Änderungen unnötige Suche. Sie benennt nicht nur den technischen Eigenschaftsnamen, sondern auch seine Quelle. Im Lernfall stammt headline aus der sichtbaren Hauptüberschrift. description entspricht dem sichtbaren Einführungssatz. author.name bezieht sich auf die angegebene Demonstrationsredaktion. inLanguage beschreibt die Sprache der Lernansicht. Diese Beziehungen sind konkreter als ein allgemeiner Vermerk, Metadaten seien automatisch erzeugt.
Für eine reale Umsetzung wird ergänzt, wer die Ausgangsinformation fachlich verantwortet. Die Redaktion kann die Überschrift festlegen. Die technische Ausgabe übernimmt sie in das passende Feld. Wird die Verantwortung für den Inhalt mit der Verantwortung für das Format verwechselt, bleiben Rückfragen leicht zwischen beiden Bereichen liegen. Eine ausdrückliche Zuordnung macht den nächsten Schritt erkennbar.
Dokumentiere außerdem bewusst nicht verwendete Angaben, wenn deren Fehlen sonst wiederholt Nachfragen auslöst. Im Beispiel werden keine tatsächlichen Daten oder Bilder erfunden. Das ist eine inhaltliche Grenze der Lernansicht. Für eine echte Veröffentlichung kann dieselbe Eigenschaft sinnvoll sein, sobald eine zutreffende gepflegte Grundlage vorhanden ist. Eine zunächst nicht verwendete Eigenschaft ist deshalb weder grundsätzlich verboten noch automatisch ein Fehler.
Eine Erweiterung wird anschließend wie eine neue kleine Entscheidung geprüft. Welche Information kommt hinzu? Wo ist sie sichtbar oder fachlich belegt? Welcher Gegenstand wird damit genauer beschrieben? Welche Kontrolle kann einen falschen Wert erkennen? Diese Fragen führen zu einer nachvollziehbaren Verbesserung. Sie vermeiden, dass die Beschreibung allein deshalb wächst, weil ein Werkzeug zusätzliche leere Eingabefelder anbietet.
Beim Übertragen des Beispiels bleibt außerdem die technische Schreibweise erhalten. Eigenschaftsnamen und Zeichenketten stehen in doppelten Anführungszeichen. Die geschweiften Klammern bilden das Objekt. Ein zusätzliches Komma nach der letzten Eigenschaft würde den JSON-Block beschädigen. Solche Zeichen sind keine redaktionelle Typografie. Automatisch gesetzte geschwungene Anführungszeichen können deshalb in einem Codeblock einen anderen Effekt haben als im Fließtext. Prüfe nach einer Übernahme den tatsächlich gespeicherten Code und nicht nur dessen ähnlich aussehende Darstellung. Die ausgeführte Gegenprobe mit beschädigtem JSON zeigt genau diese begrenzte Fehlerklasse.
Quellen und Einordnung
Quellenstand: 9. November 2026. Die verlinkten Primärquellen von Google und Schema.org wurden tatsächlich aufgerufen. Die Lernseite und die Beispielredaktion sind konstruiert. Die ausgeführten Prüfungen sind lokale Syntax- und Konsistenzkontrollen. Eine tatsächliche Prüfung im Rich Results Test oder eine Ausspielung in Suchergebnissen wird damit nicht behauptet.