Weiterleitungen, Canonicals und Sitemaps gemeinsam prüfen
Elf tatsächliche HTTP-Abrufe und vierzig Prüfbedingungen machen direkte Wege, falsche Sprachziele und unerwünschte Sitemap-Einträge sichtbar.
Weiterleitung, Canonical und Sitemap beantworten verschiedene Fragen. Die Weiterleitung bestimmt den nächsten HTTP-Weg, ein Canonical bezeichnet eine bevorzugte Darstellung und die Sitemap nennt zur Entdeckung vorgesehene Adressen. Eine verlässliche Prüfung vergleicht diese Aussagen miteinander. Wir bauen dafür eine kleine künstliche Webseite mit deutscher und englischer Leistungsseite. Anschließend erfassen wir echte Antworten und prüfen bewusst erzeugte Widersprüche. Das Ergebnis ist eine technische Vertragsprüfung, keine Vorhersage über Indexierung oder Positionen bei Google.
Eine bevorzugte Adresse zuerst fachlich festlegen
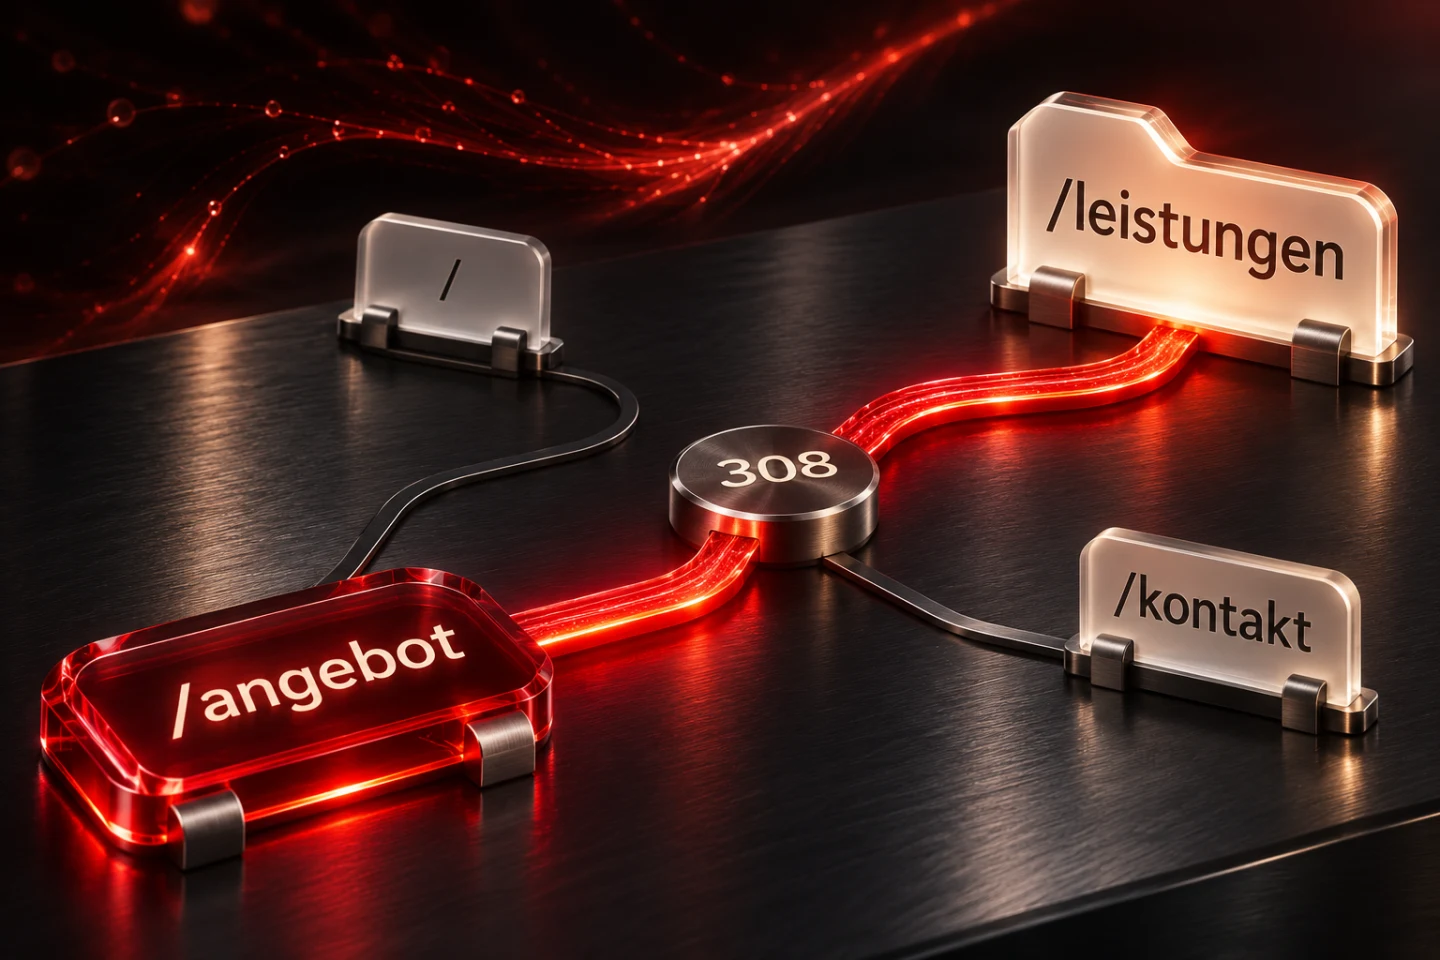
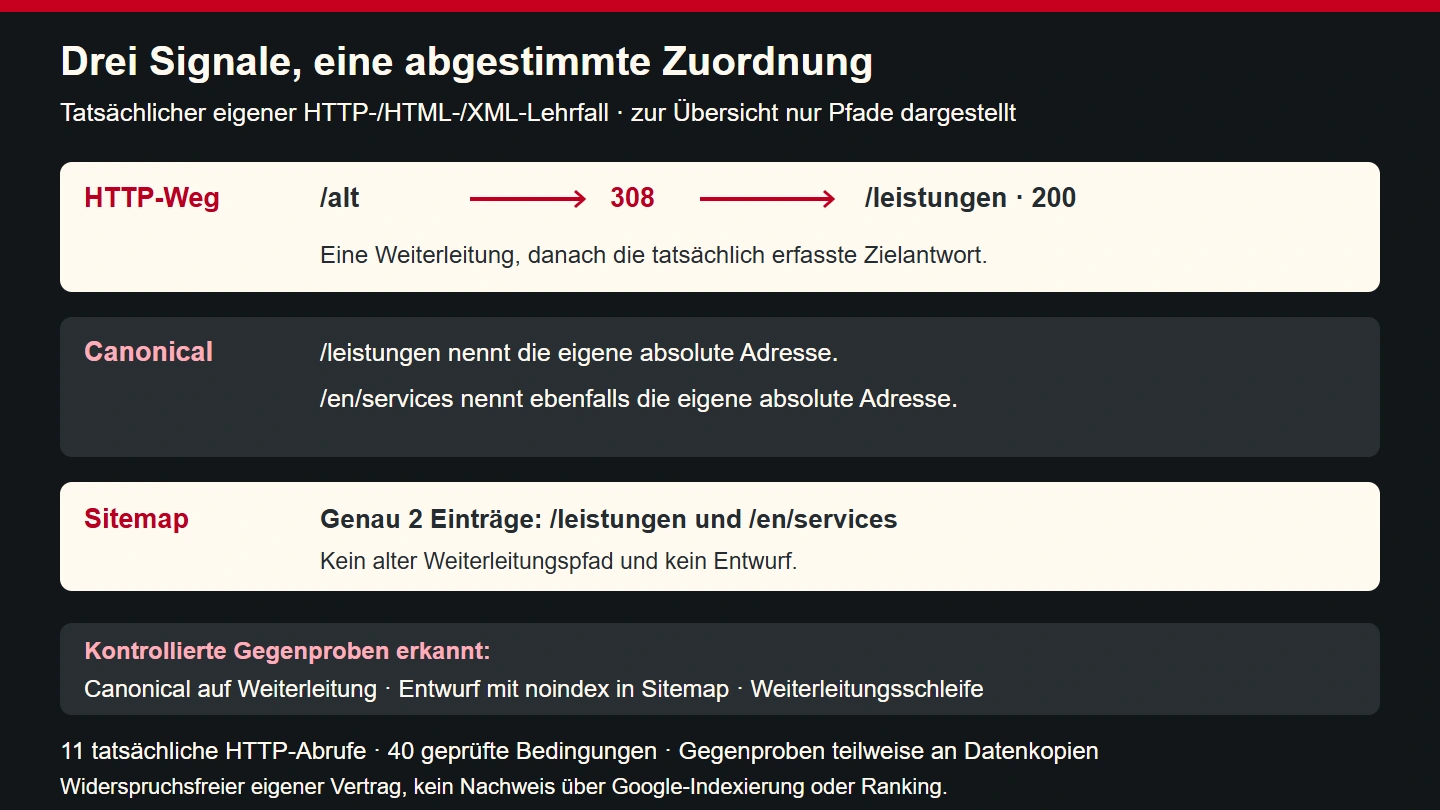
Im Lehrfall soll die deutsche Leistungsseite unter /leistungen erreichbar sein. Eine ältere Adresse /alt soll unmittelbar dorthin weiterleiten. Die englische Fassung besitzt mit /en/services eine eigene Adresse. Beide Sprachfassungen sollen als eigenständige Darstellungen bestehen bleiben. Ein Entwurf wird zwar als künstliche HTML-Antwort gezeigt, soll aber nicht zur öffentlichen Auswahl gehören. Diese kurze Vereinbarung gibt uns konkrete Erwartungen, bevor wir technische Antworten sammeln.
Eine Prüfung ohne solche Erwartungen kann Erreichbarkeit feststellen, aber nicht zuverlässig entscheiden, ob eine Adresse fachlich das richtige Ziel ist. Eine Weiterleitung auf die Startseite kann technisch funktionieren und trotzdem eine gesuchte Leistung unauffindbar machen. Ebenso kann ein Canonical syntaktisch korrekt sein und auf den falschen Inhalt zeigen. Deshalb trennen wir die beabsichtigte Zuordnung von den tatsächlich beobachteten Antworten. Der spätere Bericht vergleicht beides, statt aus dem aktuellen Zustand automatisch das gewünschte Ergebnis abzuleiten.
Die drei Signale nach ihrer Aufgabe unterscheiden
Eine serverseitige Weiterleitung wird als HTTP-Antwort mit einem Ziel geliefert. Der Client kann diesem Ziel folgen. Ein Canonical-Link im HTML beschreibt dagegen eine bevorzugte Adresse, ohne den gerade betrachteten Inhalt selbst umzuleiten. Der Sitemap-Eintrag ersetzt ebenfalls keine dieser beiden Funktionen. Die Google-Dokumentation zur Kanonisierung ordnet Weiterleitungen und Canonical-Verweise als starke Signale ein, die Sitemap als schwächeres Signal. Eine Präferenz bleibt von Googles tatsächlicher Auswahl zu unterscheiden.
Für unsere eigene Abnahme wollen wir einen widerspruchsfreien einfachen Fall. Der alte Pfad führt auf die deutsche Zieladresse. Dort steht genau ein absoluter Canonical auf dieselbe Adresse. Die Sitemap nennt die beiden aktuellen Sprachfassungen und enthält weder den alten Pfad noch den Entwurf. Das ist der Vertrag dieses Beispiels. Er ist keine Behauptung, dass jede Webseite immer genau diese Ausgestaltung benötigt oder dass das Erfüllen der Prüfung eine Suchmaschinenentscheidung erzwingt.
| Signal | Eigene Prüfungsfrage | Beabsichtigter Lehrfall |
|---|---|---|
| HTTP-Weiterleitung | Wohin führt der alte Pfad tatsächlich? | /alt führt mit 308 direkt auf /leistungen |
| Canonical im HTML-Kopf | Welche Adresse nennt die Zielseite selbst? | Eine absolute eigene Zieladresse |
| Sitemap | Welche aktuellen Seiten werden genannt? | Deutsche und englische Zielseite |
| Indexierungsangabe | Widerspricht ein noindex der geplanten Auswahl? | Entwurf bleibt außerhalb der Sitemap |
Den ersten HTTP-Schritt ohne automatisches Folgen erfassen
Ein Browser landet nach einer Weiterleitung oft so schnell auf dem Ziel, dass der erste Status nicht auffällt. Für die Erfassung im Lehrversuch verwenden wir deshalb einen HTTP-Abruf, der Weiterleitungen zunächst nicht automatisch verfolgt. Wir speichern Status und Location-Angabe getrennt. Anschließend wird das nächste bekannte Ziel als eigener Datensatz erfasst. So bleibt sichtbar, ob zwischen alter und neuer Adresse wirklich ein einziger Schritt liegt oder noch eine Zwischenadresse beteiligt ist.
Die Bedeutung der Statuscodes beschreibt RFC 9110. Im Beispiel wählen wir für den dauerhaft ersetzten Pfad 308. Für andere Anwendungsabläufe können weitere Statuscodes passend sein. Insbesondere darf eine Prüfung von GET-Seiten nicht unbemerkt als Nachweis über das Verhalten von Formular-POSTs ausgegeben werden. Unser Versuch erfasst einfache GET-Antworten und beansprucht keine vollständige Abnahme aller Methoden eines produktiven Systems.
Direkte Ziele, Ketten und Schleifen sichtbar machen
Eine zweite künstliche Adresse /kette führt zunächst auf /alt und erst danach auf die Leistungsseite. Der Zielinhalt ist am Ende erreichbar. Trotzdem unterscheiden wir diesen Weg vom vereinbarten direkten Übergang. Der eigene Prüfer meldet dafür eine Warnung mit zwei Weiterleitungsschritten. Wir behaupten keinen gemessenen Zeitverlust. Der Grund für die Warnung ist die zusätzliche zu pflegende Abhängigkeit. Wird später eine Zwischenadresse geändert, kann der gesamte Weg unerwartet anders enden.
Zusätzlich existieren zwei künstliche Kreisadressen, die aufeinander verweisen. Der Prüfer verfolgt bekannte Beobachtungen und merkt sich jede bereits besuchte Adresse. Beim erneuten Auftreten derselben Adresse erkennt er die Schleife. Eine begrenzte Zahl zulässiger Schritte schützt außerdem vor einer immer längeren unbekannten Kette. Beides sind eigene Prüfregeln unseres Werkzeugs. Sie sagen nichts darüber aus, wie viele Schritte ein bestimmter Suchmaschinenprozess in einer konkreten Situation tatsächlich verfolgen würde.
Den Canonical aus dem Kopf der tatsächlichen Antwort lesen
Für die HTML-Antworten verwenden wir den DOMParser eines echten Edge-Browsers. Der Prüflauf liest die Canonical-Linkelemente aus dem Kopf des erfassten Dokuments. Er wertet nicht bloß die sichtbare Adresszeile aus. Im einfachen Vertrag erwarten wir genau einen absoluten Verweis auf die eigene bevorzugte Adresse. Mehrere voneinander abweichende Canonicals sind deshalb ein klar benennbarer Konflikt. Auch ein fehlender Verweis wird als Abweichung von dieser eigenen Vereinbarung gemeldet.
Relative Canonicals können von Google unterstützt werden, die Dokumentation empfiehlt jedoch absolute Adressen. Unser eigener Vertrag übernimmt diese strengere Vorgabe bewusst. Ein solcher Befund muss im Bericht als Vertragsregel erkennbar bleiben. Er darf nicht zur falschen Behauptung werden, jede relative Angabe sei unabhängig vom Kontext technisch ungültig. Diese Trennung zwischen allgemeinem Verhalten und eigener Abnahmebedingung macht die Auswertung gerade bei bestehenden Systemen wesentlich fairer und verständlicher.
Das Canonical-Ziel ebenfalls auf seine Antwort prüfen
Ein Verweis auf eine formal gültige Adresse ist noch kein ausreichender Nachweis. Der Zielpfad könnte selbst weiterleiten, eine Fehlerantwort liefern oder gar nicht im Beobachtungsbestand enthalten sein. Unser eigener Prüfer verlangt deshalb, dass das bekannte Canonical-Ziel mit 200 erfasst wurde. Eine kontrollierte Gegenprobe lässt die Leistungsseite auf den alten Weiterleitungspfad zeigen. Damit widersprechen sich ihre bevorzugte Adresse und ihr tatsächlicher endgültiger Weg. Der Bericht benennt diesen Widerspruch gezielt.
Die inhaltliche Gleichwertigkeit zweier Seiten wird dabei nicht automatisch bewertet. Ein Programm kann nicht allein aus einer passenden Kennung oder einem Status ableiten, ob zwei Angebote denselben Inhalt haben. Für reale Duplikate muss das Team zusätzlich den tatsächlichen Seiteninhalt betrachten. Unser Lehrfall umgeht diese Aufgabe nicht mit einer erfundenen Ähnlichkeitsskala. Er prüft ausschließlich die vereinbarte Zuordnung bereits ausgewählter Zielseiten und die dazu beobachteten technischen Aussagen.
Sprachfassungen nicht versehentlich zusammenziehen
Die englische Lernseite besitzt ihren eigenen Canonical. In einer Gegenprobe ändern wir nur ihre erfasste Angabe so, dass sie auf die deutsche Leistungsseite zeigt. Der Prüfer erkennt die Abweichung vom vorgesehenen eigenen Ziel. Das ist für unser Beispiel wichtig, weil beide Sprachfassungen ausdrücklich eigenständig bestehen sollen. Eine englische Seite ist nicht allein deshalb ein technisches Duplikat, weil sie dieselbe Leistung in einer anderen Sprache beschreibt. Die tatsächliche Sprach- und Inhaltsplanung bestimmt die beabsichtigte Zuordnung.
Eine vollständige Mehrsprachenprüfung würde zusätzlich die vorgesehenen hreflang-Beziehungen untersuchen. Diese Beziehungen sind kein Ersatz für eine schlüssige Canonical-Auswahl. Unser kleines Werkzeug prüft sie hier nicht. Deshalb bezeichnet der Bericht auch keinen Mehrsprachenauftritt als vollständig abgenommen. Für ein reales Projekt würden wir die Liste erwarteter Sprachfassungen, ihre Rückbeziehungen und ihre Erreichbarkeit als eigene Prüfaufgabe ergänzen und mit passenden Gegenbeispielen absichern.
Eine Sitemap als überprüfbare Auswahl behandeln
Im guten Lehrfall enthält die Sitemap genau zwei Einträge. Beide bezeichnen aktuelle Zielseiten mit erfolgreicher Antwort. Das Sitemap-Protokoll beschreibt unter anderem XML-Struktur, Namensraum und Zeichenkodierung. Wir parsen die tatsächliche XML-Antwort im Browser und lesen die loc-Einträge im vorgesehenen Namensraum. Eine erfolgreiche XML-Verarbeitung allein bedeutet jedoch noch nicht, dass die ausgewählten Adressen fachlich richtig sind. Deshalb folgt danach der Vergleich mit dem erwarteten Seitenbestand.
Eine zweite künstliche Sitemap enthält zusätzlich den alten Weiterleitungspfad, einen Entwurf und eine Fehleradresse. Außerdem wiederholt sie einen bereits vorhandenen Eintrag. Der eigene Prüfer kann diese Auffälligkeiten auseinanderhalten. So entsteht keine pauschale Meldung „Sitemap schlecht“, sondern eine Liste konkreter Aufgaben. Die Redaktion kann den Entwurf aus der Auswahl entfernen, während die Technik die Quelle des alten Pfads untersucht. Der Prüfbericht behauptet dabei keine automatisch ausgeführte Reparatur.
noindex und bevorzugte Seiten nicht vermischen
Die Google-Dokumentation zu Robots-Metaangaben beschreibt unter anderem die Indexierungssteuerung durch noindex. Im Lehrfall trägt der Entwurf eine solche Angabe und gehört nicht in unsere öffentliche Sitemap. Eine weitere Gegenprobe setzt noindex auf die eigentlich gewünschte Leistungsseite. Das Werkzeug meldet dann den Konflikt zwischen geplantem Zielbestand und beobachteter Angabe. Es leitet daraus keine Aussage ab, ob Google diese konkrete künstliche Seite tatsächlich kennt.
Eine blockierte Abrufmöglichkeit und eine gelesene noindex-Angabe sind außerdem verschiedene Situationen. Unser Werkzeug liest keine robots.txt und meldet dafür keinen bestandenen Test. Es prüft auch keine gesamten Zugangsregeln eines geschützten Bereichs. Wer einen Entwurf vor unberechtigtem Zugriff schützen will, braucht eine tatsächliche Zugriffskontrolle. Ein redaktioneller Indexierungshinweis ist keine Anmeldung und keine Garantie, dass eine bekannte Adresse außerhalb eines Suchergebnisses nicht erreichbar wäre.
Grenzen des Beobachtungsbestands bewusst erhalten
Der folgende Baustein verarbeitet bereits erfasste Beobachtungen. Er startet selbst keine Netzwerkanfragen. Das ist eine klare Trennung zwischen Erhebung und Bewertung. Wenn ein Ziel nicht in der übergebenen Liste vorhanden ist, behauptet der Prüfer nicht, es habe sicher einen bestimmten Fehlerstatus. Er meldet den fehlenden Nachweis. Für einen echten Prüflauf müsste das Team dann entscheiden, ob und wie genau diese Adresse im erlaubten Umfang zusätzlich erfasst werden soll.
Die Herkunftsgrenze ist ebenfalls ausdrücklich festgelegt. Der Lehrvertrag erwartet Adressen derselben Herkunft ohne Zugangsdaten oder Fragment. Eine externe Weiterleitung wird als Abweichung gemeldet und nicht blind verfolgt. Diese Regel ist keine allgemeine Aussage, dass externe Weiterleitungen immer falsch wären. Sie verhindert in unserem Beispiel nur, dass aus einem eng umrissenen lokalen Vergleich ein unbegrenzter Abruf beliebiger Ziele wird. Ein reales Werkzeug benötigt zusätzlich passende Netzwerk- und Berechtigungsgrenzen für seine Erfassung.
Den ausgeführten Prüfbaustein lesen
Die Eingabe enthält die Herkunft, die erfassten Seiten, die Sitemap-Auswahl, die bevorzugten Zieladressen und die beabsichtigten Aliaszuordnungen. Ein Seitenbeobachtungseintrag hält Status, Weiterleitungsziel, Canonicals und Robots-Werte getrennt. Der Baustein gibt Fehler, Warnungen und nachvollziehbare Wege zurück. Eine Warnung über eine Kette wird deshalb nicht mit einer vollständig gescheiterten Zielzuordnung gleichgesetzt. Für die eigene Abnahme können solche Warnungen anschließend nach der tatsächlichen Anforderung bewertet werden.
Das Programm ist bewusst auf den beschriebenen Lehrvertrag beschränkt. Es bewertet keine beliebigen HTTP-Linkheader, keine PDF-Canonicals, keine Clientweiterleitungen und keine Suchmaschinenentscheidung. Auch die Qualität eines Inhalts wird nicht aus seinem Statuscode geschätzt. Diese Grenzen sind Teil des Nutzens: Ein Befund hat eine klare Bedeutung, weil bekannt ist, welche Daten und welche Regeln ihm zugrunde liegen. Das vollständige Modul wurde mit den anschließend beschriebenen künstlichen Beobachtungen tatsächlich ausgeführt.
export function auditSignals({origin,pages,sitemap,preferred,aliases,maxHops=5}){
 const base=new URL(origin);if(!['http:','https:'].includes(base.protocol)||!Number.isInteger(maxHops)||maxHops<1||maxHops>20)throw new TypeError('Prüfkonfiguration ungültig.');
 const issues=[],warnings=[],routes=[];
 const url=value=>{const u=new URL(value,base);if(u.origin!==base.origin||u.username||u.password||u.hash)throw new TypeError('Nur eindeutige URLs derselben Herkunft ohne Fragment zulässig.');return u.href;};
 const records=new Map;for(const p of pages){const key=url(p.url);if(records.has(key))throw new TypeError('Doppelte Beobachtung.');records.set(key,p);}
 const expected=new Set(preferred.map(url));
 const issue=(code,target)=>issues.push({code,url:target});
 for(const target of expected){const p=records.get(target);if(!p){issue('missing_observation',target);continue;}if(p.status!==200)issue('preferred_not_200',target);if(!p.html)issue('preferred_not_html',target);if((p.robots??[]).some(x=>['noindex','none'].includes(x.toLowerCase())))issue('preferred_noindex',target);
  const canon=p.canonicals??[];if(canon.length!==1){issue('canonical_count',target);continue;}
  let canonical;try{if(!/^https?:\/\//i.test(canon[0]))throw new TypeError();canonical=url(canon[0]);}catch{issue('canonical_not_absolute_local',target);continue;}
  if(canonical!==target)issue('canonical_not_self',target);if(records.get(canonical)?.status!==200)issue('canonical_target_not_200',target);
 }
 const seen=new Set;for(const value of sitemap){const target=url(value);if(seen.has(target))issue('sitemap_duplicate',target);seen.add(target);if(!expected.has(target))issue('sitemap_unexpected',target);if(records.get(target)?.status!==200)issue('sitemap_not_200',target);if((records.get(target)?.robots??[]).some(x=>['noindex','none'].includes(x.toLowerCase())))issue('sitemap_noindex',target);}
 for(const target of expected)if(!seen.has(target))issue('sitemap_missing',target);
 for(const [source,wanted]of Object.entries(aliases)){let current=url(source),end=url(wanted),hops=0;const visited=new Set,steps=[];let failed=false;
  while(true){if(visited.has(current)){issue('redirect_loop',current);failed=true;break;}visited.add(current);const p=records.get(current);if(!p){issue('redirect_missing_observation',current);failed=true;break;}steps.push({url:current,status:p.status});if(![301,302,303,307,308].includes(p.status))break;if(hops>=maxHops){issue('redirect_limit',current);failed=true;break;}if(!p.location){issue('redirect_location_missing',current);failed=true;break;}if(![301,308].includes(p.status))warnings.push({code:'temporary_alias',url:current});try{current=url(new URL(p.location,current).href);}catch{issue('redirect_external_or_invalid',current);failed=true;break;}hops++;}
  if(!failed&&(current!==end||records.get(current)?.status!==200))issue('redirect_wrong_final',url(source));if(hops>1)warnings.push({code:'redirect_chain',url:url(source),hops});routes.push({source:url(source),wanted:end,final:current,hops,steps,failed});
 }
 return{passed:issues.length===0,issues,warnings,routes};
}

const origin='https://beispiel.invalid';
const result=auditSignals({
 origin,
 preferred:['/leistungen','/en/services'],
 aliases:{'/alt':'/leistungen'},
 sitemap:[origin+'/leistungen',origin+'/en/services'],
 pages:[
  {url:origin+'/alt',status:308,location:'/leistungen'},
  {url:origin+'/leistungen',status:200,html:true,canonicals:[origin+'/leistungen'],robots:[]},
  {url:origin+'/en/services',status:200,html:true,canonicals:[origin+'/en/services'],robots:[]}
 ]
});
console.log(JSON.stringify(result));
Was die vierzig Prüfbedingungen belegen
Für den Versuch lief ein eigener HTTP-Server auf einer freien Loopbackadresse. Wir riefen neun Lehradressen und zwei Sitemapfassungen tatsächlich ab. HTML und XML wurden anschließend mit dem DOMParser von Edge 157.0.4341.42 verarbeitet. Der Bewertungsbaustein lief mit Node.js 24.22.1. Insgesamt bestanden vierzig geprüfte Bedingungen. Der gültige Fall zeigte genau die Folge 308 und 200 für den alten Pfad sowie zwei passende Einträge in der guten Sitemap.
Die zusätzlichen Gegenproben verändern gezielt Kopien dieser Beobachtungsdaten. Dazu gehören ein fehlender Canonical, zwei Verweise, ein relatives Ziel, eine falsche Sprachzuordnung und ein weiterleitendes Canonical-Ziel. Weitere Fälle prüfen noindex, fehlende Sitemapziele, eine Schleife, die Schrittgrenze und eine externe Location. Diese Datenänderungen sind keine Behauptung über zusätzliche echte Webseitenaufrufe. Der Bericht unterscheidet die elf tatsächlichen HTTP-Abrufe von den anschließend ausgeführten kontrollierten Auswertungsfällen.
| Beobachtung oder Gegenprobe | Eigener Befund | Passende nächste Aufgabe |
|---|---|---|
| /alt erreicht /leistungen direkt | Ein Schritt, Ziel 200 | Mit der beabsichtigten Ablösung vergleichen |
| /kette erreicht das Ziel über /alt | Warnung über zwei Schritte | Zwischenabhängigkeit prüfen |
| Englischer Canonical zeigt auf die deutsche Seite | Abweichung vom eigenen Ziel | Sprachzuordnung klären |
| Entwurf steht in der schlechten Sitemap | Unerwartete und mit noindex markierte Adresse | Auswahlquelle korrigieren |
| Weiterleitungen bilden einen Kreis | Schleife | Beabsichtigten endgültigen Zielpfad festlegen |
Änderungsdaten sinnvoll statt automatisch aktualisieren
Ein optionales lastmod-Feld sollte eine tatsächliche relevante Änderung beschreiben. Die Google-Anleitung zum Sitemapaufbau erläutert unter anderem, dass sie die Angaben priority und changefreq ignoriert und lastmod anhand seiner verlässlichen Aussage nutzt. Für unsere kleine Lehrsitemap verzichten wir auf diese optionalen Felder. So erzeugen wir keinen scheinbar präzisen Änderungsnachweis, für den der Versuch überhaupt keine inhaltliche Änderungshistorie besitzt.
Für ein echtes Projekt würde die Redaktion festlegen, welche Änderungen einen aktualisierten Stand rechtfertigen und wo dieser Zeitpunkt zuverlässig herkommt. Ein bei jedem Sitemapabruf eingesetztes aktuelles Datum sagt zunächst nur etwas über den Abruf oder die Generierung aus. Es belegt nicht automatisch eine Änderung des Seiteninhalts. Die Prüfung sollte deshalb die Bedeutung des Datums untersuchen, statt seine bloße Anwesenheit als Qualitätsmerkmal zu zählen.
Den Bericht mit der tatsächlichen Veröffentlichung verbinden
Eine lokale Probe ersetzt nicht den Vergleich mit dem ausgelieferten System. Im tatsächlichen Projekt können zusätzliche Domainregeln, ein vorgeschalteter Dienst oder eine ältere Konfiguration einen anderen ersten Status erzeugen. Nach einer Änderung werden daher die betreffenden alten und neuen Adressen erneut von außen gelesen. Bei mehreren Sprachfassungen betrifft das jede tatsächlich vorgesehene Variante. Die Erhebung bleibt dabei im autorisierten Umfang und verändert keine fremden Inhalte oder Suchmaschinenkonten.
Eine erfolgreiche technische Vertragsprüfung wird anschließend als genau solche dokumentiert. Ob und wann eine Suchmaschine eine bevorzugte Adresse auswählt, ist damit nicht bewiesen. Ein späterer Bericht aus der Search Console wäre ein anderer Nachweis mit eigener Erhebungszeit und Bedeutung. Diese Ebenen sollten im Gespräch mit Auftraggebern getrennt bleiben. So entstehen nachvollziehbare Aussagen über das tatsächlich Gelieferte, statt einer scheinbar technischen Garantie für einen externen Auswahlprozess.
Checkliste für einen widerspruchsfreien Übergang
- Bevorzugte Adressen und beabsichtigte Aliaszuordnungen vorab festlegen.
- Den ersten HTTP-Status und jede Location getrennt erfassen.
- Direkte Wege, Ketten und Schleifen unterscheiden.
- Canonicals aus der tatsächlichen Antwort lesen und ihre Ziele ebenfalls prüfen.
- Sprachfassungen nach der eigenen Inhaltsplanung zuordnen.
- Sitemap-Auswahl mit aktuellen erfolgreichen Zielseiten vergleichen.
- Entwürfe, noindex-Angaben und tatsächlichen Zugriffsschutz getrennt behandeln.
- Unbekannte Ziele als fehlende Nachweise statt als erfundene Antworten ausgeben.
- Kontrollierte Gegenproben von echten HTTP-Abrufen unterscheiden.
- Nach einer Veröffentlichung den ausgelieferten Weg erneut prüfen.
Die drei Signale passen dann zusammen, wenn sie dieselbe beabsichtigte Zuordnung unterstützen und ihre unterschiedlichen Aufgaben erhalten bleiben. Der alte Pfad führt nachvollziehbar zum vorgesehenen Ziel. Die Zielseite benennt eine passende Präferenz. Die Sitemap enthält die tatsächlich gewünschten aktuellen Adressen. Genau diese überprüfbare Abstimmung ist das Ziel unseres Beispiels, ohne daraus eine Indexierungs- oder Rankingzusage zu machen.
Parameter und alte Verweise gezielt behandeln
Eine reale alte Adresse kann neben dem Pfad weitere Angaben enthalten. Manche sind fachlich relevant, andere beschreiben nur eine Kampagnenherkunft. Eine pauschale Regel, die sämtliche Suchparameter entfernt, könnte deshalb wichtige Auswahlzustände verlieren. Im Lehrfall gibt es bewusst keine solchen Varianten. Für eine Erweiterung würden wir zuerst konkrete alte Adressen mit ihren erwarteten neuen Zielen sammeln und pro Parameter entscheiden, ob seine Bedeutung erhalten bleiben muss.
Auch interne Verweise sollten die tatsächlich gewünschte Zieladresse verwenden. Bleibt eine alte Adresse in einer Leistungsübersicht stehen, ist die Weiterleitung weiterhin nötig, obwohl beide Inhalte schon angepasst wurden. Der technische Übergang und die redaktionelle Linkpflege sind deshalb getrennte Aufgaben. Eine erfolgreiche Prüfung des alten Pfads beantwortet noch nicht, ob sämtliche eigenen Navigations- und Inhaltslinks bereits das direkte Ziel nennen. Unser kleiner Baustein enthält keinen vollständigen Linkcrawler und weist dafür auch keinen Abschluss aus.
Einen Beobachtungsstand als Momentaufnahme dokumentieren
Die erfassten Antworten gehören zu einem bestimmten Prüflauf. Eine spätere Änderung am Server kann die gleiche Adresse anders beantworten lassen. Der Bericht sollte daher den Erhebungszeitpunkt und die zugrunde liegenden Beobachtungen erhalten. Für unsere künstliche Probe werden die tatsächlichen Antworten in einer eigenen Ergebnisdatei gespeichert. Die Gegenproben arbeiten auf Kopien dieses Bestands und verändern nicht heimlich die als ursprüngliche Beobachtung bezeichneten Daten.
Bei einem realen Übergang hilft dieselbe Trennung zwischen vorherigem Stand, beabsichtigter Änderung und erneutem Nachweis. Falls ein Befund unerwartet ausfällt, kann das Team die konkrete erste Antwort mit der späteren vergleichen. Ein bloßer grüner Gesamthaken ohne gespeicherte Wege wäre dafür weniger hilfreich. Die Sicherung eines Berichts macht allerdings aus einer engen Probe keine vollständige Prüfung aller möglichen Adressen. Umfang und Zeitpunkt bleiben gemeinsam Bestandteil der Aussage.