JavaScript und CSS erst für die passende Aufgabe laden
Fünf vollständige Dateien, vier künstliche Aufgaben und zwanzig echte Edge-Fälle verbinden Bedarfsladung mit einer belastbaren Grundfunktion.
Eine Webseite muss nicht jede Funktion bereits beim ersten Aufruf vollständig herunterladen. Sie braucht aber die Inhalte und Gestaltung, die für den ersten sinnvollen Arbeitsschritt notwendig sind. Wir entwickeln eine lesbare HTML-Tabelle, deren Sortierfunktion erst bei ihrer tatsächlichen Verwendung geladen wird. Ein echter Browserversuch zeigt dabei nicht nur den Erfolgsfall, sondern auch einen ausbleibenden Modulabruf und fehlendes Zusatz-CSS. Alle Daten sind künstliche Lernwerte. Aus den beobachteten Anfragen wird kein erfundener Ladezeitgewinn berechnet.
Den notwendigen ersten Arbeitsschritt festlegen
Unsere Beispielseite zeigt vier fiktive Aufgaben mit geplanten Minuten. Beim Öffnen soll eine Person die Namen und Werte unmittelbar lesen können. Sortieren ist eine zusätzliche Hilfe, aber keine Voraussetzung dafür, den Inhalt zu verstehen. Diese fachliche Trennung bestimmt die technischen Grenzen. Die Tabelle und ihre grundlegenden Stile gehören zum ersten Dokument. Die eigentliche Sortierlogik kann dagegen auf eine spätere bewusste Aktion warten. Ohne diese Entscheidung wäre „nach Bedarf laden“ nur eine technische Formulierung ohne überprüfbaren Bedarf.
Die Ausgangsreihenfolge lautet Planung, Abgleich, Nachweis und Prüfung. Zwei Aufgaben besitzen denselben Planwert. Dadurch muss die zusätzliche Funktion auch eine feste Regel für Gleichstände erhalten. Eine zufällige Reihenfolge wäre zwar optisch möglicherweise unauffällig, könnte aber beim wiederholten Sortieren irritieren. Wir verwenden deshalb eine interne Kennung als zweite Sortiergröße. Diese Kennungen sind künstliche Beispieldaten und keine Aussagen über echte Arbeitsaufträge. Die Planminuten sind ebenfalls keine gemessenen Laufzeiten des Programms.
Inhalt zuerst als brauchbares HTML liefern
Die HTML-Datei enthält die gesamte Tabelle mit Beschriftung, Kopfzellen und vier Zeilen. Der Browser muss keinen zusätzlichen JSON-Dienst aufrufen, um die vorhandenen Werte überhaupt darstellen zu können. Ohne JavaScript bleibt genau diese Information erreichbar. Die noch nicht verfügbare Sortierschaltfläche ist zunächst verborgen. Sie erscheint erst, wenn der kleine Einstiegsbaustein seinen Ereignishandler bereitstellt. So steht kein scheinbar bedienbares Element im Dokument, das bei abgeschalteter Skriptausführung einfach ohne Wirkung bliebe.
Diese Grundlage ist keine vollständige Anwendung ohne JavaScript. Sie erfüllt nur die bewusst festgelegte Grundaufgabe des Lesens. Wer zusätzlich eine Sortierung ohne JavaScript benötigt, könnte sie serverseitig als eigene Anfrage umsetzen. Unser Lehrfall behauptet diese zweite Funktion nicht. Er zeigt eine klare Abstufung zwischen vorhandenen Informationen und einer optionalen Erweiterung. Für eine echte Leistungsseite müsste dieselbe Trennung aus ihren tatsächlichen Aufgaben abgeleitet werden, statt jede Interaktion pauschal als entbehrliches Zusatzmerkmal einzustufen.
Grundgestaltung und Zusatzgestaltung auseinanderhalten
Die Datei base.css enthält die lesbare Typografie, Tabellenabstände, Farben, Fokusdarstellung und das Verhalten bei wenig Platz. Diese Regeln werden sofort eingebunden. Die optionale Datei feature.css ergänzt lediglich eine sichtbare Gestaltung des Sortierhinweises. Wenn sie fehlt, bleiben Tabelle, Schaltfläche und Fokus weiterhin brauchbar. Diese Aufteilung ist wesentlich: Eine nachgeladene Datei darf nicht heimlich die einzige Regel enthalten, durch die eine bereits sichtbare Bedienung verständlich oder ausreichend erkennbar wird.
Die Dokumentation des link-Elements beschreibt die Einbindung externer Stylesheets. In unserem eigenen Ablauf wird ein zusätzliches Linkelement erst bei der ersten Sortieraktion erstellt. Wir müssen deshalb nicht allein aus einem Dateinamen oder einer Medienangabe ableiten, ob eine Anfrage stattgefunden hat. Der unabhängige HTTP-Server protokolliert den tatsächlichen Abruf. Die grundlegende Gestaltung bleibt davon getrennt und wird bei jeder normalen Beispielansicht bereits zu Beginn angefordert.
Ein Einstiegsmodul ist noch keine vollständige Bedarfsladung
Die HTML-Seite bindet main.mjs als Modul ein. Dieser kleine Baustein findet die vorhandenen Elemente, blendet die Schaltfläche ein und reagiert auf ihre Verwendung. Würde er die gesamte Sortierlogik statisch importieren, gehörte diese weiterhin zur anfänglichen Abhängigkeitskette. Die bloße Aufteilung in mehrere Dateien würde daran nichts ändern. Unser Einstieg hält deshalb nur den später benötigten dynamischen Import bereit. Vor der ersten Aktion wird der entsprechende Ausdruck nicht ausgewertet.
Die MDN-Dokumentation zum script-Element unterscheidet unter anderem Modulausführung, defer und async. Diese Mechanismen beschreiben das Laden und Ausführen eingebundener Skripte. Sie ersetzen nicht die Entscheidung, ob eine bestimmte Funktion beim Anfang überhaupt benötigt wird. Im Lehrfall ist diese Funktion erst durch eine Sortieraktion begründet. Eine echte Anwendung kann andere Grenzen haben, beispielsweise eine unmittelbar benötigte Navigation, deren Verhalten nicht einfach auf eine spätere Zusatzdatei verschoben werden darf.
Die erste Verwendung mit import() verbinden
Der Ereignishandler ruft bei Bedarf import('./sorter.mjs') auf. Das Ergebnis wird als Promise behalten. Nach dem erfolgreichen Laden kann der Handler die exportierte Sortierfunktion verwenden. Die Referenz zu import() beschreibt den dynamischen Modulabruf und seine Fehlerfälle. Für unser Beispiel ist besonders wichtig, dass ein fehlgeschlagener Abruf nicht als erfolgreiche Vorbereitung der Funktion behandelt wird. Die Tabelle darf in diesem Fall nicht behaupten, sie sei bereits umgeordnet.
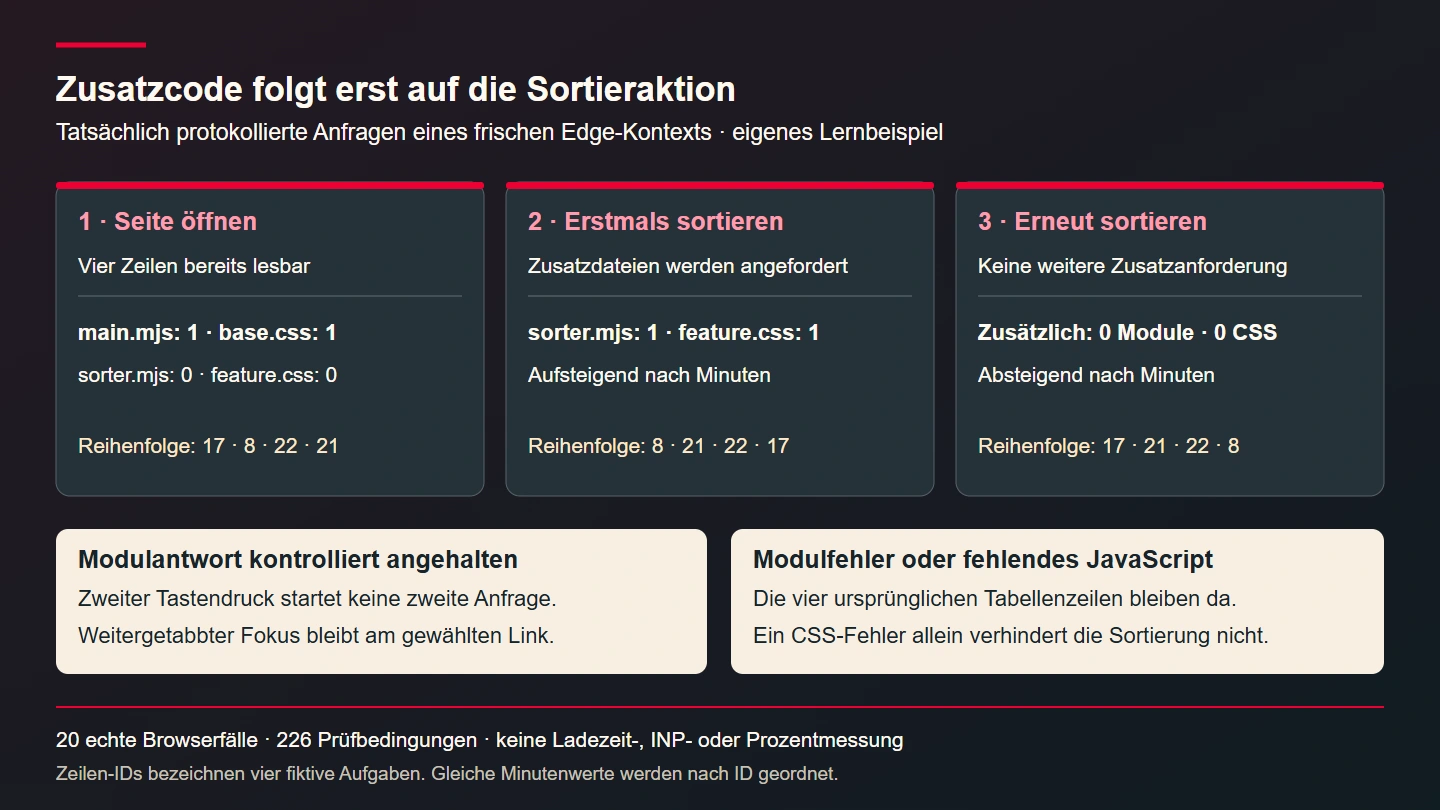
Vor der ersten Verwendung enthält das tatsächliche Ursprungsprotokoll keine Anfrage an /sorter.mjs und keine an /feature.css. Nach der ersten erfolgreichen Aktion enthält es je eine. Beim erneuten Sortieren kommen im beobachteten Dokument keine weiteren Abrufe dieser beiden Dateien hinzu. Wir behalten das bereits begonnene Importergebnis und erzeugen das zusätzliche Stylesheet nur einmal. Diese konkrete Beobachtung betrifft den gezeigten Ablauf. Sie ist keine allgemeine Aussage darüber, welche Dateien ein beliebiges Buildsystem erzeugt oder vorab lädt.
| Beobachteter Schritt | Sortiermodul | Zusatz-CSS | Inhalt |
|---|---|---|---|
| Seite geöffnet | Noch kein Abruf | Noch kein Abruf | Vier Zeilen bereits vorhanden |
| Erste Sortieraktion | Ein tatsächlicher Abruf | Ein tatsächlicher Abruf | Aufsteigende Planwerte |
| Zweite Sortieraktion | Kein zusätzlicher Abruf | Kein zusätzlicher Abruf | Absteigende Planwerte |
Eine laufende Aktion gegen doppelte Ausführung schützen
Ein Modul kann beim ersten Zugriff noch unterwegs sein. Zwei schnelle Aktivierungen sollen deshalb nicht zwei widersprüchliche Sortierungen auslösen. Der Handler setzt einen eigenen Beschäftigtzustand und lehnt währenddessen weitere Aktionen ab. Die Schaltfläche erhält zugleich aria-disabled="true". Dieses Attribut ersetzt den tatsächlichen Schutz im JavaScript nicht. Erst die vorgeschaltete Bedingung stellt sicher, dass eine weitere ausgelöste Aktion in diesem Zustand keine zusätzliche Arbeit beginnt.
Im Prüfaufbau halten wir die Modulantwort kontrolliert zurück. Während der ausstehenden Antwort wird eine zweite Tastaturaktivierung ausgelöst. Die Reihenfolge bleibt zunächst unverändert und der Server registriert weiterhin nur einen Modulabruf. Anschließend geben wir genau diese Antwort frei. Der erste Sortiervorgang wird dann abgeschlossen. Das ist ein gezielter Ablaufversuch und kein gemessener Vergleich unterschiedlicher Internetgeschwindigkeiten. Eine künstliche feste Wartezeit wird nicht als reale Ladezeit eines Nutzers ausgegeben.
Den Fokus während des Wartens respektieren
Die Sortierung setzt den Fokus nicht auf eine andere Stelle. Wer an der Schaltfläche bleibt, kann danach weiter mit ihr arbeiten. Wer während des ausstehenden Modulabrufs zur nächsten Verknüpfung wechselt, soll nach dem Abschluss dort bleiben. Das Programm ruft deshalb nicht vorsorglich eine Fokusfunktion auf. Eine späte Antwort darf nicht allein wegen ihres Eintreffens die inzwischen weitergeführte Tastaturbedienung wieder an einen älteren Arbeitsschritt zurückziehen.
Diese Bedingung wird tatsächlich geprüft. Während die Modulantwort zurückgehalten ist, geht die Tastatur zur nächsten Verknüpfung. Nach Freigabe und Sortierung bleibt diese Verknüpfung aktiv. Die Tabelle erhält für den ausstehenden Zustand eine Busy-Angabe, die nach Abschluss wieder entfernt wird. Zusätzlich beschreibt ein Statusbereich die abgeschlossene Reihenfolge. Das sind gezielte Zustands- und Fokusprüfungen. Sie ersetzen keinen vollständigen Test mit allen unterstützten Hilfstechnologien oder sämtlichen Bedienweisen einer produktiven Anwendung.
Die Sortierung klein und nachvollziehbar halten
Das nachgeladene Modul kennt nur seine begrenzte Aufgabe: vorhandene Tabellenzeilen nach Planwert und Kennung anordnen. Es holt keine weiteren Daten und ersetzt nicht die ganze Tabelle durch einen neu zusammengesetzten HTML-Text. Dadurch bleiben die ursprünglich vorhandenen Namen und Werte erhalten. Aufsteigend steht Abgleich vor Prüfung, Nachweis und Planung. Bei gleichem Planwert kommt die Kennung 21 vor 22. Absteigend bleibt dieselbe feste Regel für den Gleichstand erhalten.
Die Zahlen werden aus den kontrollierten Datenattributen des Beispiels gelesen. Der Baustein führt einfache Ganzzahlprüfungen durch, ist aber kein allgemeiner Eingangsprüfer für beliebige fremde Daten. Eine Anwendung mit nachgeladenen oder benutzerveränderten Werten müsste diese Quelle gesondert absichern. Hier liegt der Nutzen in einer klaren Zuständigkeit des Moduls. Seine geringe Größe allein wäre kein Beweis für eine sichere oder fachlich richtige Sortierung. Dafür prüfen wir die tatsächlichen Ergebnisreihenfolgen unabhängig von ihrer sichtbaren Darstellung.
Die aktuelle Reihenfolge verständlich auszeichnen
Nach einer erfolgreichen Aktion setzt der Handler die Sortierangabe an der betreffenden Kopfzelle. Gleichzeitig erhält die Schaltfläche eine Beschriftung für die nächste mögliche Richtung. Der Statusbereich beschreibt die gerade hergestellte Ordnung. Diese Informationen haben verschiedene Aufgaben und sollten nicht mit einer einzigen wechselnden Pfeilgrafik verwechselt werden. Eine Darstellung nur über Farbe könnte die Bedeutung der Änderung verdecken. Im Beispiel bleibt der Zustand deshalb auch als Text und über die passende Eigenschaft nachvollziehbar.
Das WAI-Beispiel für sortierbare Tabellen zeigt die Verwendung semantischer Tabellen und aria-sort und benennt zugleich Grenzen von Beispielcode. Unser eigener Aufbau ist eine kleinere einzelne Sortierspalte. Wir übernehmen daraus keine pauschale Zusage über sämtliche Screenreader. Die tatsächliche Produktprüfung muss passende Hilfstechnologien und Anwendungsabläufe einschließen. Das vorliegende Experiment belegt die hier protokollierten Browserzustände und Tastaturaktionen mit seinem eigenen Code.
Den Fehlerfall ohne Datenverlust gestalten
Ein weiterer Prüfmodus antwortet beim Modulabruf tatsächlich mit 404. Die Tabelle bleibt danach in ihrer Ausgangsreihenfolge. Es erscheint keine falsche Sortierbestätigung und keine neue Sortierangabe an der Kopfzelle. Der Status beschreibt, dass die zusätzliche Sortierung nicht geladen werden konnte. Die bereits vorhandenen Inhalte bleiben lesbar. Für diesen Lehrfall wird die gescheiterte Zusatzaktion nicht erneut angeboten, als sei ein weiterer Klick bereits eine verlässlich funktionierende Wiederherstellung.
Das ist eine bewusst begrenzte Fehlerstrategie. Eine größere Anwendung könnte einen kontrollierten erneuten Versuch oder einen serverseitigen Ersatz anbieten. Dafür wären aber weitere Bedingungen zu klären, etwa der Zustand bereits ausgewerteter Module und die eindeutige Version der gewünschten Datei. Unser Beispiel verspricht diese zusätzlichen Wege nicht. Der dokumentierte Fehlerzustand ist sinnvoller als ein scheinbar fertiger Wiederholknopf, dessen Verhalten bei einem Auswertungsfehler nie untersucht wurde.
Fehlendes Zusatz-CSS von fehlender Funktion unterscheiden
Im CSS-Gegenversuch scheitert nur die optionale Stylesheetantwort. Das Sortiermodul wird normal geladen und die Tabellenzeilen werden korrekt angeordnet. Die zusätzliche Gestaltung des Statushinweises fehlt dann, die grundlegende Lesbarkeit und Fokusdarstellung bleiben jedoch erhalten. Dieser Fall prüft die zuvor getroffene Aufteilung tatsächlich. Wenn das Ergebnis ohne die Datei unverständlich wäre, hätten wir wesentliche Gestaltung versehentlich als entbehrliches Extra behandelt und müssten die Grenze neu ziehen.
Die Reihenfolge der fachlichen Funktion wird hier nicht vom Laden des dekorativen Stylesheets abhängig gemacht. Das ist nur deshalb angemessen, weil die Basisdatei alle notwendigen Informationen bereits brauchbar gestaltet. Bei einem anderen Baustein kann ein zusätzliches Stylesheet für seine tatsächliche Nutzung unverzichtbar sein. Dann muss der Lade- und Fehlerablauf diesen Unterschied berücksichtigen. Eine technische Vorliebe für möglichst spätes Laden sollte nicht die reale Aufgabe der Person überstimmen, die den Baustein bedienen möchte.
Die fünf vollständigen Dateien zusammen lesen
Das Beispiel besteht aus dem HTML-Dokument, einer Basisgestaltung, dem Einstiegsmodul, dem Sortiermodul und der optionalen Zusatzgestaltung. Die folgenden Fassungen entsprechen den tatsächlich geprüften Dateien. Der Prüfserver lieferte die Module mit einem JavaScript-Medientyp aus und startete auf einer freien Loopbackadresse. Ein einfacher Abruf über das Dateisystem ist kein gleichwertiger Nachweis über denselben Modulpfad und die gleiche Serverantwort. Für die eigene Ausführung werden die Dateien gemeinsam über einen passenden HTTP-Server bereitgestellt.
Die Datei enthält keine Verbindung zu einem echten Kundenbestand. Alle vier Aufgaben und ihre Planwerte sind künstlich. Der Prüfablauf veränderte nur die Reihenfolge dieser vorhandenen Elemente. Es gab weder eine neue Auftragsfreigabe noch eine Zeiterfassung. Diese Abgrenzung ist besonders bei einem anschaulichen Beispiel wichtig: Eine sortierbare Zeile darf nicht durch ihre professionelle Darstellung den Eindruck erwecken, sie dokumentiere einen tatsächlich bearbeiteten Kundenauftrag.
example-de.html
<!doctype html><html lang="de"><meta charset="utf-8"><meta name="viewport" content="width=device-width,initial-scale=1"><title>Aufgaben vergleichen</title><link rel="stylesheet" href="/base.css"><script type="module" src="/main.mjs"></script><main><h1>Aufgaben vergleichen</h1><div class="table-wrap"><table><caption>Vier fiktive Aufgaben mit geplanten Minuten. Die Spalte Minuten kann sortiert werden.</caption><thead><tr><th scope="col">Aufgabe</th><th id="minutes-heading" scope="col"><span>Minuten</span> <button id="sort" type="button" hidden>Minuten aufsteigend sortieren</button></th></tr></thead><tbody><tr data-id="17" data-minutes="45"><th scope="row">Planung</th><td>45</td></tr><tr data-id="8" data-minutes="15"><th scope="row">Abgleich</th><td>15</td></tr><tr data-id="22" data-minutes="30"><th scope="row">Nachweis</th><td>30</td></tr><tr data-id="21" data-minutes="30"><th scope="row">Prüfung</th><td>30</td></tr></tbody></table></div><p class="order-note" id="status" role="status">Quellreihenfolge</p><a href="#details">Weiterführende Angaben</a><h2 id="details">Weiterführende Angaben</h2><p>Die geplanten Werte gehören zu einem künstlichen Lernbeispiel.</p></main></html>base.css
*{box-sizing:border-box}body{margin:0;background:#fff9ef;color:#242a2e;font:18px/1.5 Arial,sans-serif}main{max-width:860px;margin:0 auto;padding:24px}h1{font-size:clamp(25px,4vw,38px)}.table-wrap{max-width:100%;overflow:auto}table{border-collapse:collapse;width:100%;background:#fff}caption{text-align:left;margin-bottom:16px}th,td{padding:12px;text-align:left;border-bottom:1px solid #777}th[scope=row]{font-weight:400}button{font:inherit;font-size:16px;padding:10px;background:#b80024;color:#fff;border:2px solid transparent;cursor:pointer}button:focus-visible,a:focus-visible{outline:3px solid #242a2e;outline-offset:4px}button[aria-disabled=true]{opacity:.7}a{color:#a90022}[hidden]{display:none!important}@media(prefers-color-scheme:dark){body{background:#15191c;color:#fff9ef}table{background:#20262a}a{color:#ffb4c0}button:focus-visible,a:focus-visible{outline-color:#fff9ef}}main.mjs
const button=document.querySelector('#sort'),table=document.querySelector('table'),status=document.querySelector('#status'),heading=document.querySelector('#minutes-heading');
const en=document.documentElement.lang==='en',labels=en?{loading:'Preparing sorting.',asc:'Minutes sorted ascending.',desc:'Minutes sorted descending.',error:'Sorting could not be loaded. The table remains readable.',nextAsc:'Sort minutes ascending',nextDesc:'Sort minutes descending'}:{loading:'Sortierung wird vorbereitet.',asc:'Minuten aufsteigend sortiert.',desc:'Minuten absteigend sortiert.',error:'Sortierung konnte nicht geladen werden. Die Tabelle bleibt lesbar.',nextAsc:'Minuten aufsteigend sortieren',nextDesc:'Minuten absteigend sortieren'};
let busy=false,failed=false,modulePromise,styleRequested=false,nextAscending=true;
button.hidden=false;
button.addEventListener('click',async()=>{
 if(busy||failed)return;busy=true;button.setAttribute('aria-disabled','true');table.setAttribute('aria-busy','true');status.textContent=labels.loading;
 if(!styleRequested){styleRequested=true;const link=document.createElement('link');link.rel='stylesheet';link.href='/feature.css';document.head.append(link);}
 try{modulePromise??=import('./sorter.mjs');const {reorder}=await modulePromise;reorder(table,nextAscending);heading.setAttribute('aria-sort',nextAscending?'ascending':'descending');status.textContent=nextAscending?labels.asc:labels.desc;status.classList.add('sorted');nextAscending=!nextAscending;button.textContent=nextAscending?labels.nextAsc:labels.nextDesc;}
 catch{failed=true;status.textContent=labels.error;}
 finally{busy=false;table.removeAttribute('aria-busy');if(!failed)button.removeAttribute('aria-disabled');}
});
sorter.mjs
export function reorder(table,ascending){const rows=[...table.tBodies[0].rows];for(const row of rows)if(!Number.isSafeInteger(Number(row.dataset.minutes))||!Number.isSafeInteger(Number(row.dataset.id)))throw new TypeError('Invalid teaching data');rows.sort((a,b)=>(ascending?1:-1)*(Number(a.dataset.minutes)-Number(b.dataset.minutes))||Number(a.dataset.id)-Number(b.dataset.id));for(const row of rows)table.tBodies[0].append(row);}feature.css
.order-note.sorted{border-inline-start:6px solid #b80024;padding-inline-start:12px;font-weight:700}Die zwanzig Browserfälle und ihre Aussage lesen
Die Prüfung verwendete frische Edge-Kontexte für Deutsch und Englisch, Breiten von 320, 390 und 1440 Pixeln sowie helle und dunkle Darstellung. Hinzu kamen je Sprache abgeschaltetes JavaScript, ein fehlgeschlagenes Modul, fehlendes Zusatz-CSS und eine kontrolliert ausstehende Modulantwort. Insgesamt bestanden zwanzig Fälle mit 226 einzeln geprüften Bedingungen. Die tatsächlich verwendete Browserversion war 157.0.4341.42. Der eigene HTTP-Prüfserver lief mit Node.js 24.22.1.
Zu den beobachteten Ergebnissen gehören Reihenfolge, Gleichstandsregel, Anzahl konkreter Dateiabrufe, Busy-Zustand, Sortierangabe, Fokus und fehlender Seitenüberlauf. Eine Komplettprüfung jeder denkbaren Tabellenfunktion war das nicht. Insbesondere wurden keine Ladezeit, kein INP-Feldwert und keine allgemeine Geschwindigkeit auf einem Mobilgerät gemessen. Die kleine Datei liefert eine gute technische Erklärung, aber keinen statistischen Nachweis darüber, wie oft Besucher einer realen Webseite die Funktion verwenden würden.
Die passende Ladegrenze aus dem Produkt ableiten
Die Einführung zu Code Splitting auf web.dev erläutert die Aufteilung anfänglich benötigter und später benötigter Skripte. Für unsere Produktentscheidung reicht ein allgemeiner Hinweis auf kleinere Anfangslasten jedoch nicht. Wir müssen zusätzlich wissen, wann eine Funktion gebraucht wird und welche Warte- oder Fehlerzustände dann entstehen. Eine selten benötigte Sortierung kann eine andere Grenze rechtfertigen als ein zentraler Bestellschritt, auf den fast jede Person unmittelbar angewiesen ist.
Eine echte Optimierung verbindet deshalb eine beobachtete Nutzung mit einer passenden technischen Änderung und erneuter Prüfung. Es kann sinnvoll sein, einen häufig benötigten Baustein früh bereit zu halten. Auch ein zusätzlicher Dateiaufruf ist nicht grundsätzlich falsch. Entscheidend bleibt die gesamte Aufgabe mit ihrem Erfolgs- und Fehlerweg. Unser Experiment macht die Grenze bewusst einfach, damit die Beobachtung erklärbar bleibt. Es fordert nicht, sämtliche Anwendungen in möglichst viele kleine Dateien aufzuteilen.
Veröffentlichung und Dateiversionen gemeinsam planen
Eine später angeforderte Datei muss auch später noch zur bereits geöffneten Hauptseite passen. Wenn bei einer Veröffentlichung alte Moduldateien sofort verschwinden, könnte ein längerer geöffneter Auftritt erst bei seiner nächsten Aktion scheitern. Für eine reale Einführung gehört deshalb eine abgestimmte Strategie für Dateinamen, alte Fassungen und Rückwege dazu. Unser isolierter Versuch enthält keine echte Produktionsveröffentlichung und behauptet auch keine ausgeführte Prüfung dieses längeren Übergangs.
Die einmalige Wiederverwendung im geöffneten Beispiel ist außerdem von einem erneuten Seitenaufruf zu unterscheiden. Eine neue Dokumentumgebung durchläuft ihre eigene Vorbereitung. Ob dabei eine Antwort aus dem HTTP-Cache kommt, ist eine weitere Ebene. Der Prüfserver verwendet absichtlich keine wiederverwendbaren HTTP-Antworten, während der erfolgreiche Import im laufenden Dokument verfügbar bleibt. Diese Trennung verhindert, dass ein beobachteter fehlender Zweitabruf vorschnell als vollständige Aussage über alle Cachezustände ausgegeben wird.
Dateizahl und tatsächliche Arbeit getrennt bewerten
Eine geringere Zahl anfänglicher Abrufe ist nicht automatisch dasselbe wie eine kleinere Datenmenge. Eine einzelne sehr große Datei kann mehr übertragen als mehrere gezielt benötigte kleine Dateien. Umgekehrt erzeugt jede zusätzliche Abhängigkeit einen eigenen Fehler- und Veröffentlichungsweg. Für eine reale Optimierung sollten deshalb die tatsächlich übertragenen Inhalte, ihre notwendige Auswertung und die Aufgabe der Person gemeinsam betrachtet werden. Unser Beispiel liefert einen nachvollziehbaren Ausgangspunkt für diese Bewertung und keine pauschale Regel nach der Anzahl von Dateinamen.
Die protokollierte Sortierung ist außerdem bewusst winzig. Bei einem so kleinen Modul kann eine Trennung aus praktischen Gründen anders bewertet werden als bei einer umfangreichen optionalen Auswertung. Das Experiment soll die Mechanik und ihre Grenzen verständlich machen. Es behauptet keinen wirtschaftlichen Vorteil für genau diese vier Tabellenzeilen. Ein Produktteam würde die gleiche Ladegrenze mit seinen tatsächlichen Funktionen und geeigneten Messungen prüfen, bevor es daraus eine dauerhafte Architekturentscheidung ableitet.
Checkliste für eine belastbare Bedarfsladung
- Den ersten sinnvollen Arbeitsschritt und seine notwendigen Inhalte bestimmen.
- Grundlegende Gestaltung und Fokusregeln rechtzeitig bereitstellen.
- Statische Dateiaufteilung von tatsächlich späterem Abruf unterscheiden.
- Den ersten Bedarf an eine klare erlaubte Aktion knüpfen.
- Laufende Aktionen gegen doppelte Ausführung absichern.
- Fokus und weitergeführte Bedienung bei späten Antworten erhalten.
- Module und optionale Stylesheets mit echten Fehlerantworten prüfen.
- Vorhandene Inhalte bei fehlgeschlagener Erweiterung erhalten.
- Beobachtete Dateiabrufe von gemessenen Ladezeiten unterscheiden.
- Bereits geöffnete Dokumente bei der Veröffentlichung neuer Fassungen berücksichtigen.
Gute Bedarfsladung zeigt sich nicht allein an einer kleineren anfänglichen Dateiliste. Sie stellt den ursprünglichen Inhalt bereit, erweitert ihn im passenden Moment und besitzt einen nachvollziehbaren Fehlerweg. Genau diese Eigenschaften lassen sich am kleinen Sortierbeispiel prüfen. Erst danach lässt sich entscheiden, welche vergleichbare Grenze im tatsächlichen Produkt sinnvoll ist und welche Wirkung dort gesondert gemessen werden sollte.