Caching im Browser und auf dem Server nachvollziehbar prüfen
16 Browserabrufe und 44 geprüfte Bedingungen machen frische Antworten, no-cache, no-store und einen eigenen Anwendungsspeicher unterscheidbar.
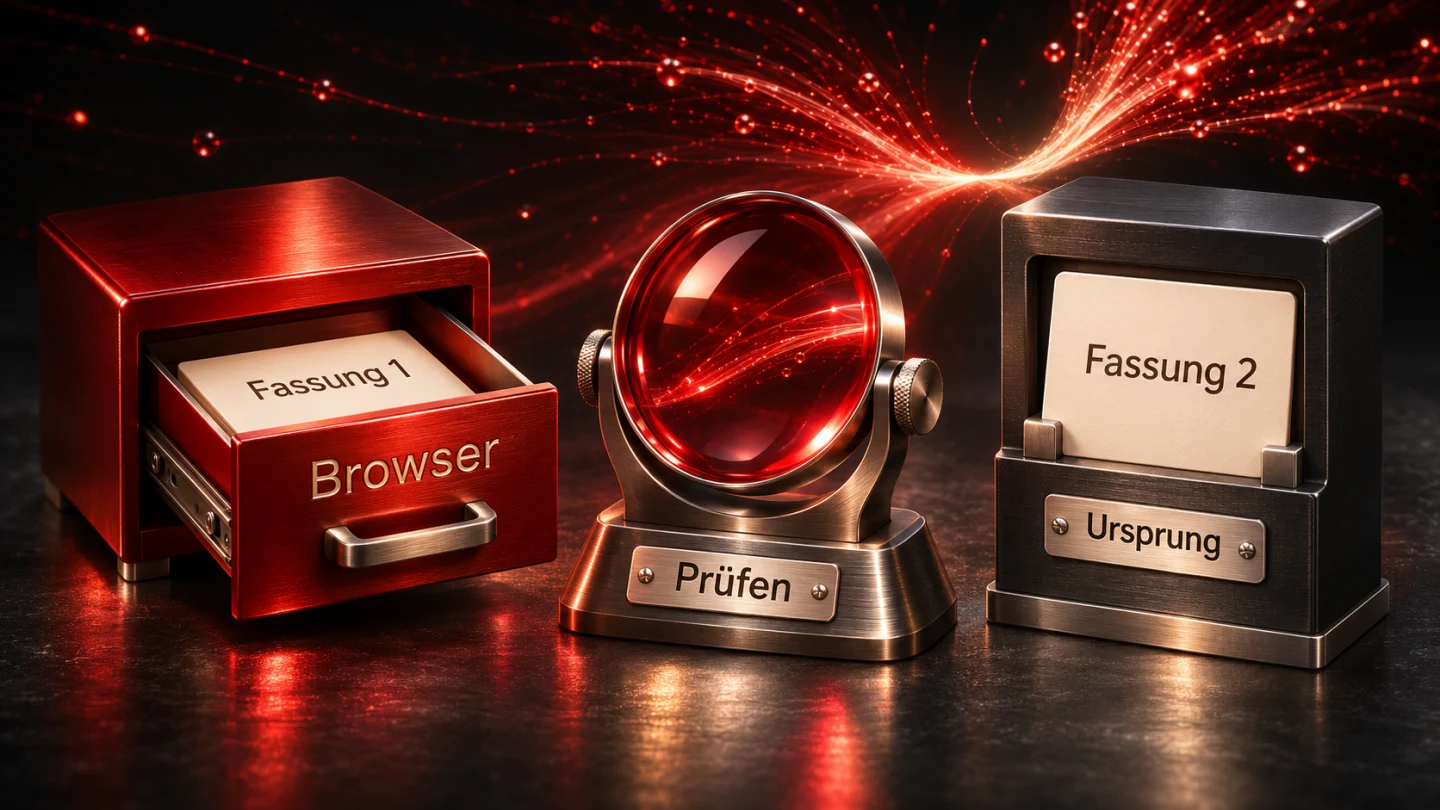
Caching bedeutet, eine bereits vorhandene Antwort oder ein berechnetes Ergebnis gezielt erneut zu verwenden. Entscheidend sind dabei drei Fragen: Wer speichert die Kopie, unter welchen Bedingungen darf sie wiederverwendet werden und wodurch wird eine Änderung sichtbar? Wir beantworten diese Fragen an einem tatsächlichen Browserversuch mit künstlichem Inhalt. Der Versuch unterscheidet frische Browserantworten, eine Prüfung beim Ursprung und einen eigenen Anwendungsspeicher auf dem Server. Er misst keine Ladezeit einer Kundenwebseite.
Das Problem an einem veränderten Praxistext verstehen
Unser fiktiver Praxistext beginnt mit Fassung 1. Eine Webseite lädt ihn mehrmals und soll unnötige Übertragungen vermeiden. Später veröffentlicht die Redaktion Fassung 2. Jetzt interessiert uns nicht nur, ob der Server bereits den neuen Text besitzt. Wir wollen wissen, welche Fassung ein Browser bei seinem nächsten Abruf tatsächlich erhält. Eine technisch erfolgreiche Antwort kann nämlich weiterhin die ausdrücklich noch wiederverwendbare alte Fassung enthalten. Ob das fachlich akzeptabel ist, muss zur vorher festgelegten Aktualitätsanforderung passen.
Für den Lehrfall nutzen wir eine isolierte Browserumgebung und einen selbst gestarteten Loopbackserver. Es gibt keine Anmeldung, keine persönlichen Inhalte und keinen vorgelagerten Auslieferungsdienst. Alle Fassungen sind künstlich. Der Server führt ein eigenes Protokoll der angekommenen Anfragen. Damit können wir die Anzeige im Browser mit einer unabhängigen Beobachtung am Ursprung vergleichen. Gerade diese zweite Sicht verhindert, dass eine einzelne Zahl im Netzwerkfenster vorschnell als Beweis für eine neue vollständige Übertragung ausgegeben wird.
Drei Speicherorte nicht zu einem einzigen Cache zusammenziehen
Der Browser kann eine HTTP-Antwort für seine weitere Verwendung behalten. Ein gemeinsamer Auslieferungsspeicher kann Antworten für mehrere Besucher vorhalten. Eine Anwendung kann außerdem ein bereits erzeugtes Ergebnis intern speichern, etwa einen fertig zusammengestellten Text. Diese Orte beantworten verschiedene Fragen. Ein ausgelieferter Cache-Control-Header regelt nicht automatisch, wie lange ein eigener Programmspeicher seine Daten behält. Umgekehrt entfernt das Leeren einer Programmliste keine bereits beim Browser vorhandene Antwort.
In unserem Beispiel gibt es nur zwei dieser Ebenen tatsächlich: den HTTP-Cache des verwendeten Edge-Browsers und eine Variable im eigenen Node.js-Prozess. Ein gemeinsamer Proxy oder CDN wird nicht mitgetestet. Wenn später ein solcher Dienst hinzukommt, braucht er eigene Regeln und Gegenproben. Seine Existenz darf weder aus einem schnellen zweiten Aufruf noch aus einem Cache-Header abgeleitet werden. Auch mehrere Serverprozesse würden die eine lokale Variable nicht plötzlich in einen gemeinsam konsistenten Speicher verwandeln.
Frische als vereinbarte Wiederverwendbarkeit betrachten
Eine frische Antwort liegt nach dem HTTP-Modell innerhalb ihrer Wiederverwendungsdauer. Das bedeutet nicht, dass niemand inzwischen den Ursprungsinhalt geändert haben kann. RFC 9111 beschreibt unter anderem Frische und Cacheanweisungen. Für unseren Versuch erlauben wir beim Pfad /fresh eine Dauer von 600 Sekunden. Die Wiederholung erfolgt kontrolliert innerhalb dieser Dauer. Wir behaupten damit weder einen gemessenen Ablauf nach zehn Minuten noch eine garantierte Speicherung bis zu diesem Zeitpunkt.
Beim ersten tatsächlichen Abruf kommt eine Anfrage am Server an. Beim zweiten erhält der Browser denselben Inhalt, ohne dass unser Ursprungsprotokoll einen weiteren Aufruf registriert. Das ist die beobachtete Wiederverwendung in genau diesem frischen Kontext. Ein Browser darf eine gespeicherte Antwort auch früher verwerfen. Die fachliche Planung sollte deshalb mit erlaubter Wiederverwendung arbeiten und keinen garantierten Speicherplatz versprechen. Für den Praxistext bleibt entscheidend, welchen alten Stand man während dieser erlaubten Dauer noch anzeigen darf.
no-cache und no-store anhand ihres nächsten Abrufs unterscheiden
Die Cache-Control-Dokumentation von MDN unterscheidet die Anweisungen ausdrücklich. Vereinfacht verlangt no-cache vor der Wiederverwendung eine erfolgreiche Prüfung beim Ursprung. no-store weist HTTP-Caches an, die Antwort nicht zu speichern. private begrenzt die Speicherung auf private Caches. Die Begriffe sind keine austauschbaren Zusätze, die man vorsorglich zu einer möglichst langen Headerzeile zusammensetzen sollte.
Im Experiment gehören diese Regeln zu getrennten Pfaden. So bleibt die beobachtete Ursache erkennbar. Eine Antwort unter /validate darf nach ihrer Prüfung erneut genutzt werden. Eine Antwort unter /sensitive soll der HTTP-Cache nicht speichern. Der Pfadname ist nur eine Kennzeichnung des Lehrfalls; tatsächlich enthält auch diese Antwort keine sensiblen Daten. Aus dem Namen allein entsteht weder eine Schutzfunktion noch eine überprüfte Datenschutzentscheidung für einen echten Anwendungsfall.
| Lehrpfad | Antwortregel | Beobachtete zweite Verwendung vor Änderung |
|---|---|---|
| /fresh | public, max-age=600 | Kein neuer Ursprungsaufruf |
| /private | private, max-age=600 | Kein neuer Ursprungsaufruf im Browser |
| /validate | no-cache | Ursprung antwortet 304 |
| /sensitive | no-store | Neuer Ursprungsaufruf mit 200 |
| /rendered | no-store | Neuer Aufruf, internes Ergebnis wiederverwendet |
Eine Versionskennung an die tatsächliche Darstellung binden
Ein ETag kennzeichnet eine bestimmte Darstellung. Die MDN-Erklärung zu ETag beschreibt unter anderem seine Verwendung bei unveränderten Ressourcen. Im eigenen Programm bilden wir eine Prüfsumme über genau den JSON-Text, den wir ausliefern. Ändert sich die künstliche Fassung im Text, ändert sich deshalb auch die Kennung. Eine zufällige Kennung bei jedem Abruf würde dagegen gerade die Wiedererkennung eines unveränderten Textes verhindern.
Der Client behandelt die Kennung als undurchsichtigen Wert. Er muss die Prüfsumme nicht selbst nachbilden und soll daraus auch keine Berechtigung ableiten. Für unsere Beobachtung reicht der Vergleich, ob die übermittelte Kennung zur aktuellen Darstellung passt. Die eingesetzte Prüfsumme belegt dabei keine fachliche Freigabe des Inhalts. Fassung 2 kann korrekt wiedererkannt werden und trotzdem redaktionell falsch sein. Die Verantwortlichkeit für den Inhalt bleibt von seiner technischen Wiedererkennung getrennt.
Die Prüfung mit If-None-Match nachvollziehen
Bei der Wiederverwendung des Validierungspfads sendet der Browser die vorhandene Kennung als Vorbedingung. Der Ursprung kann für GET und HEAD mit 304 antworten, wenn die Darstellung dazu passt. Die Bedeutung dieses Headers beschreibt die Dokumentation zu If-None-Match. Unser Lehrserver unterstützt dafür die hier nötige Prüfung. Er ist kein vollständiger allgemeiner Parser sämtlicher HTTP-Vorbedingungen und soll dafür auch nicht als fertige Bibliothek übernommen werden.
Im tatsächlichen Ursprungsprotokoll hat diese 304-Antwort keinen Antwortinhalt. Der Browser kann anschließend seinen vorhandenen Text nutzen. Für die Anwendung ergibt sich dadurch eine lesbare Antwort mit Inhalt, obwohl der Ursprung ihn nicht erneut vollständig übertragen hat. Die Prüfung spart in diesem beobachteten Fall die erneute Inhaltsübertragung. Sie beseitigt den Serverkontakt nicht. Wer diesen Unterschied übersieht, verwechselt die Entlastung des Datenwegs mit dem vollständigen Wegfall einer Netzwerkanfrage.
Warum JavaScript trotzdem eine Antwort mit 200 sieht
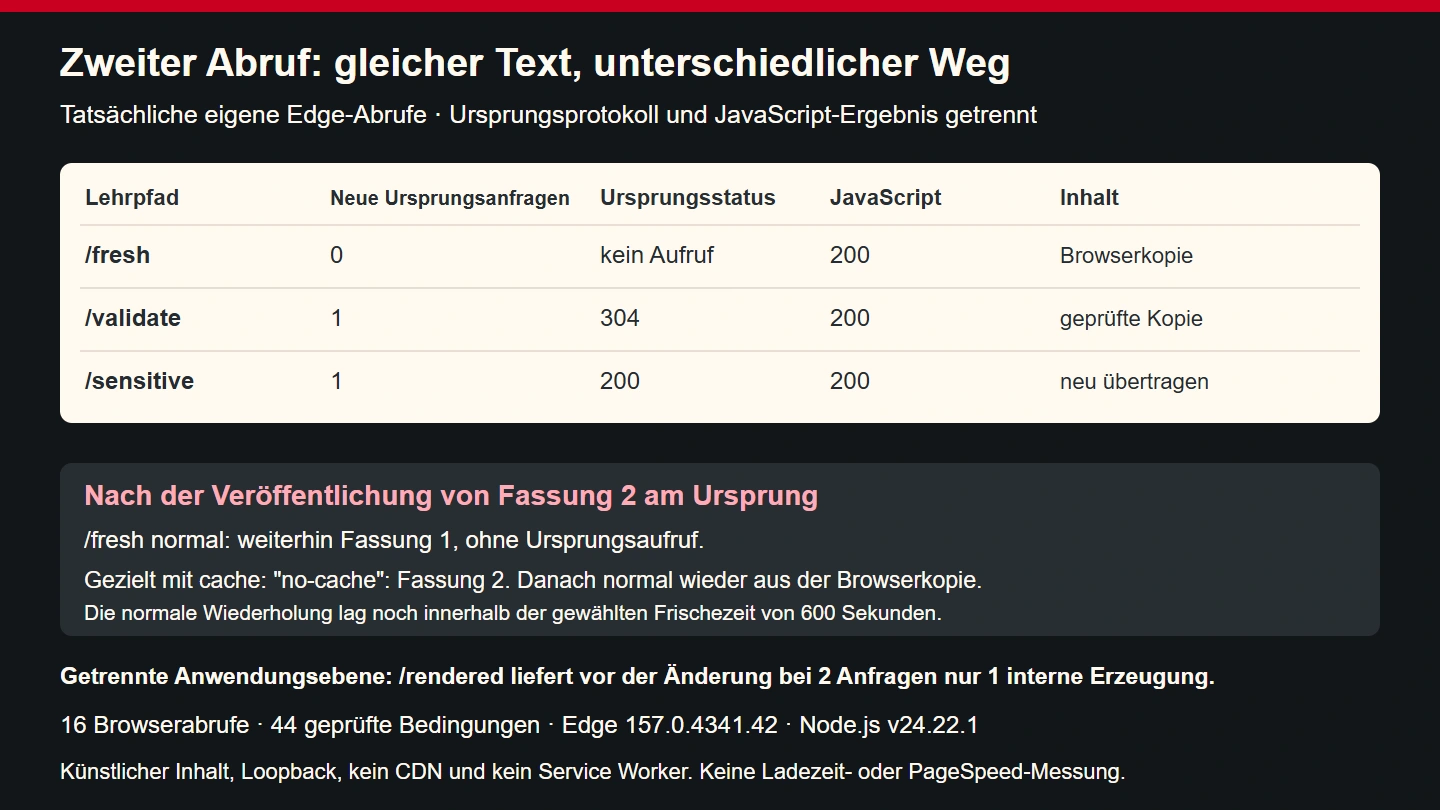
Unser Browsercode erhält beim zweiten Aufruf des Validierungspfads den Status 200 und kann den JSON-Inhalt lesen. Gleichzeitig protokolliert der Ursprung eine Antwort mit 304. Das ist kein Widerspruch im Prüfbericht. Es sind zwei Beobachtungsebenen desselben Abrufs. Der Browser führt seine gespeicherte Antwort und die erfolgreiche Prüfung zusammen. Für die Darstellung der Anwendung ist das wieder ein nutzbares Ergebnis. Wir halten deshalb ausdrücklich beide Werte fest, statt einen davon zum angeblich falschen Messwert zu erklären.
Als zusätzliche Gegenprobe senden wir die Vorbedingung direkt über einen HTTP-Client an den Ursprung. Dort beobachten wir tatsächlich 304 und einen leeren Antworttext. Die Probe bestätigt den Unterschied zur vom Browser aufbereiteten Antwort. Sie ist keine Aufforderung, in jedem Frontend 304 selbst als Sonderfall zu behandeln. Entscheidend ist vielmehr, welche Schicht das eigene Diagnosewerkzeug gerade zeigt. Ein nachvollziehbarer Bericht benennt Clientergebnis und Ursprungsantwort getrennt.
private nicht als automatischen Speicherverzicht auslegen
Beim privaten Lehrpfad bleibt die zweite Antwort im tatsächlich verwendeten Browser wiederverwendbar. Der Ursprung erhält keinen zweiten Aufruf. Das passt zu einer ausdrücklich privaten HTTP-Speicherung. Es beweist nicht, dass ein gemeinsamer Auslieferungsdienst korrekt konfiguriert wäre, denn einen solchen Dienst enthält der Versuch nicht. Es beweist ebenso wenig eine sichere Aufbewahrung persönlicher Daten auf einem gemeinsam genutzten Gerät. Die Kopie und die Berechtigung zur Anzeige sind verschiedene Planungsfragen.
Für ein echtes Benutzerkonto müsste man unter anderem betrachten, was beim Abmelden, Benutzerwechsel und Zurücknavigieren geschieht. Eine gespeicherte HTTP-Antwort ist dabei nicht die einzige mögliche Quelle einer alten Ansicht. Unser Lehrfall testet diese Kontosituationen bewusst nicht. Er nutzt nur künstlichen öffentlichen Text, um die Regel sichtbar zu machen. Eine sinnvolle Abnahme würde die wirkliche Kontodarstellung mit getrennten Identitäten und den tatsächlichen Systemen prüfen, statt aus diesem kleinen Versuch eine allgemeine Sicherheitszusage zu kopieren.
no-store von einer eigenen Anwendungskopie trennen
Der Pfad /rendered antwortet ebenfalls mit no-store. Der Browser fragt im Experiment deshalb zweimal den Ursprung. Trotzdem wird der Text in unserer Anwendung nur einmal für diese Fassung zusammengestellt. Die bereits berechnete Zeichenfolge liegt in einer eigenen Variable. Deren Verwendung kontrolliert der Programmcode und nicht der vom Server verschickte HTTP-Header. Hier sind also zwei HTTP-Anfragen mit zwei erfolgreichen Antworten und nur eine interne Erzeugung gleichzeitig möglich.
Genau diese Kombination ist bei der Diagnose nützlich. Eine höhere Zahl von Serverkontakten bedeutet nicht automatisch, dass dieselbe teure Berechnung jedes Mal vollständig wiederholt wird. Umgekehrt kann ein HTTP-Cache die Programmlogik ganz umgehen. Welche Arbeit tatsächlich entfällt, muss auf der passenden Ebene beobachtet werden. Unser Zähler erfasst nur den Aufruf der selbst definierten Erzeugungsstelle. Er misst keine Prozessorzeit, keine Datenbankabfragen und keine Einsparung bei einem echten redaktionellen System.
Eine Veröffentlichung gezielt durch alle Ebenen verfolgen
Die Prüfsteuerung setzt den Ursprung von Fassung 1 auf Fassung 2 und leert gleichzeitig den eigenen Anwendungsspeicher. Das ist ein bewusst modellierter Veröffentlichungsschritt, kein öffentlich erreichbarer Verwaltungsendpunkt. Anschließend fragen wir den frischen Browserpfad erneut mit seiner normalen Einstellung ab. Er liefert weiterhin Fassung 1, ohne neuen Serverkontakt. Der Ursprung weiß bereits von Fassung 2, der Browser muss ihn aufgrund seiner vorherigen Wiederverwendungsregel hier aber noch nicht fragen.
Beim nächsten gezielten Abruf mit einer Prüfung kommt Fassung 2 an. Danach kann der Browser diese Fassung wieder als frische Antwort verwenden. Der Validierungspfad verhält sich anders: Sein nächster Abruf fragt den Ursprung ohnehin und erhält den geänderten Inhalt vollständig. Eine weitere Wiederholung führt wieder zu 304. Dieses kleine Protokoll zeigt die eigentliche Anforderung an eine Veröffentlichung: Der gewünschte Aktualitätszeitpunkt muss zu jeder beteiligten Wiederverwendungsregel passen.
Die Clientoption nicht mit einer Antwortregel verwechseln
Die Fetch-Einstellung cache: "no-cache" ist eine Anforderung des aufrufenden Browsercodes. Sie ist nicht identisch mit dem gleichnamigen Antwortheader, den der Server für eine Ressource festlegt. Die Dokumentation der Request-cache-Eigenschaft beschreibt die verschiedenen Modi. Im Versuch verwenden wir die Option gezielt, um nach der künstlichen Veröffentlichung eine Prüfung anzustoßen. Wir erklären sie nicht zur pauschalen Vorgabe für sämtliche Abrufe einer Anwendung.
Ein überall erzwungener frischer Abruf würde die zuvor geplante Wiederverwendung möglicherweise wieder aushebeln. Eine zufällige Suchzeichenfolge an jeder Bildadresse kann ein ähnliches Problem erzeugen. Stattdessen sollten wir entscheiden, welche konkrete Ressource sofort aktuell sein muss und welche feste Fassung länger unverändert bleiben darf. Die Entscheidung gehört zum Inhalt und seinem Änderungsverfahren. Der Client sollte sie unterstützen, ohne unbemerkt für jede kleine Ansicht eine andere technische Regel zu erfinden.
Das vollständige Lehrprogramm nachvollziehen
Die Datei benötigt nur eingebaute Module von Node.js. Beim direkten Start bindet sie an die Loopbackadresse und zeigt eine kleine eigene Ausgangsseite. Alle Antworten enthalten denselben künstlichen Praxistext mit einer Fassungsnummer. Für den automatisierten Versuch wird die exportierte Fabrik auf einem freien Port gestartet. So kollidiert der Prüfablauf nicht mit einer möglicherweise schon verwendeten festen Adresse. Eine Freigabe des Programms als öffentlich erreichbarer Anwendungsdienst ist nicht Bestandteil dieses Beispiels.
Speichere den Inhalt als cache-demo.mjs und starte ihn mit node cache-demo.mjs. Die interne publish-Funktion dient nur der kontrollierten Prüfsteuerung. Sie demonstriert, dass Anwendungsspeicher und Browserkopie getrennt verändert werden. Die sichtbare Ausgangsseite stellt keine Verwaltungsfunktion bereit. Für einen echten redaktionellen Dienst wären dauerhafte Inhalte, Berechtigungen und ein belastbarer Veröffentlichungsvorgang zusätzlich zu entwickeln. Die folgende Datei beantwortet ausschließlich die hier beschriebenen Wiederverwendungsfragen.
import{createServer}from'node:http';import{createHash}from'node:crypto';import{pathToFileURL}from'node:url';
export function makeCacheDemo(){
 let version=1,applicationCache=null,renderCount=0;const events=[];
 const policies={'/fresh':'public, max-age=600','/validate':'no-cache','/private':'private, max-age=600','/sensitive':'no-store','/rendered':'no-store'};
 const server=createServer((req,res)=>{
  const path=req.url;
  if(path==='/'){res.writeHead(200,{'Content-Type':'text/html; charset=utf-8','Cache-Control':'no-store'});return res.end('<!doctype html><html lang="de"><meta charset="utf-8"><title>Cache-Lehrversuch</title><h1>Cache-Lehrversuch</h1><p>Kontrollierte eigene Antworten ohne persönliche Daten.</p></html>');}
  if(!Object.hasOwn(policies,path)){res.writeHead(404,{'Cache-Control':'no-store'});return res.end();}
  if(!['GET','HEAD'].includes(req.method)){res.writeHead(405,{'Allow':'GET, HEAD','Cache-Control':'no-store'});return res.end();}
  let body;
  if(path==='/rendered'){
   if(applicationCache===null){renderCount++;applicationCache=JSON.stringify({fassung:version,text:'Eigener künstlicher Praxistext'});}
   body=applicationCache;
  }else body=JSON.stringify({fassung:version,text:'Eigener künstlicher Praxistext'});
  const etag='"'+createHash('sha256').update(body).digest('hex')+'"';
  const headers={'Cache-Control':policies[path],'Content-Type':'application/json; charset=utf-8','ETag':etag};
  const condition=req.headers['if-none-match'];
  const tags=(condition??'').match(/(?:W\/)?"[^\"]*"/g)??[];
  const notModified=condition==='*'||tags.some(tag=>tag.replace(/^W\//,'')===etag);
  // This teaching server supports If-None-Match on GET/HEAD, not all HTTP preconditions.
  if(notModified){events.push({path,status:304,condition,version,body_bytes:0});res.writeHead(304,headers);return res.end();}
  events.push({path,status:200,condition:condition??null,version,body_bytes:req.method==='HEAD'?0:Buffer.byteLength(body)});
  res.writeHead(200,{...headers,'Content-Length':Buffer.byteLength(body)});res.end(req.method==='HEAD'?'':body);
 });
 return {server,events,getRenderCount:()=>renderCount,publish:()=>{version++;applicationCache=null;}};
}
if(process.argv[1]&&import.meta.url===pathToFileURL(process.argv[1]).href){const{server}=makeCacheDemo();server.listen(8788,'127.0.0.1',()=>console.log('http://127.0.0.1:8788'));}
Die tatsächlichen Ergebnisse und ihre Grenzen lesen
Der ausgeführte Versuch umfasst 16 Fetch-Aufrufe im Browser und 44 geprüfte Bedingungen. Das Ursprungsprotokoll enthält insgesamt 14 Anfragen an die Lehrressourcen, einschließlich zweier gesonderter direkter HTTP-Gegenproben. Die Ausgangsseite ist in dieser Zahl nicht enthalten. Der Browser war Edge 157.0.4341.42, die Laufzeit Node.js 24.22.1. Ein frischer isolierter Kontext sorgte dafür, dass keine Antwort aus einem früheren Versuch bereits als Ausgangspunkt vorhanden war.
Die Aufrufe fanden ohne Service Worker und ohne CDN statt. Wir haben keine Übertragungsdauer, keine Bandbreite und keinen PageSpeed-Wert gemessen. Auch der Ablauf der 600 Sekunden wurde nicht abgewartet. Die Aussage lautet deshalb genau: Bei den ausgeführten unmittelbar aufeinanderfolgenden Abrufen wurde die dokumentierte Wiederverwendung beobachtet. Andere Browser, abweichende Anforderungsheader und ein zusätzlicher Auslieferungsdienst müssen für den konkreten Einsatz gesondert geprüft werden.
Varianten vor einem gemeinsamen Schlüssel schützen
Wenn eine Antwort von zusätzlichen Anforderungsheadern abhängt, muss ihre Wiederverwendung diese Unterschiede berücksichtigen. Vary beschreibt die dafür relevanten Header. Bei einer sprachabhängigen Antwort kann eine unpassende Zuordnung sonst die falsche Sprachfassung wiederverwenden. Unser Lehrserver liefert keine sprachabhängig ausgehandelten Darstellungen. Wir führen daher auch keinen solchen Test als bestanden auf. Die Frage wird erst dann praktisch, wenn der reale Vertrag diese Varianten besitzt.
Für einen eigenen Anwendungsspeicher ist dieselbe Überlegung als fachlicher Schlüssel zu lösen. Ein bloßes Wort wie „Startseite“ reicht möglicherweise nicht, wenn Mandant, Sprache und Veröffentlichungsstand unterschiedliche Ergebnisse erzeugen. Der Schlüssel muss genau die tatsächlich wirksamen Unterschiede abbilden. Dabei soll er keine unnötigen personenbezogenen Angaben ansammeln. Vor der Optimierung hilft eine Liste konkreter Gegenbeispiele: Welche zwei Abrufe dürfen dieselbe Kopie verwenden und bei welchen wäre das eine falsche Zuordnung?
Unveränderte Dateien und veränderliche Dokumente unterschiedlich behandeln
Die Einführung zum HTTP-Cache auf web.dev erläutert die Wiederverwendung über Browser und Antwortheader. Für die eigene Planung ist besonders die Trennung fester Dateien von veränderlichen Dokumenten hilfreich. Eine versionierte Bilddatei kann unter ihrer unveränderten Adresse lange verwendbar bleiben. Ein Dokument, das auf eine neue Bildfassung verweist, braucht dagegen eine Regel, durch die dieser Verweis rechtzeitig sichtbar wird. Ein neuer Dateiname allein aktualisiert noch keinen bereits vorhandenen alten Dokumentinhalt.
Beim Rückweg nach einer fehlerhaften Veröffentlichung müssen außerdem die bereits ausgelieferten neuen Fassungen berücksichtigt werden. Es reicht nicht immer, nur eine Ursprungsdatei wieder zurückzukopieren. Für unseren künstlichen Praxistext würden wir beschreiben, welche Fassung der Browser nach dem Rückweg sehen soll und wie die dafür nötige Prüfung ausgelöst wird. Dieser Gedankengang ist ein Planungsbeispiel. Der vorliegende Prüfbericht führt keinen echten Produktionsrückweg und keine externe Cachebereinigung als ausgeführt auf.
Eine passende Abnahme statt eines pauschalen Geschwindigkeitsversprechens
Eine Abnahme sollte mindestens einen ersten Abruf, eine Wiederholung und einen geänderten Inhalt enthalten. Ergänzen Sie die tatsächlich relevanten Benutzer- und Sprachvarianten. Bei einer zweiten Speicherebene wird außerdem geprüft, ob deren Leeren oder Wechsel wirklich den vorgesehenen Inhalt verändert. Wichtig ist ein unabhängiger Nachweis am Ursprung oder an der Erzeugungsstelle. Nur so lässt sich ein unerwarteter alter Text einer konkreten Ebene zuordnen, statt alle Zwischenspeicher ohne Diagnose gleichzeitig zu löschen.
- Für jede Ressource Inhalt, Änderungsbedarf und erlaubte Wiederverwendungsdauer festlegen.
- Browser-, gemeinsame HTTP- und eigene Anwendungsspeicher getrennt benennen.
- no-cache, no-store und private entsprechend ihrer Bedeutung auswählen.
- Versionskennungen an die tatsächlich ausgelieferte Darstellung binden.
- Ersten Abruf, Wiederholung und Veröffentlichung mit kontrollierten Daten prüfen.
- Ursprungsantwort und vom Browser zusammengesetztes Ergebnis unterscheiden.
- Sprach-, Mandanten- und Berechtigungsunterschiede in geeigneten Schlüsseln berücksichtigen.
- Rückweg und noch vorhandene ältere Fassungen in den Veröffentlichungsplan aufnehmen.
Das Ergebnis guter Cacheplanung ist ein nachvollziehbarer Aktualitätsvertrag. Eine wiederverwendete Antwort soll aus einem bewusst erlaubten Grund erscheinen. Eine notwendige Änderung soll über einen bekannten Weg sichtbar werden. Unser Versuch macht diese beiden Eigenschaften mit kleinen überprüfbaren Beispielen sichtbar, ohne aus der Zahl entfallener Ursprungsaufrufe eine allgemeine Ladezeit- oder Sicherheitsgarantie abzuleiten.
Eine alte Ansicht nicht vorschnell dem HTTP-Cache zuschreiben
Wenn nach einer Änderung noch alter Inhalt sichtbar ist, prüfen wir zuerst den tatsächlich ausgeführten Weg. Ein normaler Fetch-Abruf, das Zurückgehen in der Browserhistorie und eine bereits geöffnete Anwendung müssen nicht dieselbe Arbeit auslösen. Eine Oberfläche kann außerdem ihren alten Text selbst im Speicher behalten, ohne erneut eine HTTP-Anfrage auszuführen. Eine passende Diagnose beginnt deshalb mit dem Aufrufprotokoll und der Frage, ob überhaupt ein neuer Abruf stattgefunden hat.
Unser Bericht untersucht ausschließlich die ausdrücklich ausgeführten Fetch-Aufrufe. Er enthält keinen allgemeinen Nachweis über den Zurückknopf, die Wiederherstellung einer ganzen Seite oder das Verhalten einer installierten Webanwendung. Diese Grenze hilft bei der Übertragung des Beispiels: Die zuvor beobachtete Regel soll am eigenen tatsächlichen Ablauf geprüft werden. Eine zusätzliche Fehlerquelle verschwindet nicht dadurch, dass man ihr denselben Namen „Cache“ gibt.