HTML-Metadaten, Sprachangaben und Dokumentstruktur
Dokumenttitel, sichtbare Überschrift und Auslieferung als getrennte Aufgaben verstehen und mit ausgeführten Beispielen überprüfen.
Ein HTML-Dokument besteht aus mehr als dem sichtbaren Seiteninhalt. Sein Titel hilft bei der Orientierung zwischen geöffneten Seiten, seine Sprache beschreibt den Text für verarbeitende Programme und seine Zeichenkodierung bestimmt, wie übertragene Bytes überhaupt zu Buchstaben werden. Diese Angaben erfüllen unterschiedliche Aufgaben. Eine richtige Sprachangabe repariert keine beschädigten Umlaute und eine ansprechende Hauptüberschrift ersetzt keinen passenden Dokumenttitel.
Dieser Leitfaden entwickelt eine vollständige kleine Kursseite auf Deutsch und Englisch. Der Kurs ist ein konstruiertes Lehrbeispiel und kein tatsächlich buchbares Angebot. Beide Dokumente wurden im Browser und über einen eigenen HTTP-Empfänger geprüft. Insgesamt bestanden 104 Bedingungen mit sieben echten Dokumentabrufen. Dazu gehört ein absichtlich widersprüchlicher Zeichensatz im HTTP-Header. Die Ergebnisse zeigen konkrete Dokumenteigenschaften, keine Suchmaschinenaufnahme und keine abgeschlossene Prüfung mit Sprachausgabe.
Die äußere Struktur bewusst festlegen
Das Beispiel beginnt mit einer HTML-Doctype-Deklaration. Der Browser verarbeitet die geprüften Dokumente im Standardsmodus. Darauf folgt das Wurzelelement mit der hauptsächlichen Sprache. Sein Kopf enthält Dokumentinformationen und das eingebettete CSS. Im Inhalt steht ein Hauptbereich mit einer Hauptüberschrift, erklärenden Absätzen und einem benannten Abschnitt. Diese Reihenfolge macht nachvollziehbar, welche Information das ganze Dokument beschreibt und welche Information als Inhalt gelesen werden soll.
Der Kopf ist kein zweiter sichtbarer Einleitungsbereich. Umgekehrt gehören normale Absätze nicht zwischen Metadaten, nur weil eine Vorlage dort noch Platz bietet. Bei fehlerhaften Quellen können Browser Elemente verschieben oder fehlende Bestandteile ergänzen. Eine Seite kann dadurch scheinbar funktionieren, obwohl ihre ursprüngliche Struktur nicht der beabsichtigten Struktur entspricht. Deshalb betrachten wir sowohl den ausgelieferten Quelltext als auch das daraus entstandene Dokumentmodell.
Die WHATWG-Beschreibung des Dokumentkopfs ist die fachliche Grundlage. Für unser normales eigenständiges Dokument ist genau ein Titelelement vorgesehen. Besondere Kontexte wie ein eingebettetes srcdoc-Dokument haben eigene Regeln. Aus dem vorliegenden Beispiel wird deshalb keine pauschale Aussage für jeden möglichen HTML-Kontext abgeleitet.
Titel und Hauptüberschrift erfüllen verschiedene Aufgaben
Der Dokumenttitel unseres deutschen Beispiels lautet Werkstattkurs: Ablauf und Voraussetzungen. Die sichtbare Hauptüberschrift lautet Kleine Reparaturen verstehen. Beide beschreiben dasselbe konstruierte Thema, setzen aber unterschiedliche Schwerpunkte. Der Titel benennt den Kontext für eine Seitenübersicht oder einen Browser-Tab. Die Überschrift eröffnet den eigentlichen Inhalt. Sie müssen nicht buchstabengetreu gleich sein, sollten sich aber fachlich nicht widersprechen.
Bei einer größeren Webseite braucht jede relevante Seite einen aussagekräftigen Titel. Ein überall wiederholtes Wort wie „Startseite“ hilft beim Wechsel zwischen mehreren Dokumenten kaum. Gleichzeitig sollte der Titel keine Leistung versprechen, die der sichtbare Text nicht beschreibt. Unser Beispiel nennt deshalb Ablauf und Voraussetzungen, ohne einen Preis, einen freien Termin oder eine angebliche Anmeldung hinzuzuerfinden.
In der tatsächlichen Prüfung werden Anzahl und Text der Titelelemente unabhängig von Anzahl und Text der Hauptüberschriften kontrolliert. Ein absichtlich hinzugefügtes zweites Titelelement wird als Abweichung erkannt. Diese eigene Regel ist eine konkrete Abnahmebedingung unseres Beispiels. Sie ist kein allgemeiner HTML-Validator und kein Nachweis dafür, welche Überschrift eine Suchmaschine später anzeigen würde.
Die Beschreibung gehört zum konkreten Inhalt
Die Meta-Beschreibung fasst die Art des konstruierten Kursbeispiels zusammen. Sie steht als eigenes benanntes Metadatum im Kopf. Der sichtbare Einleitungstext erklärt dagegen unmittelbar den Zweck der Seite. Beide Angaben werden getrennt gepflegt, weil sie an verschiedenen Stellen verwendet werden können. Ein Besucher soll im Inhalt nicht zuerst eine technische Metadatenliste entschlüsseln müssen.
Eine Beschreibung sollte nicht als Ablage für beliebige Stichwörter missverstanden werden. Sie ist weder ein Ersatz für lesbaren Inhalt noch eine versteckte Erweiterung des Angebots. Wenn eine Kursseite nur Voraussetzungen erklärt, sollte die Beschreibung nicht behaupten, dass eine Buchung bestätigt werden könne. Bei einer Übersetzung gehört auch die Beschreibung in die passende Sprache. Ein englischer Inhalt mit einer versehentlich übernommenen deutschen Beschreibung wäre eine echte redaktionelle Abweichung.
Die MDN-Dokumentation zu meta erläutert die unterschiedlichen Metadatenattribute. Unser Test sucht ausdrücklich die vereinbarte Beschreibung im Kopf und vergleicht ihren Inhalt. Wird ihr Name absichtlich verändert, schlägt diese Prüfung an. Eine Erfolgsaussage über Suchergebnisdarstellungen wird damit nicht verbunden.
Die Hauptsprache am Dokument angeben
Die deutsche Fassung verwendet lang="de" am Wurzelelement und die englische Fassung entsprechend lang="en". Diese Angabe beschreibt die hauptsächliche menschliche Sprache. Sie legt weder ein Land noch eine Währung noch die Zeichenkodierung fest. Ein deutsches Dokument kann internationale Inhalte enthalten und bleibt dennoch als deutschsprachiges Dokument beschrieben.
Die HTML-Regeln zu lang beschreiben gültige Sprachkennzeichnungen und deren Vererbung. In unserem kleinen Vertrag erwarten wir die zwei ausdrücklich festgelegten Werte. Das ist keine Implementierung eines vollständigen Prüfers aller möglichen BCP-47-Sprachkennzeichnungen. Eine regionale Variante sollte nur gewählt werden, wenn die tatsächliche sprachliche Unterscheidung dafür relevant ist.
Die WAI-Erklärung zur Sprache einer Seite beschreibt den Nutzen einer programmatisch bestimmbaren Hauptsprache. Dazu gehört die passende Verarbeitung durch assistierende Technik. Wir prüfen hier die tatsächlichen Dokumentattribute und die Sprachzuordnung im Browser. Eine bestimmte Aussprache oder das Verhalten einer konkreten Screenreader-Stimme wurde für dieses Beispiel nicht gehört und wird deshalb nicht als bestanden ausgegeben.
Abweichende Sprachabschnitte gezielt auszeichnen
Die deutsche Seite enthält einen kurzen englischen Lehrsatz. Nur dessen Textspanne erhält die abweichende Sprachangabe. Die umgebende Erklärung bleibt deutsch. Die englische Seite verwendet umgekehrt eine deutsche Lehrphrase mit einer eigenen Kennzeichnung. Dadurch bleibt die hauptsächliche Sprache klar und der Wechsel wird dort beschrieben, wo er tatsächlich stattfindet.
Im Browser wurde geprüft, dass die Hauptüberschrift zur erwarteten geerbten Sprache passt und die ausdrücklich markierte Textspanne zur abweichenden Sprache. Dafür wurde der Sprachselektor :lang() verwendet. Ein absichtlich falscher Wert am Sprachabschnitt wird in der Gegenprobe erkannt. Diese Prüfung beobachtet die programmgesteuerte Zuordnung und nicht das menschliche Erkennen einer Sprache aus dem Inhalt.
Nicht jeder Produktname und jedes technische Kürzel verlangt einen künstlichen Sprachwechsel. Entscheidend ist die tatsächliche sprachliche Funktion der Passage. Eine vollständige fremdsprachige Formulierung ist anders zu behandeln als ein einzelner verbreiteter Fachbegriff. Ebenso sollte eine unbekannte Sprache nicht durch eine frei erfundene Kennzeichnung scheinbar präzise gemacht werden. Für mehrsprachige Redaktionen gehört diese Entscheidung in eine nachvollziehbare Stilregel.
Zeichenkodierung und Sprache auseinanderhalten
Die Zeichencodierung beantwortet eine andere Frage als die Sprache: Wie werden die gespeicherten oder übertragenen Bytes in Zeichen umgewandelt? Unser Quelltext ist tatsächlich als UTF-8 gespeichert und enthält die entsprechende frühe Meta-Deklaration. Die deklarierende Stelle liegt vollständig innerhalb der ersten 1024 Bytes. Im Test wird dafür die Bytezahl bis zum Ende dieses Elements gemessen und nicht einfach eine Anzahl von JavaScript-Zeichen gezählt.
Gerade nichtlateinische Texte und Umlaute machen diese Unterscheidung sichtbar. Ein Zeichen kann in UTF-8 mehrere Bytes benötigen. Eine Prüfung, die nur Zeichenpositionen zählt, würde deshalb eine andere Eigenschaft prüfen als die Anforderung an die serialisierte Datei. In unserem kleinen Dokument ist die Deklaration ohnehin sehr früh angeordnet, sodass kein großer Kommentar oder eingefügter Vorlagenblock davorliegt.
Eine Deklaration konvertiert die Datei nicht nachträglich in UTF-8. Werden andere Bytes gespeichert, bleiben sie andere Bytes. Ebenso kann die Auslieferung zusätzliche Angaben enthalten. Für eine belastbare Diagnose müssen deshalb Quelldatei, HTTP-Antwort und die vom Browser tatsächlich verwendete Kodierung gemeinsam betrachtet werden. Das sichtbare Attribut allein ist dafür zu wenig.
Ein widersprüchlicher HTTP-Header ist tatsächlich sichtbar
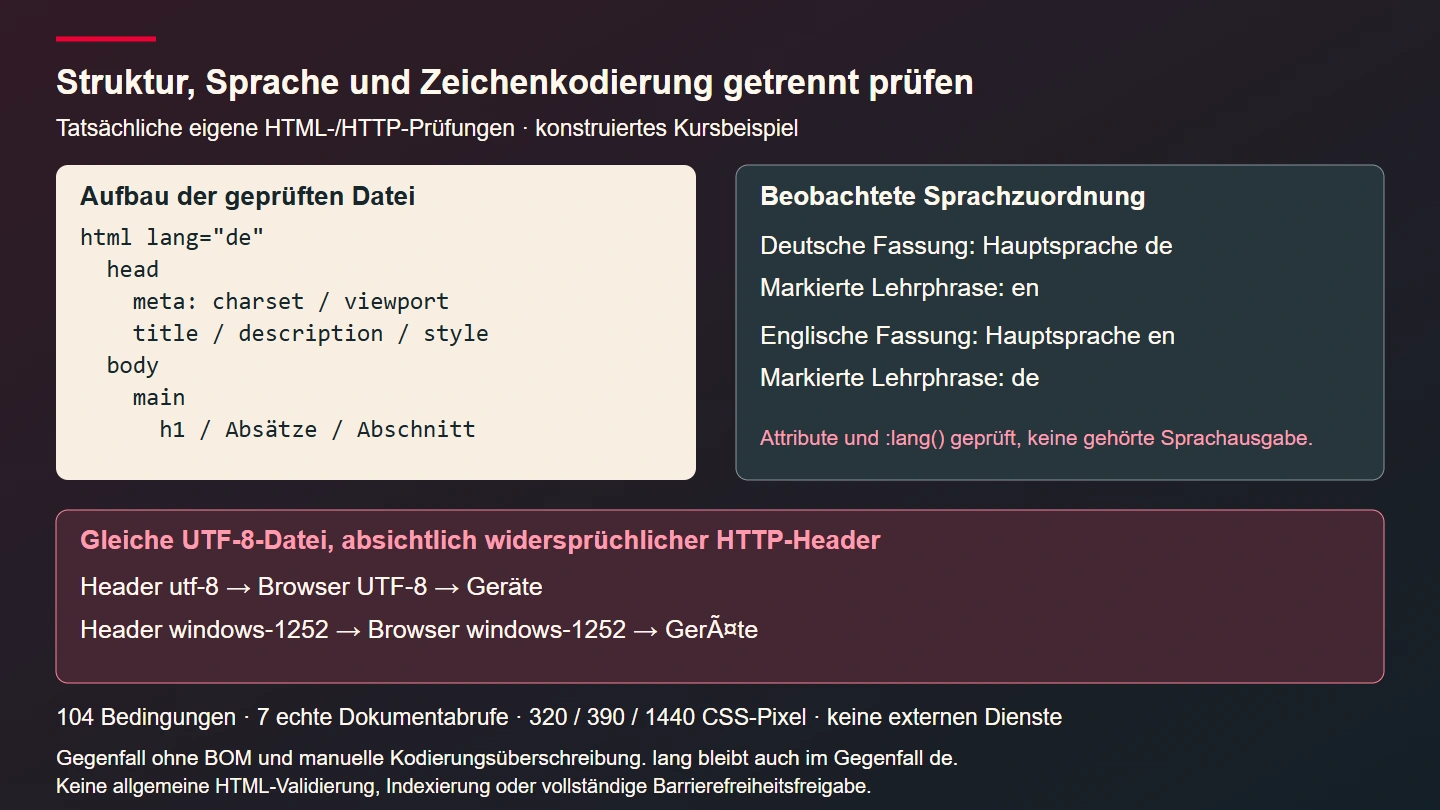
Die korrekten Testantworten liefern die UTF-8-Dateien mit passender Angabe im HTTP-Header aus. Anschließend wird die deutsche Datei unverändert unter einer Gegenprobe ausgeliefert, deren Header absichtlich windows-1252 nennt. Das Beispiel enthält keinen vorgeschalteten BOM. Der Browser verwendet in diesem Fall tatsächlich die abweichende Headerangabe. Das erwartete Wort mit Umlaut wird beschädigt dargestellt, obwohl die Meta-Deklaration weiterhin UTF-8 nennt.
Die WHATWG-Regeln zur Bestimmung der Zeichenkodierung beschreiben die beteiligten Hinweise und ihre Reihenfolge. Unser Gegenfall erklärt einen konkreten Konflikt ohne BOM und ohne manuelle Browserüberschreibung. Er wird nicht zu der ungenauen Behauptung verkürzt, dass ein Header unter allen denkbaren Bedingungen immer Vorrang habe.
Die Sprachangabe des beschädigt gelesenen Dokuments bleibt trotzdem deutsch. Genau daran wird die Trennung der Aufgaben deutlich. Wer bei beschädigten Umlauten nur lang ändert, bearbeitet die falsche Ebene. Die richtige Korrektur betrifft die tatsächlichen Bytes und die dazu passende Auslieferung. Danach muss dieselbe Antwort erneut über den wirklichen Übertragungsweg geprüft werden.
Der vollständige Dokumentcode
Die folgende Datei ist die tatsächlich geprüfte Sprachfassung. Das CSS ist eingebettet, damit das Beispiel ohne externe Schriftdateien, Skripte oder weitere Gestaltungsdateien auskommt. Für eine größere Anwendung kann eine gemeinsame Stylesheetdatei sinnvoll sein. Diese organisatorische Entscheidung verändert jedoch nicht die Aufgabe der Dokumentmetadaten. Der Beispielcode enthält keine Suche, Anmeldung oder Buchungsfunktion und erzeugt keine erfundene Erfolgsbestätigung.
example-de.html
<!doctype html>
<html lang="de">
<head>
  <meta charset="utf-8">
  <meta name="viewport" content="width=device-width, initial-scale=1">
  <title>Werkstattkurs: Ablauf und Voraussetzungen</title>
  <meta name="description" content="Ein fiktiver Werkstattkurs erklärt Ablauf, Voraussetzungen und den Unterschied zwischen einer allgemeinen Beschreibung und einem verbindlichen Angebot.">
  <style>
    :root { color-scheme: light; font: 100%/1.6 Arial, sans-serif; }
    * { box-sizing: border-box; }
    body { margin: 0; color: #192329; background: #fffaf3; }
    main { width: min(100%, 48rem); margin: auto; padding: 1.5rem; }
    h1 { line-height: 1.2; overflow-wrap: anywhere; }
    section { margin-top: 2rem; border-top: .25rem solid #b80024; }
    a { color: #a60021; text-underline-offset: .2em; }
    a:focus-visible { outline: .2rem solid #192329; outline-offset: .3rem; }
    blockquote { margin: 1.5rem 0; padding: 1rem; background: #eee4d8; }
  </style>
</head>
<body>
  <main id="inhalt">
    <h1>Kleine Reparaturen verstehen</h1>
    <p>Dieses konstruierte Kursbeispiel zeigt die Struktur eines vollständigen HTML-Dokuments.</p>
    <p><a href="#voraussetzungen">Voraussetzungen lesen</a></p>
    <section aria-labelledby="voraussetzungen">
      <h2 id="voraussetzungen" tabindex="-1">Was Sie vor dem Termin wissen sollten</h2>
      <p>Bringen Sie keine eigenen Geräte mit. Das Beispiel beschreibt keine tatsächlich buchbare Veranstaltung.</p>
      <p>Englischer Merksatz:</p>
      <blockquote><span lang="en">Tools, not toys</span></blockquote>
    </section>
  </main>
</body>
</html>
Die andere Sprachfassung besitzt dieselbe Struktur und passende übersetzte Inhalte. Die Prüfungen vergleichen nicht nur eine angenommene Schablone, sondern die tatsächlich ausgeführten Dateien. Ein einzelnes erfolgreiches deutsches Beispiel wäre kein ausreichender Beleg für eine danebenliegende englische Fassung mit möglicherweise veralteten Metadaten. Sprache, Titel, Beschreibung und sichtbare Inhalte werden deshalb pro Dokument kontrolliert.
Den Viewport ohne künstliche Lesesperren festlegen
Das Beispiel verwendet eine Viewportangabe mit Gerätebreite und anfänglichem Maßstab eins. Es enthält weder eine Sperre für die Skalierung noch eine künstlich niedrige Höchstvergrößerung. Der Inhalt ist so gestaltet, dass er bei den geprüften Breiten ohne horizontalen Seitenüberlauf dargestellt wird. Lange Überschriften dürfen umbrechen und der Hauptbereich bleibt höchstens so breit wie seine verfügbare Fläche.
Die MDN-Erklärung zur Viewportangabe beschreibt ihren Einfluss auf den Darstellungsbereich. Sie ist kein Ersatz für flexibles CSS. Ein fest auf tausend Pixel Breite gesetzter Inhalt würde durch ein korrektes Meta-Tag nicht automatisch sinnvoll auf ein schmales Gerät passen. Umgekehrt sollte ein Layoutfehler nicht durch das Verhindern von Vergrößerung versteckt werden.
Die tatsächlichen Prüfungen verwenden 320, 390 und 1440 CSS-Pixel. In den schmalen Kontexten wird mobile Darstellung emuliert. Die beobachtete innere Breite entspricht jeweils der gewählten Breite. Diese Emulation ist kein physischer Gerätetest und kein Nachweis für jede Zoomstufe. Der Befund betrifft die genannten Kontexte und die unveränderten Beispielinhalte.
Dokumentmodell und Quelldatei gemeinsam prüfen
Ein Browser baut aus HTML ein Dokumentmodell auf. Die Entwicklerwerkzeuge zeigen häufig dieses Modell und nicht einfach die ursprünglichen Bytes. Deshalb werden die frühe Kodierungsdeklaration und die vollständigen Dateien zusätzlich als Quelle geprüft. Der Browserteil kontrolliert dagegen die entstandenen Elemente, den Dokumenttitel, die tatsächlich verwendete Kodierung und die sichtbare Hauptstruktur.
Die Tests verändern einzelne Kopien gezielt: Ein zweiter Titel wird eingefügt, die Hauptsprache entfernt, die Beschreibung umbenannt, der Hauptbereich ersetzt oder die Teilsprachangabe verfälscht. Jede Abweichung muss von ihrer zugehörigen Regel erkannt werden. Dass eine Seite nach einer Veränderung weiterhin lesbar erscheint, reicht nicht, um die vereinbarte Dokumentstruktur als korrekt zu beurteilen.
| Geprüfte Eigenschaft | Tatsächlicher Nachweis | Keine daraus abgeleitete Aussage |
|---|---|---|
| Hauptsprache | Wurzelwert und Sprachselektor passen | Keine gehörte Sprachausgabe |
| Dokumenttitel | Ein erwartetes Titelelement im Kopf | Keine garantierte Suchergebniszeile |
| Zeichenkodierung | UTF-8-Antwort und absichtlicher Headerkonflikt geprüft | Keine Prüfung sämtlicher Auslieferungswege |
| Darstellung | Drei Breiten ohne Seitenüberlauf | Keine vollständige Barrierefreiheitsfreigabe |
Ein echter Sprunglink gehört zur Dokumentabnahme
Der Beispielinhalt enthält einen beschreibenden Link zu den Voraussetzungen. In den Browserprüfungen wird mit der Tabulatortaste tatsächlich zum Link gewechselt und anschließend mit Enter aktiviert. Der Fokus liegt danach auf der Zielüberschrift. Der Fragmentname löst eindeutig auf und die Überschrift ist dem Abschnitt zugeordnet. Damit wird ein konkreter Bedienweg ausgeführt statt nur die Existenz einer passenden Zeichenfolge im Quelltext zu vermuten.
Das negative Tabulatorziel an der Überschrift fügt diese nicht als zusätzliche reguläre Station in die Tabulatorfolge ein. Es ermöglicht aber ihre Fokussierung als Sprungziel im ausgeführten Beispiel. Für eine vollständige Seite müssten weitere Links, Navigationen und Formulare ebenfalls geprüft werden. Aus diesem einzelnen erfolgreichen Fragmentweg folgt keine allgemeine Tastaturfreigabe aller künftigen Komponenten.
Vorlagen dürfen keine widersprüchlichen Kopfangaben sammeln
In größeren Projekten kommen Kopfangaben häufig aus mehreren Quellen: Grundvorlage, Seitenmodul, Übersetzungsdaten und Erweiterungen. Eine klare Zuständigkeit verhindert doppelte Titel oder widersprüchliche Beschreibungen. Die Grundvorlage kann die Struktur bereitstellen und geprüfte Seitendaten genau einmal einsetzen. Ob ein Modul diese Daten ändern darf, sollte ausdrücklich geregelt sein. Ein später angefügtes zweites Element ist keine saubere Überschreibung.
Für dynamische Werte bleibt die passende HTML-Ausgabekodierung notwendig. Eine redaktionelle Überschrift mit Anführungszeichen darf nicht aus einem Attribut ausbrechen können. Unser unveränderter statischer Code demonstriert keine allgemeine sichere Vorlagenfunktion. Wer daraus eine Datenbankvorlage macht, muss Text- und Attributkontext getrennt berücksichtigen und die erzeugte Antwort mit repräsentativen Sonderzeichen erneut prüfen.
Die Abnahme als konkrete Liste führen
- Tatsächliche Hauptsprache und abweichende Textpassagen pro Fassung bestimmen.
- Einen passenden Dokumenttitel und eine eigenständige Hauptüberschrift prüfen.
- Beschreibung mit den sichtbaren Inhalten abgleichen.
- UTF-8-Datei, frühe Deklaration und HTTP-Angabe gemeinsam kontrollieren.
- Mehrere Breiten und einen echten Tastaturweg ausführen.
- Negative Kopien verwenden, damit eine Prüfung nicht nur zufällig grün bleibt.
- Beobachtete Dokumenteigenschaften von noch ungeprüften Such- oder Sprachdiensten trennen.
Für die vorliegenden Dateien umfasst diese Abnahme 104 tatsächlich ausgeführte Bedingungen. Sechs korrekte HTTP-Dokumentabrufe decken beide Sprachen in den drei Breiten ab. Ein weiterer Abruf zeigt den absichtlichen Kodierungskonflikt. Die zusätzlichen Prüfungen verwenden unveränderte Dokumente und gezielt veränderte Gegenkopien im Browser. Kein externer Dienst wurde für eine Veröffentlichung, Suchaufnahme oder Sprachwiedergabe angesprochen.
Eine überprüfbare Grundlage weiterverwenden
Dokumentkopf und sichtbarer Kopfbereich sind verschiedene Elemente
Die ähnlich klingenden Bezeichnungen können bei der Vorlagenarbeit leicht verwirren. Ein sichtbarer Kopfbereich mit Logo oder Navigation kann ein header-Element im Inhalt sein. Der hier erläuterte Dokumentkopf ist dagegen das head-Element. Ein Seitentitel gehört deshalb nicht als sichtbare Überschrift in den Dokumentkopf und eine Navigation gehört nicht zwischen dessen Metadaten. Unser kleines Lehrdokument enthält bewusst keinen zusätzlichen sichtbaren Kopfbereich, damit diese Aufgabe nicht mit einer Navigationsgestaltung vermischt wird.
Auch der Hauptbereich ist nicht automatisch jeder große Container einer Gestaltung. Im Beispiel beschreibt er den zentralen Kursinhalt. Ein Wechsel seiner Hintergrundfarbe ändert diese Bedeutung nicht. Eine umfassende Vorlage sollte ihre Bereiche zuerst nach dem tatsächlichen Inhalt und dessen Aufgabe benennen. Erst danach wird entschieden, welche dieser Bereiche eine besondere Darstellung benötigen. So bleiben semantische Struktur und visuelle Gestaltung miteinander vereinbar.
Sprachangaben führen keine Übersetzung aus
Wird das deutsche Wurzelattribut durch einen englischen Wert ersetzt, bleiben die deutschen Sätze weiterhin dieselben Sätze. Der Browser erhält dann eine falsche Beschreibung des vorhandenen Inhalts. Die englische Beispieldatei wurde deshalb wirklich übersetzt: Titel, Beschreibung, Hauptüberschrift, Erklärung und Sprunglink besitzen passende englische Texte. Die kleine bewusst deutsche Lehrphrase bleibt als solche markiert. Eine korrekte Sprachangabe folgt der tatsächlichen Fassung und erzeugt diese Fassung nicht selbst.
Für eine reale mehrsprachige Redaktion gehört zudem die inhaltliche Gleichwertigkeit auf die Prüfliste. Ein übersetzter Link muss noch zum gleichen beschriebenen Abschnitt führen und die Voraussetzungen dürfen nicht versehentlich unterschiedlich werden. Diese fachliche Prüfung ist von der technischen Attributprüfung zu unterscheiden. Das Beispiel kontrolliert festgelegte Texte und eindeutige Ziele. Eine allgemeine Übersetzungsbewertung beliebiger künftiger Beiträge ist darin nicht enthalten.
Die nächste sinnvolle Erweiterung ist nicht eine möglichst lange Liste zusätzlicher Meta-Tags. Zuerst sollte die vorhandene Dokumentgrundlage zuverlässig stimmen. Danach können ein nachvollziehbarer Sprachwechsel zwischen echten Fassungen, weitere Seitenmodule oder gezielte strukturierte Daten ergänzt werden. Jede Erweiterung erhält eigene Erwartungen und darf die bereits geprüften Grundlagen nicht unbemerkt verändern.
Ein solcher Dokumentvertrag hilft auch bei einem Redesign. Sichtbare Gestaltung kann wechseln, während die Hauptsprache, der Kontext des Titels und der Bezug zum Inhalt erhalten bleiben müssen. Prüftests, die diese Aufgaben getrennt behandeln, machen Fehler genauer lokalisierbar. Eine beschädigte Zeichenfolge führt dann zur Auslieferungsdiagnose und eine falsche Übersetzung zur redaktionellen Korrektur. Beides wird nicht mit einem beliebigen zusätzlichen Meta-Tag überdeckt.