KI-Kosten, Geschwindigkeit und Ergebnisqualität abwägen
Aufgabenbezogen entscheiden, Cacheklassen richtig rechnen und Rechenbeispiele von tatsächlich gemessener Modellleistung trennen.
Ein günstiger Tokenpreis macht einen KI-Ablauf noch nicht wirtschaftlich. Wenn die Ausgabe mehrfach überarbeitet werden muss, ein Werkzeug unnötig aufgerufen wird oder die fachliche Prüfung länger dauert als die eigentliche Bearbeitung, verschiebt sich die Rechnung. Umgekehrt ist ein langsamerer Ablauf nicht automatisch hochwertiger. Entscheidend ist, ob eine konkrete Aufgabe in der benötigten Qualität und innerhalb ihrer zeitlichen und finanziellen Grenzen abgeschlossen wird.
Dieser Leitfaden beschreibt eine überprüfbare Auswahlmethode statt einer allgemeinen Modellrangliste. Er verbindet Qualitätsanforderungen, Zeitmessung und vollständige Aufgabenkosten. Ein eigener JavaScript-Rechner zeigt die getrennte Behandlung verschiedener Texttokenklassen. Seine 93 Prüfungen wurden tatsächlich ausgeführt. Die eingesetzten Tokenmengen sind jedoch ein ausdrücklich gewähltes Rechenbeispiel und kein Modellbenchmark. Der Quellen- und Preisstand ist der 9. November 2026. Vor einer realen Kalkulation sind Tarif, Kontextklasse und verwendete Dienste erneut zu prüfen.
Was als brauchbares Ergebnis zählt
Beginnen Sie mit dem Ergebnis, das jemand anschließend verwenden muss. Eine Zusammenfassung soll beispielsweise bestimmte Aussagen korrekt wiedergeben und nachvollziehbare Belege enthalten. Ein Textentwurf muss möglicherweise eine vorhandene Tonalität treffen. Ein erzeugtes Programm muss eine fachlich beschriebene Prüfung bestehen. Diese Aufgaben brauchen unterschiedliche Kriterien. „Die Antwort klingt gut“ reicht für keinen belastbaren Vergleich, wenn ein wichtiger Fehler erst beim nächsten Arbeitsschritt sichtbar wird.
Unterscheiden Sie zwingende Anforderungen und verhandelbare Eigenschaften. Eine erfundene Quellenangabe kann ein Ausschlussgrund sein. Eine etwas längere Formulierung kann dagegen eine redaktionelle Anpassung erlauben. Werden beide Eigenschaften in einem gemeinsamen Durchschnitt versteckt, kann ein gefährlicher Fehler durch gute Stilpunkte ausgeglichen werden. Definieren Sie deshalb zuerst die Ausschlussbedingungen. Bewerten Sie erst bei bestandenen Mindestanforderungen die verbleibenden Unterschiede wie Lesbarkeit, Umfang oder Aufwand für eine kleinere Korrektur.
| Aufgabe | Mögliche Mindestanforderung | Zusätzlich zu bewerten |
|---|---|---|
| Beleggestützte Zusammenfassung | Keine unbelegte fachliche Kernaussage | Verständlichkeit und Kürze |
| Formularcode | Beschriebene Eingaben und Gegenfälle funktionieren | Wartbarkeit und Einbauaufwand |
| Textentwurf | Keine erfundenen Produktversprechen | Ton und redaktionelle Nacharbeit |
| Kategorisierung | Zulässige Kategorien und definierter Umgang mit unklaren Fällen | Geschwindigkeit und Kosten je abgeschlossenem Fall |
Die offizielle OpenAI-Dokumentation zu Evaluationen beschreibt aufgabenspezifische Prüfungen und die Abstimmung automatischer Bewertungen mit menschlichen Urteilen. Der methodische Ansatz ist unabhängig davon, welches Prüfwerkzeug eingesetzt wird. Die dort dokumentierte ältere Evals-Plattform wird zum Quellenstand bereits nur noch lesend betrieben und soll am 30. November 2026 abgeschaltet werden. Planen Sie deshalb keine neue technische Umsetzung allein anhand alter Evals-API-Beispiele.
Eine kleine, aber aussagekräftige Aufgabenmenge aufbauen
Wählen Sie typische Aufgaben aus dem vorgesehenen Arbeitsablauf. Ergänzen Sie schwierige Fälle, die eine falsche Entscheidung besonders sichtbar machen. Für eine Zusammenfassung können das widersprüchliche Angaben oder fehlende Belege sein. Für eine Extraktion eignen sich uneinheitliche Schreibweisen und nicht vorhandene Felder. Dokumentieren Sie zu jedem Fall, was als richtig gilt und wer diese Erwartung fachlich geprüft hat. Ohne diese Grundlage wird nur die Übereinstimmung mit einer ungeprüften Musterantwort gemessen.
Halten Sie eine zusätzliche Aufgabenmenge zurück, die nicht für die laufende Anpassung von Prompts verwendet wird. Andernfalls kann ein Entwurf genau die bekannten Beispiele treffen, ohne neue Aufgaben zuverlässig zu lösen. Bewahren Sie außerdem Originaleingabe, bereitgestellten Kontext und Ergebnis gemeinsam auf. Ein Vergleich zweier Antworten ist wenig aussagekräftig, wenn die eine Antwort bessere Unterlagen erhielt. Das gilt ebenso für zusätzliche Werkzeuge, längere Bearbeitungszeiten und verschiedene Ausgabegrenzen.
Eine einheitliche Aufgabenmenge bedeutet nicht, alle Fälle gleich häufig auftreten zu lassen. Häufige Routineaufgaben und seltene kritische Fälle haben unterschiedliche Funktionen im Test. Zeigen Sie beide Gruppen getrennt. Eine hohe Gesamterfolgsquote kann sonst verbergen, dass gerade die seltenen schwierigen Fälle regelmäßig scheitern. Benennen Sie außerdem die Größe jeder Gruppe. Aus wenigen gelungenen Beispielen lässt sich keine präzise Aussage für einen gesamten Geschäftsprozess ableiten.
Geschwindigkeit am gesamten Ablauf messen
Für eine interaktive Anwendung zählt zunächst, wann eine Person eine nützliche Rückmeldung erhält. Für einen nächtlichen Stapelauftrag zählt eher, wann alle Ergebnisse geprüft bereitstehen. Diese Zeitpunkte sind verschieden. Erfassen Sie Beginn, erste tatsächlich nutzbare Ausgabe und vollständigen Abschluss getrennt. Eine früh ausgegebene Einleitung verkürzt nicht automatisch die Zeit bis zur verwertbaren Entscheidung. Ebenso macht eine angezeigte Fortschrittsmeldung einen blockierenden Werkzeugaufruf nicht schneller.
Die Dokumentation zur Latenzoptimierung nennt unter anderem weniger Ausgabetoken, weniger Anfragen und die Parallelisierung unabhängiger Schritte. Daraus folgt kein garantiertes Tempo für eine konkrete Anwendung. Zeichnen Sie den eigenen Ablauf auf und suchen Sie die tatsächlich langsame Stelle. Ein langsamer Datenabruf, eine Warteschlange und eine lange Modellausgabe verlangen unterschiedliche Änderungen. Nur eine davon betrifft unmittelbar die Wahl des Modells.
Wiederholen Sie Messungen unter vergleichbaren Bedingungen und bewahren Sie alle Versuche auf. Ein einzelner schneller Lauf ist keine verlässliche Antwortzeit. Berichten Sie Anzahl, Streuung und ungewöhnlich langsame Fälle. Wenn Sie ein Perzentil angeben, dokumentieren Sie Berechnung und Fallzahl. Bei sehr wenigen Versuchen vermittelt eine präzise wirkende Nachkommastelle mehr Sicherheit, als die Daten hergeben. Eine kleine Tabelle mit allen beobachteten Laufzeiten ist dann häufig ehrlicher und hilfreicher.
Parallelisierung hilft nur, wenn die Schritte fachlich unabhängig sind. Eine Antwortprüfung kann nicht sinnvoll das noch nicht vorliegende Ergebnis prüfen. Zwei voneinander unabhängige Recherchen können dagegen gleichzeitig laufen. Begrenzen Sie trotzdem Gleichzeitigkeit und Gesamtbudget. Mehr parallele Anfragen können eine Warteschlange lediglich an eine andere Stelle verschieben. Berücksichtigen Sie auch abgebrochene und später verworfene Ergebnisse, denn ihre Bearbeitung kann bereits Kosten verursacht haben.
Kosten pro abgeschlossenem Auftrag berechnen
Trennen Sie die Kosten eines einzelnen Modellaufrufs von den Kosten einer fertigen Aufgabe. Ein Auftrag kann mehrere Versuche, externe Werkzeuge, Datenabrufe und menschliche Nacharbeit benötigen. Notieren Sie diese Bestandteile getrennt. Ein günstiger Aufruf kann am Ende teuer werden, wenn er regelmäßig weitere Schleifen auslöst. Ein höherer Einzelpreis kann sinnvoll sein, wenn er unter vergleichbaren Bedingungen genügend Nacharbeit vermeidet. Ob das tatsächlich passiert, muss die eigene Beobachtung zeigen.
Die offizielle Anleitung zur Kostenoptimierung beschreibt unter anderem weniger Anfragen und eine zur Aufgabe passende Modellgröße. Nutzen Sie solche Möglichkeiten als überprüfbare Änderung. Kürzen Sie beispielsweise einen Kontext um nachweislich irrelevante Passagen und prüfen Sie anschließend dieselben Aufgaben erneut. Ein kürzerer Kontext, dem ein entscheidender Beleg fehlt, ist keine erfolgreiche Optimierung. Die Kostenersparnis muss gemeinsam mit der Ergebnisqualität bewertet werden.
Eine brauchbare Gesamtrechnung enthält außerdem den Nenner: Wie viele Aufgaben wurden akzeptabel abgeschlossen? Teilen Sie die Gesamtkosten eines Prüfblocks durch diese Zahl. Wenn keine Aufgabe akzeptiert wurde, gibt es keinen sinnvollen endlichen Durchschnitt je Erfolg. Verschweigen Sie fehlgeschlagene Versuche nicht durch einen Filter auf erfolgreiche Antworten. Für die Kapazitätsplanung sind zusätzlich die Kosten der noch offenen Aufgaben wichtig. Diese sind noch keine abgeschlossenen Erfolge.
Tarife und Tokenklassen sauber zuordnen
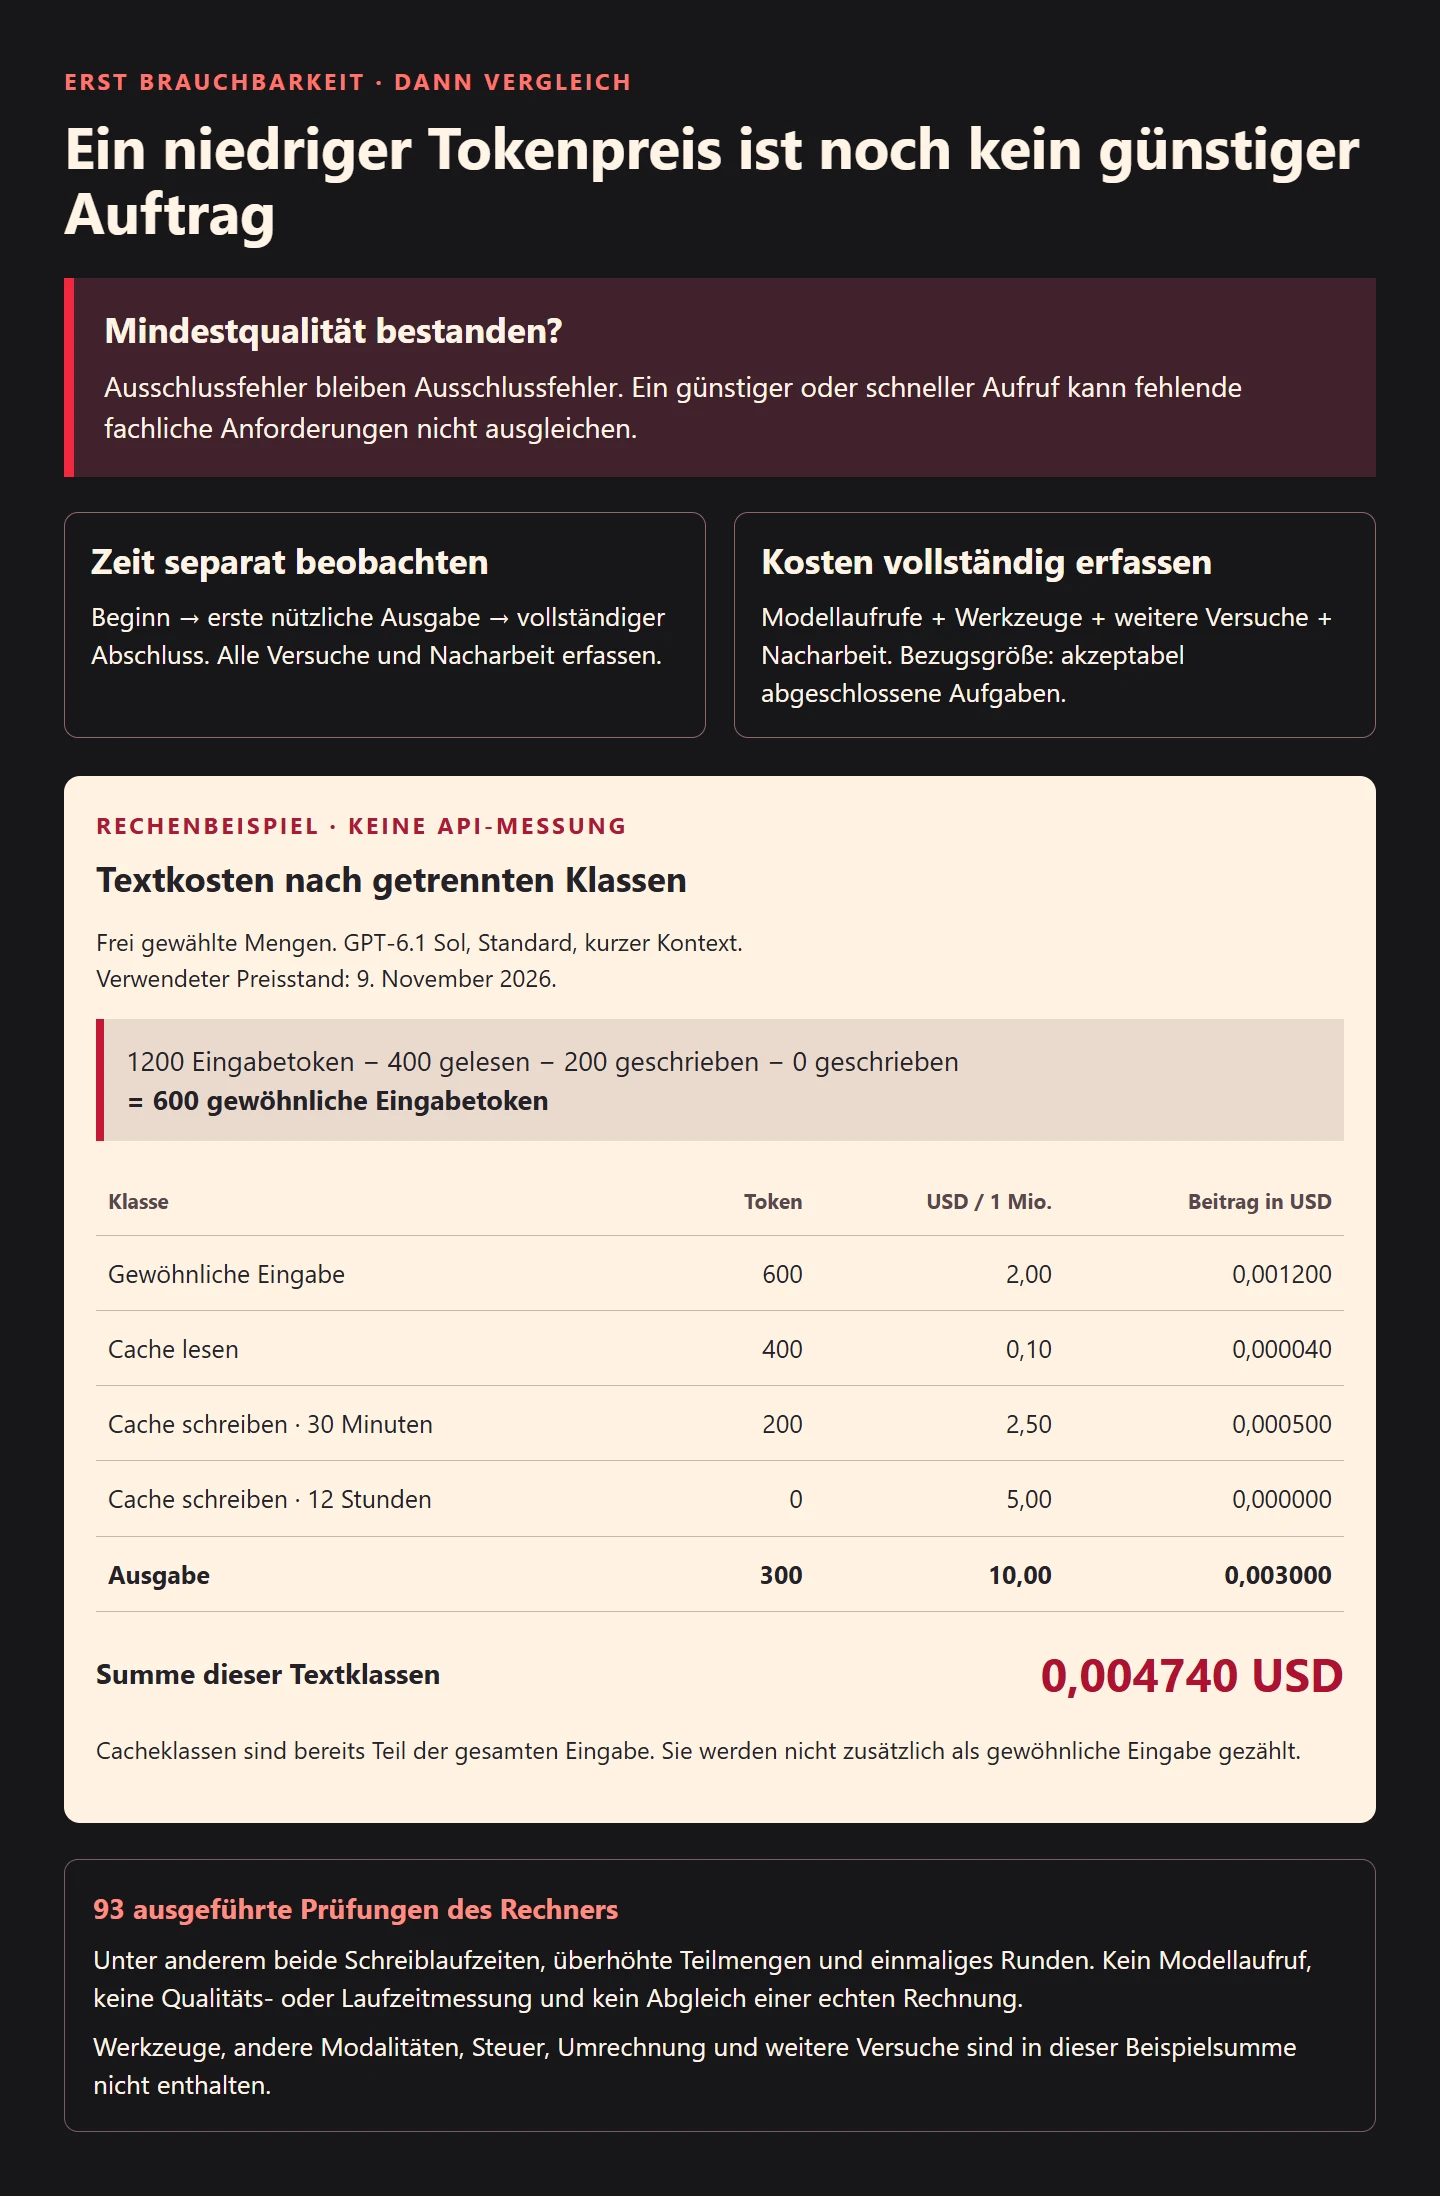
Die aktuelle API-Preistabelle unterscheidet unter anderem Modell, Verarbeitungsart, Kontextklasse und mehrere Tokenarten. Für unser Rechenbeispiel verwenden wir den dort am Quellenstand ausgewiesenen Standardtarif von GPT-6.1 Sol für kurzen Textkontext. Das ist keine Empfehlung für eine bestimmte Qualitätsstufe. Die folgenden Mengen sind frei gewählte Eingaben einer Rechnung. Es wurde keine entsprechende Anfrage abgerechnet.
| Klasse | Beispielmenge | USD je Million Token | Beitrag in USD |
|---|---|---|---|
| Gewöhnliche Eingabe | 600 | 2,00 | 0,001200 |
| Gelesener Cache | 400 | 0,10 | 0,000040 |
| Cache schreiben, 30 Minuten | 200 | 2,50 | 0,000500 |
| Cache schreiben, 12 Stunden | 0 | 5,00 | 0,000000 |
| Ausgabe | 300 | 10,00 | 0,003000 |
Die gesamte Eingabe umfasst hier 1.200 Token. Cache-Lesen und die beiden Schreibklassen sind darin enthalten. Für die gewöhnliche Eingabe bleiben deshalb 600 Token übrig. Die Dokumentation zum Prompt-Caching erklärt diese getrennte Zuordnung. Wer alle 1.200 Token zunächst als gewöhnliche Eingabe abrechnet und die Cacheklassen zusätzlich addiert, zählt Mengen doppelt. Ebenso wäre es falsch, jede nicht gelesene Eingabe ohne Prüfung als gewöhnliche Eingabe anzusetzen.
Die Summe unseres Beispiels beträgt 0,004740 USD. Werkzeugkosten, andere Modalitäten, Steuer, Währungsumrechnung und weitere Auftragsversuche sind darin nicht enthalten. Auch die Cachemengen werden nicht vorausgesagt: Sie müssen aus den tatsächlichen Nutzungsinformationen der jeweiligen Antwort kommen. Ein wiederholter Text garantiert für sich genommen keine bestimmte Cachequote. Für eine reale Abrechnung sind die aktuelle Schnittstelle, der konkrete Tarif und die tatsächlich ausgewiesenen Mengen maßgeblich.
Ein vollständiger Rechner mit nachvollziehbarer Einheit
Der folgende Kern erwartet Tokenzahlen als nichtnegative sichere Ganzzahlen. Die Sätze werden als ganzzahlige Zeichenketten in Millionstel USD je Million Token übergeben. Der Eingabesatz von 2,00 USD wird deshalb als 2000000 gespeichert. Diese Einheit muss ausdrücklich dokumentiert werden. Der Funktionsname oder der Variablenname allein schützt nicht davor, versehentlich Dollar, Cent und Millionstel Dollar zu vermischen.
const TOKEN_KEYS = ['cachedInputTokens', 'cacheWrite30mTokens', 'cacheWrite12hTokens', 'inputTokens', 'outputTokens'].sort();
const RATE_KEYS = ['cachedInputMicrosPerMillion', 'cacheWrite30mMicrosPerMillion', 'cacheWrite12hMicrosPerMillion', 'inputMicrosPerMillion', 'outputMicrosPerMillion'].sort();
function exactKeys(value, keys) {
  return value && typeof value === 'object' && !Array.isArray(value) &&
    Object.keys(value).sort().join(',') === keys.join(',');
}
export function quoteTextUsage(usage, rates) {
  if (!exactKeys(usage, TOKEN_KEYS) || !exactKeys(rates, RATE_KEYS)) throw new TypeError('Ungültige Felder.');
  for (const key of TOKEN_KEYS) {
    if (!Number.isSafeInteger(usage[key]) || usage[key] < 0 || usage[key] > 1_000_000_000) throw new TypeError('Ungültige Tokenzahl.');
  }
  const specialInput = usage.cachedInputTokens + usage.cacheWrite30mTokens + usage.cacheWrite12hTokens;
  if (specialInput > usage.inputTokens) throw new TypeError('Cache übersteigt Eingabe.');
  for (const key of RATE_KEYS) {
    if (typeof rates[key] !== 'string' || !/^(0|[1-9][0-9]{0,12})$/.test(rates[key]) || BigInt(rates[key]) > 1_000_000_000_000n) {
      throw new TypeError('Ungültiger Satz.');
    }
  }
  const ordinary = BigInt(usage.inputTokens - specialInput);
  const parts = [
    [ordinary, rates.inputMicrosPerMillion],
    [BigInt(usage.cachedInputTokens), rates.cachedInputMicrosPerMillion],
    [BigInt(usage.cacheWrite30mTokens), rates.cacheWrite30mMicrosPerMillion],
    [BigInt(usage.cacheWrite12hTokens), rates.cacheWrite12hMicrosPerMillion],
    [BigInt(usage.outputTokens), rates.outputMicrosPerMillion]
  ];
  const numerator = 1000n * parts.reduce((sum, [tokens, rate]) => sum + tokens * BigInt(rate), 0n);
  const nanoUsd = (numerator + 999_999n) / 1_000_000n;
  return {nanoUsd: nanoUsd.toString(), usd: (nanoUsd / 1_000_000_000n).toString() + '.' +
    (nanoUsd % 1_000_000_000n).toString().padStart(9, '0')};
}
Die Rechnung verwendet große Ganzzahlen und rundet die gesamte Summe einmal nach oben auf ein Milliardstel USD. Sie beansprucht damit keine identische Rundung mit einer Anbieterrechnung. Die Ausgabe bleibt eine Kalkulation der angegebenen Klassen. Die eigenen Obergrenzen begrenzen das Beispiel und sind keine Zusage über erlaubte API-Anfragen. Zusätzliche oder fehlende Felder werden zurückgewiesen, damit eine stillschweigend ignorierte neue Kostenklasse nicht wie vollständig verarbeitet aussieht.
Das folgende Ergebnis wurde mit dem gezeigten Modul erzeugt. Der vollständige Prüfdatensatz unterscheidet ausdrücklich zwischen verwendeten Annahmen und tatsächlich gemessenen Eigenschaften. Die hier dargestellte Berechnung beweist keine Modellqualität und keine Antwortgeschwindigkeit. Für die eigentliche Auswahl werden dazu separat die vorher beschriebenen Aufgaben und Zeitpunkte gemessen. Der Rechner ist ein begrenzter Baustein für eine solche Auswertung und kein automatischer Einkaufsempfehlungsdienst.
{
  "scope": "Illustrative token counts, not a measured model call or invoice. OpenAI GPT-6.1 Sol Standard short-context text rate snapshot checked2026-11-09. No additional services/taxes/currency conversion included.",
  "usage": {
    "inputTokens": 1200,
    "cachedInputTokens": 400,
    "cacheWrite30mTokens": 200,
    "cacheWrite12hTokens": 0,
    "outputTokens": 300
  },
  "rates": {
    "inputMicrosPerMillion": "2000000",
    "cachedInputMicrosPerMillion": "100000",
    "cacheWrite30mMicrosPerMillion": "2500000",
    "cacheWrite12hMicrosPerMillion": "5000000",
    "outputMicrosPerMillion": "10000000"
  },
  "partsUsd": {
    "ordinaryInput": "0.001200000",
    "cachedInput": "0.000040000",
    "write30m": "0.000500000",
    "write12h": "0.000000000",
    "output": "0.003000000"
  },
  "result": {
    "nanoUsd": "4740000",
    "usd": "0.004740000"
  },
  "ordinaryOnlyResult": {
    "nanoUsd": "5400000",
    "usd": "0.005400000"
  }
}
Was die 93 Prüfungen absichern
Der eigene Prüflauf kontrolliert unter anderem die ausgeführte Beispielsumme, vollständig gelesene Cacheeingaben, beide Schreiblaufzeiten und eine gewöhnliche Eingabe ohne Cache. Weitere Gegenfälle betreffen negative Werte, Nachkommastellen in Tokenzahlen, fehlende Eigenschaften und unzulässige Zeichenketten für Sätze. Die Summe der besonderen Eingabeklassen darf die gesamte Eingabe nicht übersteigen. Außerdem werden große Ganzzahlen und das einmalige Runden der Gesamtsumme geprüft.
Diese 93 erfolgreichen Bedingungen wurden ohne Modellaufruf ausgeführt. Sie belegen das Verhalten des Rechners gegenüber den geprüften Eingaben. Sie beweisen weder, dass eine Nutzungsantwort korrekt in das eigene Format übersetzt wurde, noch, dass sämtliche Bestandteile einer realen Anbieterrechnung enthalten sind. Für diese Integration braucht es zusätzliche Gegenproben mit echten Nutzungsfeldern und einen Abgleich gegen die tatsächliche Abrechnung. Die getrennte Beschreibung verhindert, dass ein korrekter Rechner eine unvollständige Datenerfassung verdeckt.
Eine Entscheidung ohne trügerischen Gesamtscore treffen
Sortieren Sie Varianten zunächst nach bestandenen Mindestanforderungen. Vergleichen Sie bei den verbleibenden Varianten Qualität, abgeschlossene Aufgabenkosten und Zeit getrennt. Eine Variante ist besonders interessant, wenn sie bei keinem relevanten Kriterium schlechter und bei mindestens einem besser ist. Häufig bleiben jedoch echte Zielkonflikte. Dann entscheidet der Nutzungskontext: Eine interaktive Hilfe und eine umfangreiche nächtliche Auswertung brauchen nicht dieselbe Gewichtung.
Schreiben Sie die Entscheidung als begrenzte Aussage: Diese Konfiguration erfüllt für diese Aufgabenmenge die definierten Anforderungen unter den beobachteten Bedingungen. Vermeiden Sie eine pauschale Rangfolge für alle Aufgaben. Halten Sie außerdem fest, wann eine andere Variante übernimmt. Eine Eskalation kann bei fehlenden Belegen oder einem nicht bestandenen fachlichen Test sinnvoll sein. Ein selbstsicher formulierter Modelltext ist dagegen kein verlässlicher Auslöser dafür, eine Prüfung wegzulassen.
Bei einer mehrstufigen Auswahl muss auch der Auswahlmechanismus selbst geprüft werden. Wenn einfache Fälle an eine günstigere Konfiguration gehen sollen, benötigt „einfach“ eine überprüfbare Definition. Eine falsche Weiterleitung kann den Vorteil der gesamten Strategie aufheben. Vergleichen Sie deshalb die vollständige Kette einschließlich Erkennung, weiterer Versuche und Abschlussprüfung. Eine isolierte Messung der günstigsten Stufe zeigt nur einen Teil des späteren Arbeitsablaufs.
Checkliste für einen belastbaren Vergleich
Für die praktische Zusammenarbeit hilft eine kurze Bewertungsskala. Sie sollte beschreiben, was eine Person mit dem Ergebnis tun kann. Verwenden Sie etwa vier fachliche Zustände: unbrauchbar, grundlegend neu zu bearbeiten, mit gezielter Korrektur nutzbar und entsprechend den Anforderungen unmittelbar nutzbar. Ergänzen Sie für jeden Zustand ein wirklich geprüftes Beispiel aus Ihrer eigenen Aufgabenmenge. Die Namen sind nur eine Ordnungshilfe. Sie ersetzen keine Beschreibung des konkreten Fehlers und dürfen Ausschlussbedingungen nicht aufheben.
| Stufe | Arbeitsfähigkeit des Ergebnisses | Zu dokumentieren |
|---|---|---|
| 0 | Für die beschriebene Aufgabe unbrauchbar | Fehlender Kern oder Ausschlussfehler |
| 1 | Grundlegende Neubearbeitung erforderlich | Welche wesentliche Arbeit bleibt offen? |
| 2 | Nach gezielter Korrektur nutzbar | Konkrete Änderung und ihr Aufwand |
| 3 | Entsprechend den Anforderungen unmittelbar nutzbar | Welche Prüfungen wurden tatsächlich bestanden? |
Diese Skala ist ein eigener Bewertungsvorschlag und kein anerkannter allgemeiner Modellstandard. Besonders bei mehreren Prüfern müssen die Grenzen gemeinsam geschärft werden. Lassen Sie zunächst dieselben Ergebnisse unabhängig bewerten und besprechen Sie Abweichungen. Wenn eine Person einen fehlenden Beleg als kleine Korrektur und eine andere als grundlegenden Fehler betrachtet, braucht die Anforderung eine klarere Definition. Ein Mittelwert der widersprüchlichen Urteile löst diesen fachlichen Unterschied nicht auf.
Blenden Sie bei einer Qualitätsprüfung nach Möglichkeit aus, welche Konfiguration eine Antwort erzeugt hat. Ein bekannter Produktname und eine erwartete Preisklasse können ein Urteil beeinflussen. Wechseln Sie außerdem die Reihenfolge vergleichbarer Antworten. Die fachliche Bewertung sollte sich auf die vorab definierten Merkmale beziehen. Bewahren Sie die ursprünglichen Einzelurteile auf, auch wenn anschließend eine gemeinsame Entscheidung entsteht. So bleibt erkennbar, ob eine Verbesserung eindeutig oder vor allem umstritten war.
Für die Nacharbeit erfassen Sie nicht nur eine Gesamtzeit, sondern auch die Art der Änderung. Ein korrigierter Satzbau, eine fehlende Primärquelle und ein neu geschriebener Algorithmus sind verschiedene Arbeitsleistungen. Eine einzige Kennzahl „bearbeitet“ würde sie vermischen. Notieren Sie außerdem, ob die Person anschließend das Ergebnis akzeptiert hat. Eine halbe Stunde Korrektur an einer weiterhin unbrauchbaren Ausgabe ist Aufwand ohne abgeschlossenen Erfolg. Gerade dieser Fall verändert die Wirtschaftlichkeitsrechnung erheblich.
Eine weitere Grenze betrifft geteilte Infrastruktur. Wenn mehrere Aufträge gleichzeitig dieselbe Warteschlange nutzen, kann die Laufzeit eines einzelnen Auftrags von den anderen abhängen. Vergleichen Sie deshalb nicht einen unbelasteten Einzelaufruf mit einer voll ausgelasteten Serie. Dokumentieren Sie Parallelität und Zeitpunkt. Falls Produktionsbedingungen zunächst unbekannt sind, trennen Sie einen kontrollierten technischen Vergleich von späteren Beobachtungen im echten Ablauf. Beide liefern nützliche Informationen, beantworten aber unterschiedliche Fragen.
Legen Sie vor der Änderung außerdem einen Rückweg fest. Bewahren Sie die bisherige Konfiguration mit ihrer Aufgabenmenge und den zugehörigen Ergebnissen auf. Definieren Sie, welche neu auftretenden Fehler eine Rückkehr oder eine zusätzliche menschliche Prüfung auslösen. Das braucht keine umfangreiche Verwaltungsstruktur. Eine eindeutige Version, eine verantwortliche Person und ein überprüfbarer Auslöser können für einen kleinen Ablauf genügen. Ohne solche Zuordnung lässt sich ein plötzlich schlechteres Ergebnis nur schwer einer Änderung zuordnen.
Die Entscheidung bleibt schließlich eine Entscheidung über den vollständigen Arbeitsablauf. Ein Rechner kann korrekt rechnen, während ein menschlicher Prüfer eine falsche Annahme übernimmt. Eine schnelle Antwort kann inhaltlich vollständig sein, während die anschließende Werkzeugaktion scheitert. Halten Sie deshalb den tatsächlich erreichten Abschluss fest. Eine erzeugte Nachricht ist nicht automatisch eine erledigte Aufgabe. Gerade diese saubere Grenze verhindert, dass günstigere oder schnellere Zwischenergebnisse mit einem wirtschaftlicheren Gesamtergebnis verwechselt werden.
- Aufgabe und akzeptables Endergebnis konkret beschreiben.
- Ausschlussfehler vor der Bewertung weicher Eigenschaften festlegen.
- Typische und kritische Aufgaben getrennt dokumentieren.
- Kontext, Modellkennung, Einstellungen und Werkzeugzugänge sichern.
- Erste nützliche Ausgabe und vollständigen Abschluss getrennt messen.
- Alle Versuche und erforderliche Nacharbeit berücksichtigen.
- Tarifstand, Einheiten und sämtliche verwendeten Kostenklassen prüfen.
- Cache-Lesen und Cache-Schreiben ohne doppelte Mengen behandeln.
- Automatische Bewertungen anhand fachlicher Urteile kontrollieren.
- Nach einer relevanten Änderung dieselben Prüfungen erneut ausführen.
Bewahren Sie auch bewusst verworfene Varianten auf. Eine spätere Preisänderung kann eine wirtschaftliche Entscheidung verschieben, ohne die fachliche Eignung zu verändern. Ein geändertes Modell oder ein neuer Kontextaufbau kann dagegen die Ergebnisse verändern, obwohl der Preis gleich bleibt. Beides verlangt eine erneute passende Prüfung. Kosten, Geschwindigkeit und Qualität lassen sich dann sinnvoll gegeneinander abwägen, wenn jede Zahl zu einer klaren Aufgabe und einem dokumentierten Nachweis gehört.